
React / 系统课时
实现数据列表与筛选
实现数据列表与筛选
本节完成一个可直接运行的数据列表页:组件先从本地 HTTP 资源请求数据,再处理加载与失败状态,最后把搜索、分类筛选和分页串成一条稳定的数据派生链路。
学习目标
- 使用
fetch与useEffect完成列表数据请求和状态处理 - 用搜索词与分类条件派生可见数据,而不是重复保存结果状态
- 在筛选条件变化时正确重置分页并验证边界情况
先把数据流拆清楚
列表页同时存在“服务端返回的原始数据”和“用户当前看到的数据”。原始数据请求成功后保持不变;搜索、分类与分页只是基于原始数组逐层派生。这样可以避免筛选结果、分页结果和原始数组之间互相覆盖。
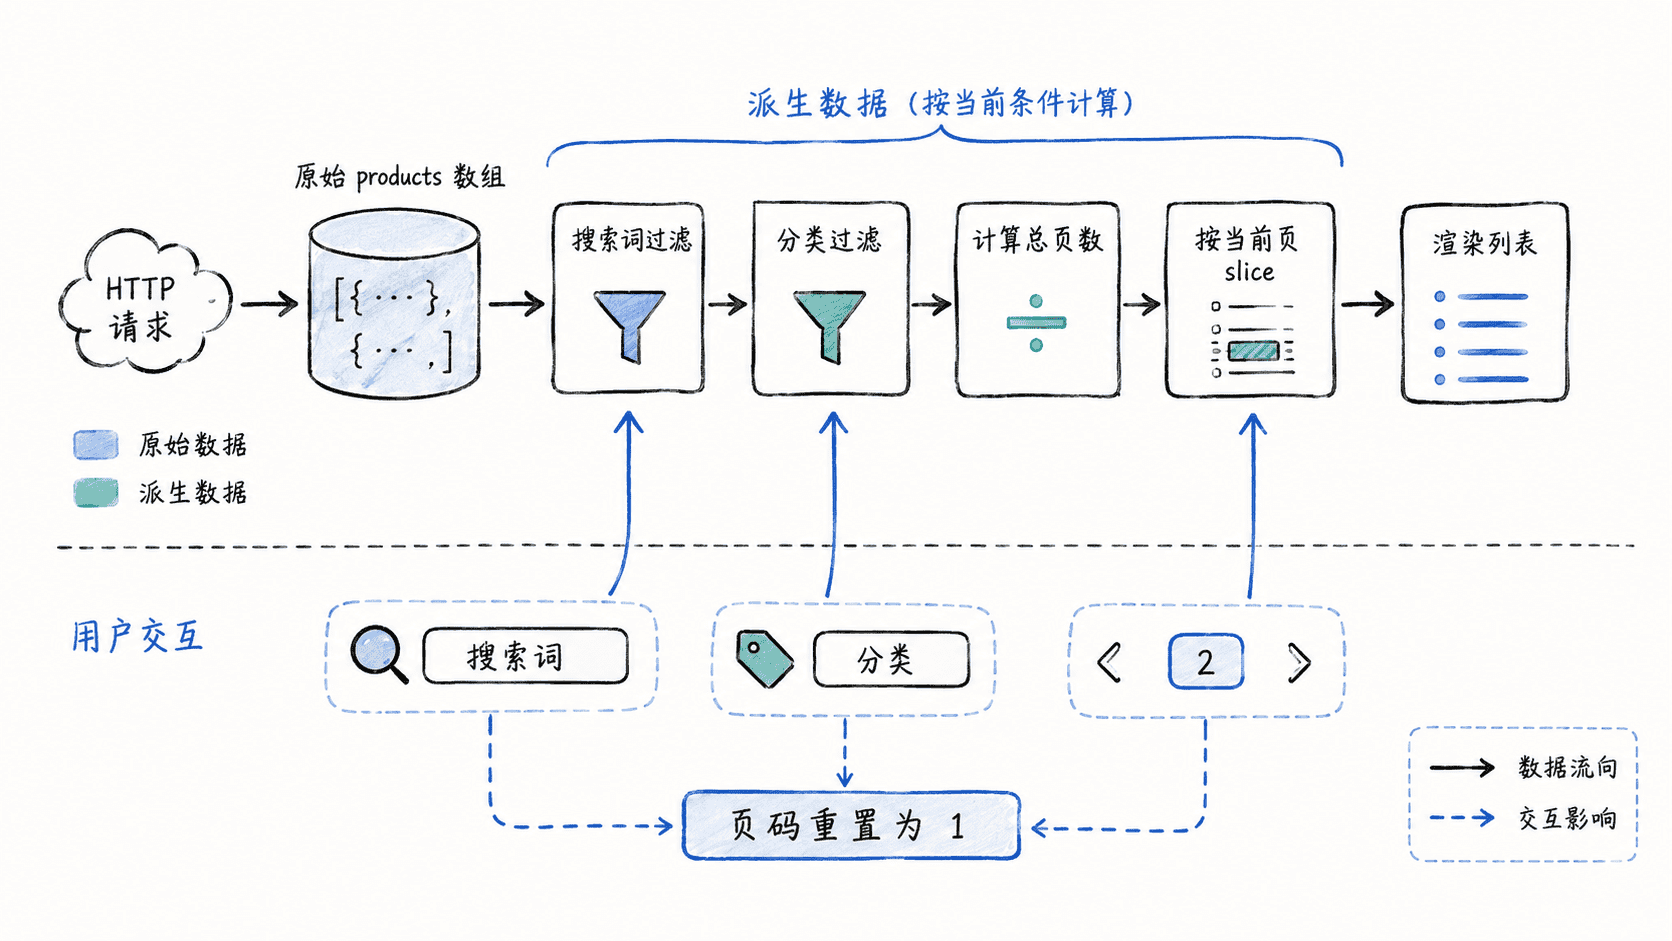
为了让示例不依赖第三方接口,在 Vite 项目的 public/products.json 放入固定测试数据。浏览器访问 /products.json 时会通过开发服务器发起真实 HTTP 请求。
[
  {"id":1,"name":"机械键盘","category":"外设","price":499},
  {"id":2,"name":"无线鼠标","category":"外设","price":199},
  {"id":3,"name":"27 寸显示器","category":"显示","price":1699},
  {"id":4,"name":"便携显示器","category":"显示","price":1299},
  {"id":5,"name":"USB-C 扩展坞","category":"配件","price":399},
  {"id":6,"name":"笔记本支架","category":"配件","price":159}
]
这份数据文件生效后,可直接在浏览器打开 /products.json 验证服务器是否能返回数组。
完成请求、筛选与分页
把下面代码保存为 src/main.jsx。示例使用每页 2 条数据,便于立即观察筛选后页数变化;AbortController 会在组件卸载时取消未完成请求。
import { StrictMode, useEffect, useMemo, useState } from "react";
import { createRoot } from "react-dom/client";

const PAGE_SIZE = 2;

function ProductList() {
  const [products, setProducts] = useState([]);
  const [status, setStatus] = useState("loading");
  const [query, setQuery] = useState("");
  const [category, setCategory] = useState("全部");
  const [page, setPage] = useState(1);

  useEffect(() => {
    const controller = new AbortController();

    async function loadProducts() {
      try {
        const response = await fetch("/products.json", {
          signal: controller.signal,
        });
        if (!response.ok) throw new Error(`HTTP ${response.status}`);
        setProducts(await response.json());
        setStatus("success");
      } catch (error) {
        if (error.name !== "AbortError") setStatus("error");
      }
    }

    loadProducts();
    return () => controller.abort();
  }, []);

  const categories = useMemo(
    () => ["全部", ...new Set(products.map((item) => item.category))],
    [products]
  );

  const filtered = useMemo(() => {
    const keyword = query.trim().toLowerCase();
    return products.filter((item) => {
      const matchesQuery = item.name.toLowerCase().includes(keyword);
      const matchesCategory =
        category === "全部" || item.category === category;
      return matchesQuery && matchesCategory;
    });
  }, [products, query, category]);

  const pageCount = Math.max(1, Math.ceil(filtered.length / PAGE_SIZE));
  const visible = filtered.slice((page - 1) * PAGE_SIZE, page * PAGE_SIZE);

  function updateQuery(value) {
    setQuery(value);
    setPage(1);
  }

  function updateCategory(value) {
    setCategory(value);
    setPage(1);
  }

  if (status === "loading") return <p>正在加载...</p>;
  if (status === "error") return <p>加载失败,请检查数据文件。</p>;

  return (
    <main style={{ maxWidth: 720, margin: "40px auto", fontFamily: "sans-serif" }}>
      <h1>商品列表</h1>
      <input
        value={query}
        onChange={(event) => updateQuery(event.target.value)}
        placeholder="搜索商品"
      />
      <select
        value={category}
        onChange={(event) => updateCategory(event.target.value)}
        style={{ marginLeft: 8 }}
      >
        {categories.map((item) => (
          <option key={item} value={item}>{item}</option>
        ))}
      </select>

      <ul>
        {visible.map((item) => (
          <li key={item.id}>
            {item.name} · {item.category} · ¥{item.price}
          </li>
        ))}
      </ul>

      {filtered.length === 0 && <p>没有匹配结果。</p>}

      <button disabled={page === 1} onClick={() => setPage((p) => p - 1)}>
        上一页
      </button>
      <span style={{ margin: "0 12px" }}>{page} / {pageCount}</span>
      <button
        disabled={page === pageCount}
        onClick={() => setPage((p) => p + 1)}
      >
        下一页
      </button>
    </main>
  );
}

createRoot(document.getElementById("root")).render(
  <StrictMode>
    <ProductList />
  </StrictMode>
);
预期结果
初始状态:共 6 条商品,每页显示 2 条,页码为 1 / 3
搜索“显示器”:显示 2 条结果,页码重置为 1 / 1
选择“配件”:显示 2 条配件商品
搜索不存在的关键字:显示“没有匹配结果。”
为什么不把筛选结果再存一份 state
filtered 和 visible 都能由 products、query、category、page 计算得到,因此不需要再用 useState 保存。否则一次筛选动作可能要同步修改多份状态,任何一步遗漏都会产生“条件已经变了,但列表还是旧数据”的问题。
useMemo 在这里表达的是“派生数据”。对于只有几条记录的小列表,它不是性能必需品;真正重要的是数据只保留一个事实来源。数据量扩大后,再根据测量结果决定是否需要服务端搜索、服务端分页或缓存。
验证请求失败与分页边界
启动开发服务器后再测试页面:
npm run dev预期输出
Local: http://localhost:<PORT>/实际端口可能不同。正常加载后,依次检查搜索、分类、上一页和下一页;再临时把请求地址改成 /missing.json,页面应进入“加载失败”状态,而不是无限停留在加载中。
这个列表的关键不是控件数量,而是状态关系:请求结果是源数据,搜索与分类是过滤条件,分页只作用于过滤后的结果。保持这条顺序,后续把本地 JSON 换成真实 API 时,交互逻辑仍然容易维护。