
服务注册与分布式协调 / 系统课时
监控注册发现与路由链路
监控注册发现与路由链路
注册成功并不代表调用一定成功:资源可能已进入 Nacos,却在发现过滤、Router 选路、网关转发或 MCP Server 执行阶段失败。本节把这些环节拆成一条可观测证据链,并给出日志关联和故障定位方法,让“调用失败”能快速落到具体层级。
学习目标
- 为注册、发现、Router、网关和 MCP Server 选择关键观测信号
- 用资源标识与请求关联 ID 串起跨组件日志
- 根据指标和日志组合快速判断故障发生在哪一层
把一次运行时调用拆成五个观测面
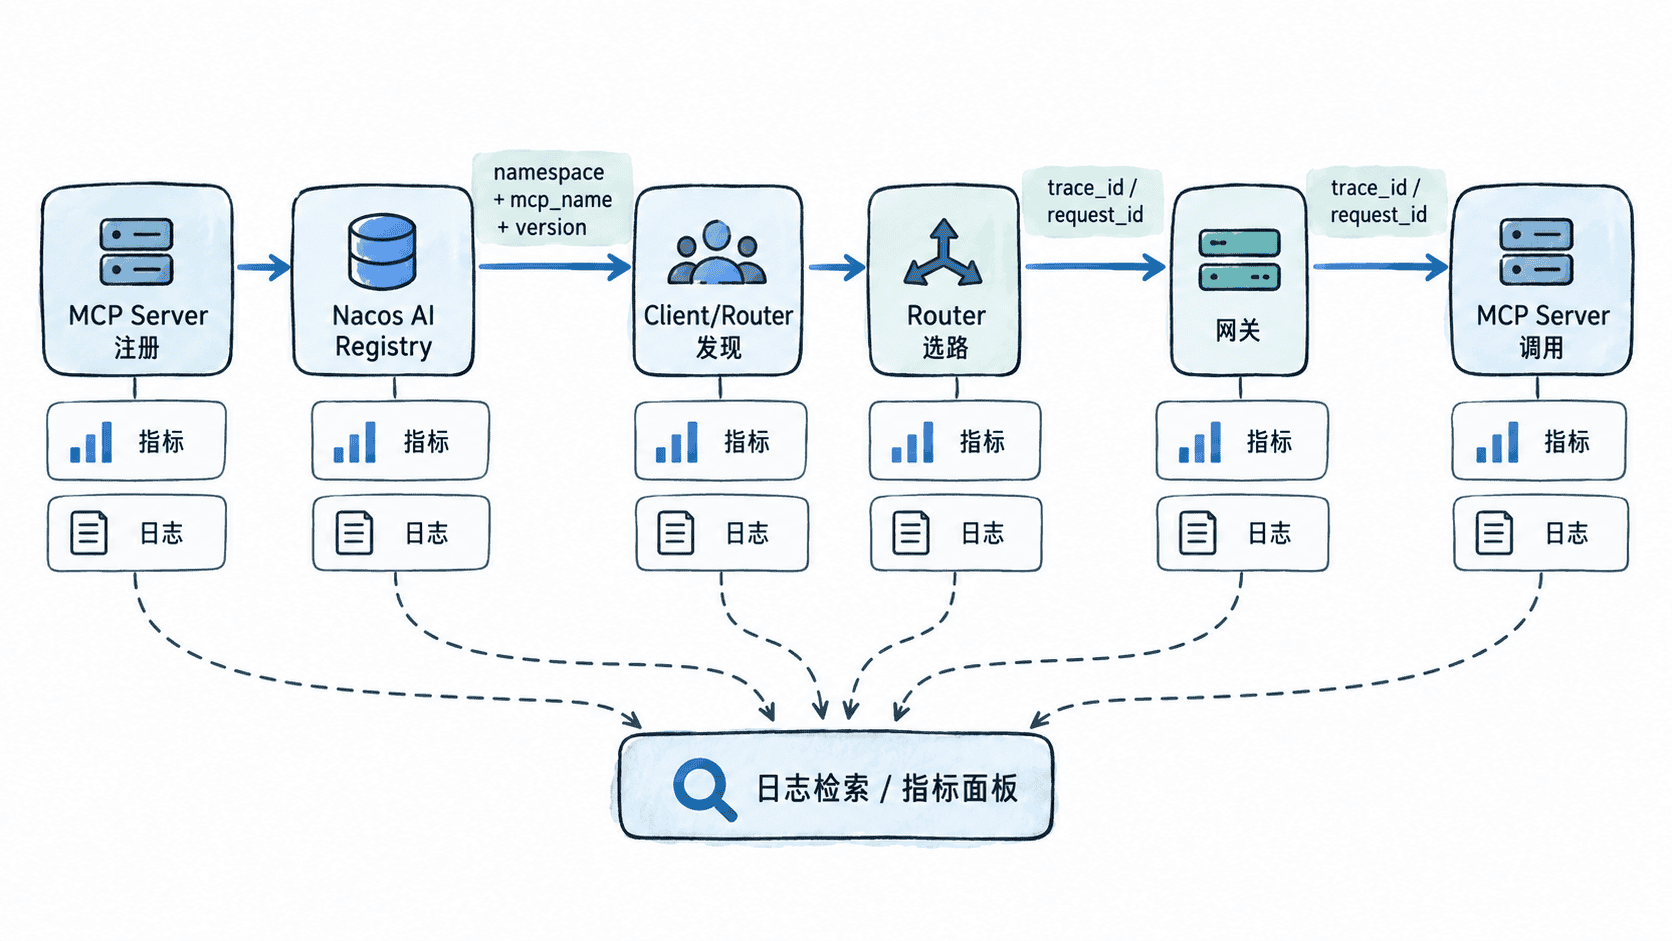
监控不要只盯 Nacos 节点健康。完整链路至少包含五个观测面:MCP Server 注册结果、Registry 中的资源与实例状态、调用方的发现结果、Router 的候选与选路、网关和后端 MCP Server 的实际响应。每一层都要同时保留“数量/成功率”指标和可下钻的日志。
| 环节 | 优先观测 | 典型异常信号 |
|---|---|---|
| 注册 | 注册尝试、成功率、资源版本 | 注册失败或重复抖动 |
| Registry/发现 | 可用实例数、发现结果数 | 实例存在但发现为空 |
| Router | 路由成功率、候选数、选中目标、延迟 | 无候选、选错版本、超时 |
| 网关 | 上游目标、状态码、重试、连接耗时 | 502/503、连接失败 |
| MCP Server | 请求量、工具错误率、执行时延 | 工具异常或处理超时 |
用两类关联键串日志
注册与发现不是每次业务调用都会触发,所以不要强求 Nacos 内部日志天然带着业务 trace_id。更实用的做法是使用两类键:用 namespace + mcp_name + version 关联“资源是否存在、发现到了什么”,再从 Router 开始把 trace_id 或 request_id 透传到网关和 MCP Server。
Router 的一条关键日志应同时包含资源键和请求关联 ID。这样排查时先用 trace_id 找到本次调用选中了哪个资源,再用资源键回查 Registry 与发现阶段,证据链才能闭合。
做一次证据链自检
下面脚本用于检查日志采集是否真的能串起来。它假设 Nacos 侧能用资源键检索,Router 日志同时包含资源键和 trace_id,网关与 MCP Server 至少包含同一个 trace_id。<PATH>、<ID> 和资源键要替换成一次真实请求的值。
#!/usr/bin/env bash
set -euo pipefail

LOG_DIR="<PATH>"
RESOURCE_KEY="namespace=<ID> mcp_name=<ID> version=<ID>"
TRACE_ID="<ID>"

grep -Fq "$RESOURCE_KEY" "$LOG_DIR/nacos.log" \
  && echo "OK registry-resource" \
  || { echo "MISS registry-resource"; exit 1; }

grep -F "$TRACE_ID" "$LOG_DIR/router.log" | grep -Fq "$RESOURCE_KEY" \
  && echo "OK router-route" \
  || { echo "MISS router-route"; exit 1; }

for file in gateway.log mcp-server.log; do
  if grep -Fq "$TRACE_ID" "$LOG_DIR/$file"; then
    echo "OK $file"
  else
    echo "MISS $file"
    exit 1
  fi
done

echo "evidence-chain-complete trace_id=$TRACE_ID"
预期输出
OK registry-resource
OK router-route
OK gateway.log
OK mcp-server.log
evidence-chain-complete trace_id=<ID>
如果脚本在 Router 之前失败,优先检查注册、命名空间、版本和发现过滤;如果 Router 已有目标但网关缺少同一 trace_id,检查转发与请求头透传;如果网关已有成功转发而 MCP Server 报错,就不要继续在 Registry 层反复排查。
用指标组合定位而不是看单点
告警最好反映链路语义。注册成功率下降但已注册实例数稳定,通常先看发布端或认证;实例数正常但发现为空比例升高,应检查命名空间、版本、标签过滤或客户端缓存;Router 已选中目标而网关 5xx 升高,应转向网络、连接池和上游健康;网关响应正常但工具错误率升高,则重点在 MCP Server 自身。
为了减少误报,可以把告警设置为“现象 + 影响”组合,例如发现为空比例升高并伴随 Router 无候选增长,或网关 5xx 上升并伴随后端连接失败。这样监控不只是告诉你某个数字变坏,而是直接指出最可能断在哪一段链路。
最终的生产级观测目标很明确:任意一次失败调用,都能先用请求关联 ID 找到 Router、网关和后端,再用资源键回溯到 Registry 与发现结果;如果这两条路径都能闭合,注册发现与路由问题就不再依赖人工猜测。