
MySQL / 系统课时
理解 ALGORITHM=COPY
理解 ALGORITHM=COPY
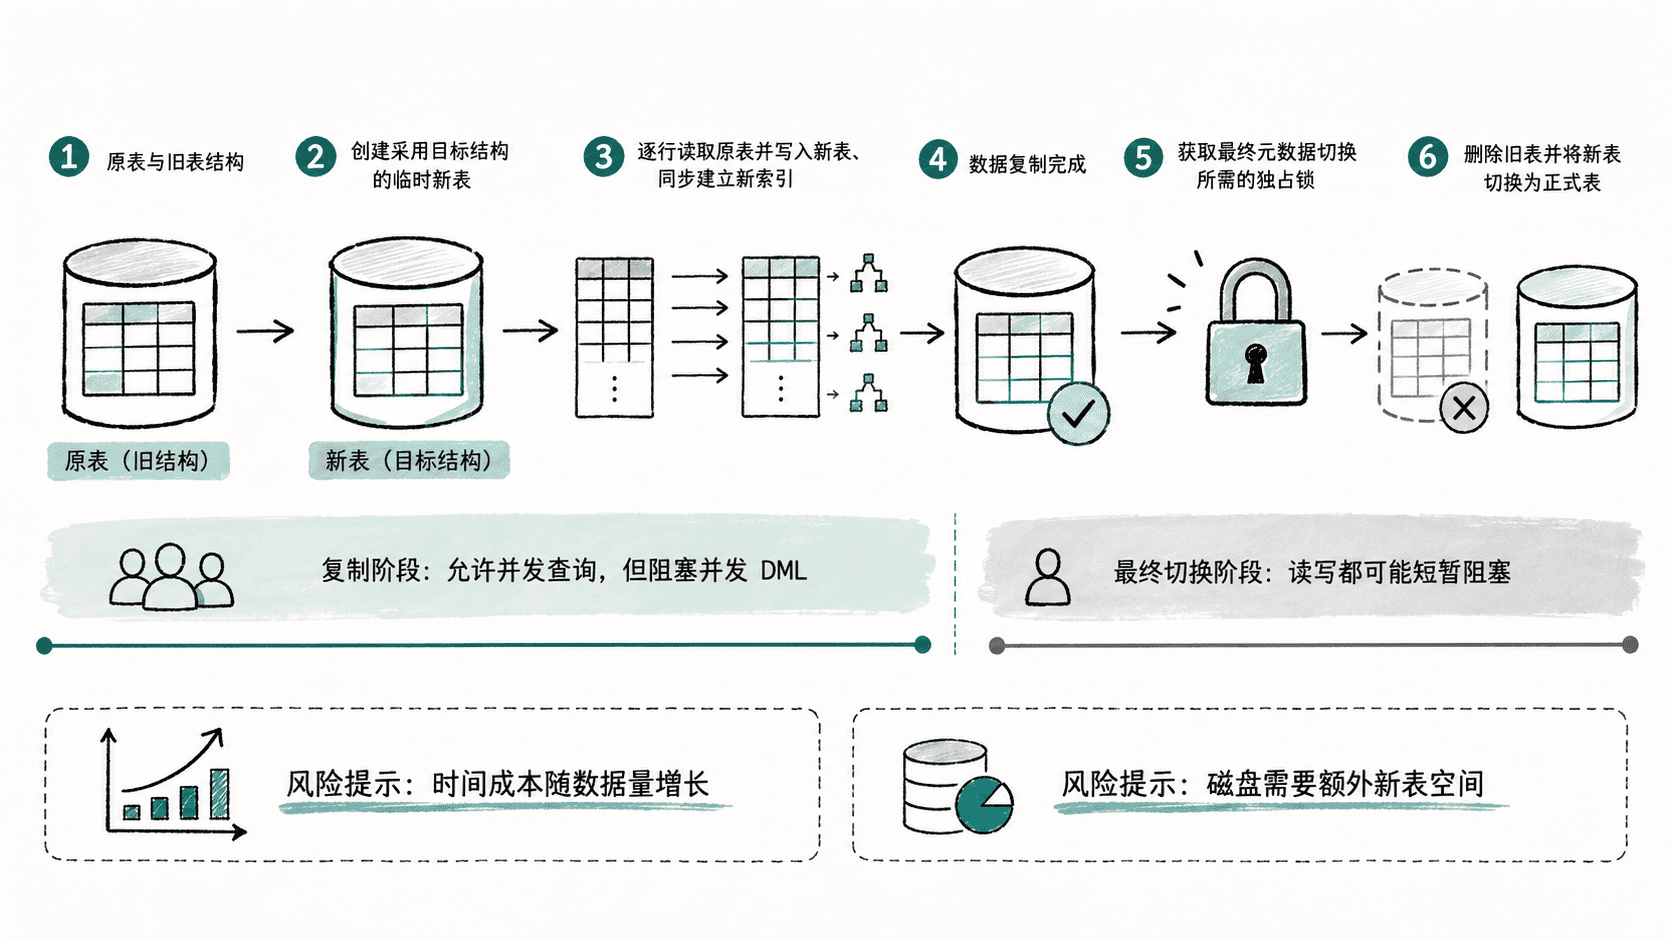
ALGORITHM=COPY 的关键不是“执行时间更长”,而是 MySQL 会建立一份目标结构的新表,把原表数据复制过去,再完成元数据切换。理解这条路径后,你才能在变更前准确评估阻塞窗口、磁盘空间和大表风险。
学习目标
- 说清 COPY 从建表、复制到切换的执行过程
- 判断 COPY 对并发读写、执行时间和磁盘空间的影响
- 用显式
ALGORITHM=COPY验证必须重建表的结构变更
COPY 到底复制了什么
对 InnoDB 表执行 COPY 算法时,MySQL 不是在原表页面上直接改结构,而是先按新的表定义准备一份表副本,再把原表记录复制到新结构中,并为新表建立所需索引。复制完成后,服务器切换表定义,让新表接管原表名称。
因此,表越大、索引越多,COPY 的成本越接近一次完整的数据重写。它不只消耗 CPU,还会持续产生读 I/O、写 I/O,并占用一份接近完整新表的数据与索引空间。
并发影响不是“全程锁死”
COPY 会阻止并发 DML,也就是 INSERT、UPDATE、DELETE 等写入不能在复制期间正常推进;普通查询在大部分复制阶段仍可读取原表。到了最终清理旧表结构和切换定义时,MySQL 还需要取得独占元数据锁,此时当前读事务可能让 DDL 等待,新读写也可能被短暂阻塞。
这意味着 COPY 的风险要分成两个窗口看:长时间的写阻塞和结束时的元数据切换阻塞。在线业务即使读多写少,也不能把 COPY 理解为普通的“在线 DDL”。
用一个必须 COPY 的变更验证
改变列数据类型是典型的 COPY 场景。下面创建一个小表,把 INT 改为 BIGINT,并显式要求 ALGORITHM=COPY。LOCK=SHARED 允许并发查询,但会阻止写入。
DROP TABLE IF EXISTS ddl_copy_demo;

CREATE TABLE ddl_copy_demo (
    id BIGINT PRIMARY KEY,
    score INT NOT NULL
) ENGINE=InnoDB;

INSERT INTO ddl_copy_demo VALUES
    (1, 10),
    (2, 20),
    (3, 30);

ALTER TABLE ddl_copy_demo
    MODIFY COLUMN score BIGINT NOT NULL,
    ALGORITHM=COPY,
    LOCK=SHARED;

SELECT COLUMN_TYPE
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = DATABASE()
  AND TABLE_NAME = 'ddl_copy_demo'
  AND COLUMN_NAME = 'score';

SELECT COUNT(*) AS row_count FROM ddl_copy_demo;
预期结果
+-------------+
| COLUMN_TYPE |
+-------------+
| bigint      |
+-------------+

+-----------+
| row_count |
+-----------+
|         3 |
+-----------+
示例说明的是算法与结果,不代表生产表的耗时。真实 COPY 的执行时间取决于数据量、索引数量、存储性能和并发负载,不能用测试环境小表耗时直接推算线上窗口。
上线前重点评估三类成本
首先看时间。COPY 必须遍历并重写数据,大表通常比只改元数据或原地重建更慢,而且复制期间写入受限。
其次看空间。变更期间需要容纳新表的数据和索引;若磁盘余量只够当前表存在,就不应直接执行。共享表空间还要额外注意空间回收行为,不能简单假设变更完成后空间立即归还操作系统。
最后看锁等待。DDL 开始和结束都可能受元数据锁影响。一个长事务即使只是读取目标表,也可能拖住最终切换。因此,评估 COPY 时必须把“复制多久”和“何时能拿到元数据锁”分开观察。
当结构变更只能使用 COPY 时,应把它当作一次受控的数据重建:先确认容量和并发窗口,再执行和监控,而不是只看到 ALTER TABLE 语句能运行就认为风险可接受。