
MySQL / 系统课时
处理复制延迟与副本异常
处理复制延迟与副本异常
在线 DDL 在主库执行顺利,并不代表副本一定能平稳跟上。本篇建立一条可操作的排查路径:先确认延迟发生在接收还是回放,再结合 SQL 线程状态、错误与磁盘压力,决定继续观察、暂停后续发布、限流,还是终止正在执行的变更。
学习目标
- 用副本状态区分 I/O 接收问题、SQL 回放阻塞与单纯延迟积压
- 结合执行线程、错误信息和容量指标判断 DDL 是否正在拖慢复制
- 按风险阈值选择暂停发布、业务限流或终止变更,并验证副本恢复
先确认延迟卡在哪一段
先在每个副本上查看复制状态。不要只盯 Seconds_Behind_Source:它可能在复制线程停止时为 NULL,也不能单独解释延迟根因。更有价值的是把接收线程、回放线程、最后错误和延迟放在一起看。
SHOW REPLICA STATUS\G预期输出
Replica_IO_Running: Yes
Replica_SQL_Running: Yes
Seconds_Behind_Source: <VALUE>
Last_IO_Error:
Last_SQL_Error:
<VALUE> 会随负载变化。若 Replica_IO_Running=No,先处理网络、认证或源库连接;若 I/O 正常但 Replica_SQL_Running=No,优先检查 Last_SQL_Error。两者都为 Yes 且延迟持续上升,才进入“回放能力不足或 DDL 占用执行资源”的分支。
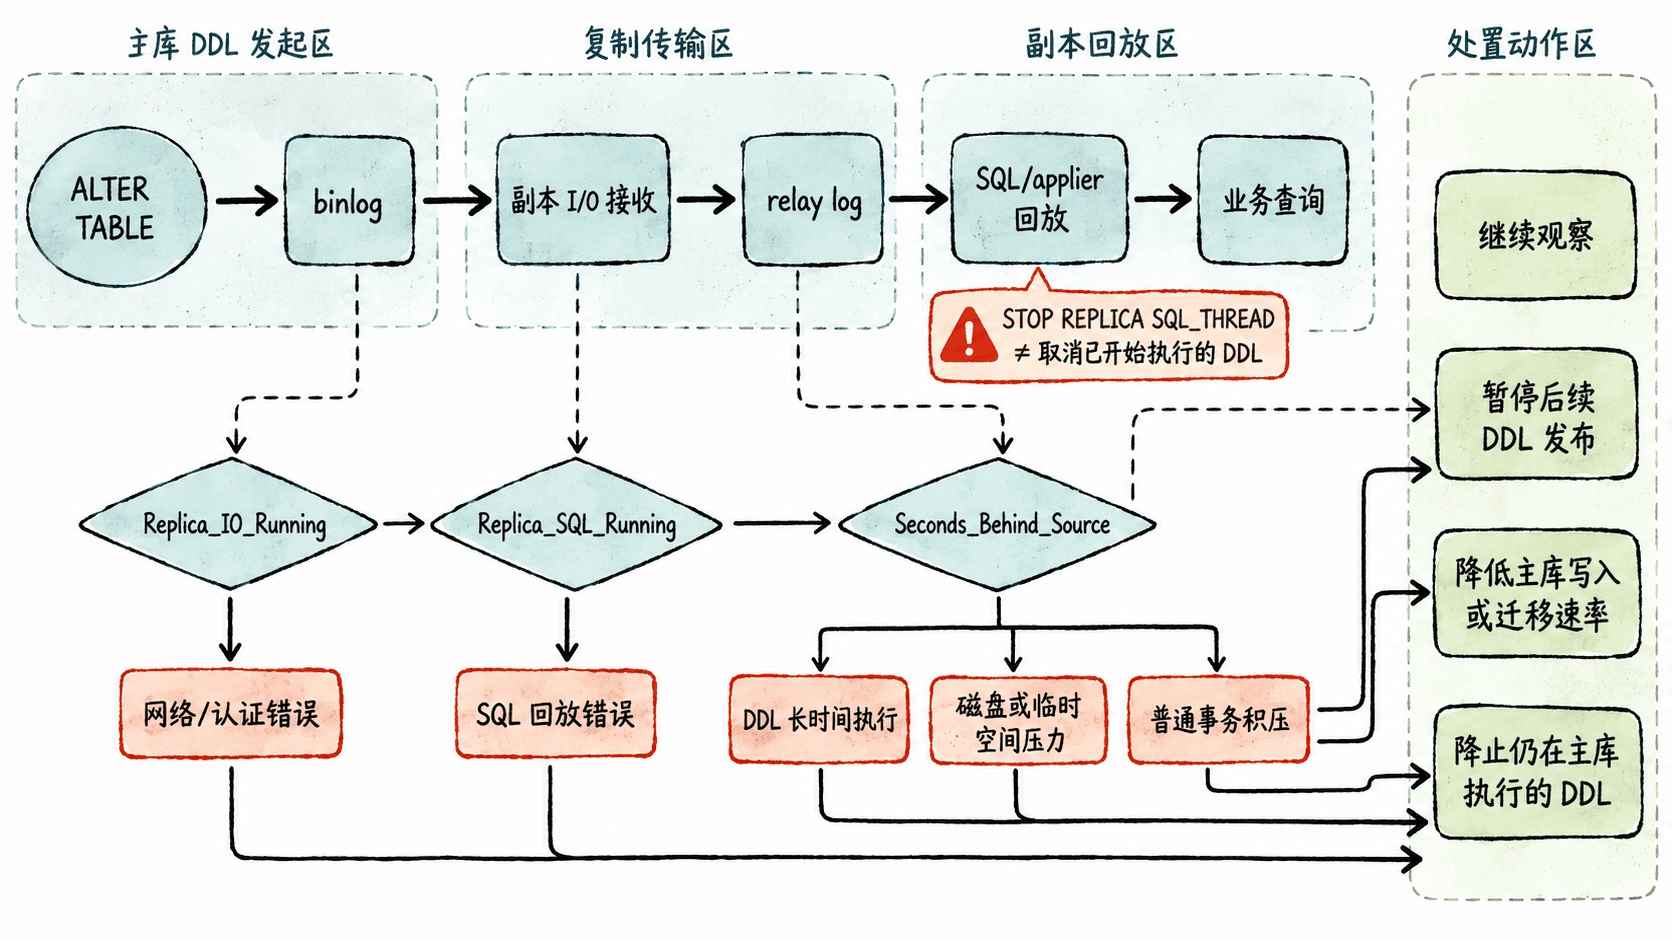
确认是否是 DDL 占住回放
并行复制并不能保证 DDL 与普通事务完全互不影响。表结构变更通常会形成同步点,还可能在副本上重新执行表重建、索引构建或元数据切换,因此需要查看 applier worker 是否仍在工作以及是否有明确错误。
SELECT
  CHANNEL_NAME,
  WORKER_ID,
  SERVICE_STATE,
  LAST_ERROR_NUMBER,
  LAST_ERROR_MESSAGE
FROM performance_schema.replication_applier_status_by_worker
ORDER BY CHANNEL_NAME, WORKER_ID;
预期输出
CHANNEL_NAME  WORKER_ID  SERVICE_STATE  LAST_ERROR_NUMBER  LAST_ERROR_MESSAGE
<VALUE>       <ID>       ON             0
若出现非零错误号,先按错误修复复制,不要继续追加 DDL。若 worker 状态正常但延迟增长,再在副本上查看当前线程,确认是否存在持续时间很长的 ALTER TABLE、等待元数据锁或其他长事务。
SHOW FULL PROCESSLIST;预期输出
Id    User      Time     State              Info
<ID>  <VALUE>   <VALUE>  <VALUE>            ALTER TABLE <VALUE>
实际线程名、状态和耗时会不同。看到 DDL 长时间运行并不等于异常,关键要结合延迟趋势、磁盘空间和业务延迟判断它是否已经超过发布阈值。
把容量压力纳入判断
表重建型 DDL 会同时消耗数据文件空间、临时空间、I/O 和 redo 能力。副本磁盘逼近高水位时,即使复制线程仍为 Yes,继续等待也可能把“延迟问题”升级为“磁盘耗尽或实例不可用”。
在有宿主机权限的自建环境中,可以只读检查数据盘或临时目录剩余空间:
df -h <PATH>预期输出
Filesystem  Size  Used  Avail  Use%  Mounted on
<VALUE>     <VALUE> <VALUE> <VALUE> <VALUE> <PATH>
<PATH> 应替换为实际数据盘或临时目录。托管数据库没有文件系统权限时,改用云平台的磁盘使用率、IOPS、吞吐和临时空间指标。这里关注的是趋势和安全余量,不要把某个固定百分比机械当成所有实例的统一阈值。
决定暂停、限流还是终止
处置动作应按“是否还能安全完成”来选,而不是看到延迟就立即停止复制。
- 继续观察:延迟稳定或开始回落,磁盘与 I/O 有余量,业务延迟没有恶化。
- 暂停后续发布:当前 DDL 已进入副本回放,但延迟在扩大。先不要向其他分片、租户或表继续发起相同变更。
- 限流:主库仍有高写入压力,DDL 需要复制大量并发变更日志,或副本回放已经接近容量上限。优先降低业务写入峰值、迁移批次或发布并发。
- 终止变更:DDL 仍在主库执行,延迟和容量风险已经越过变更窗口的止损线,且继续运行的风险高于回滚成本。此时才考虑
KILL QUERY <ID>,随后必须转入回滚监控。
如果只是想让副本暂时停止继续回放后续事件,可以执行:
STOP REPLICA SQL_THREAD;预期输出
Query OK, 0 rows affected这会人为增加复制延迟,并且不应被理解为可靠地取消一个已经开始执行的 DDL。恢复回放时执行:
START REPLICA SQL_THREAD;预期输出
Query OK, 0 rows affected验证副本是否真正恢复
处置后再次采集 SHOW REPLICA STATUS\G,至少连续观察一个业务高峰周期内的趋势。恢复不是“线程变成 Yes”这么简单,而应同时满足:错误为空、延迟不再持续上升、磁盘与 I/O 回到安全区间,并且业务读取没有出现新的锁等待或超时。
若主库 DDL 已提交并写入 binlog,而某个副本因中断 DDL 进入不可恢复的复制错误,不要反复跳过事件来“追平”。应先确认副本结构与主库是否一致;结构无法证明一致时,重建副本通常比带着未知结构差异继续服务更安全。