
MySQL / 系统课时
诊断 CPU、IO 与磁盘突增
诊断 CPU、IO 与磁盘突增
在线 DDL 不等于“没有资源成本”。增加索引、重建表或应用变更日志时,都可能显著消耗 CPU、磁盘带宽和临时空间。本篇建立一条可重复的诊断路径:先确认异常是否与 DDL 同时发生,再用系统与 MySQL 指标区分计算、读写、临时文件和刷盘压力,最后决定限速、取消还是继续。
学习目标
- 用系统指标区分 CPU 饱和、存储延迟与磁盘空间压力
- 结合 MySQL 文件 IO 和 DDL 状态判断资源消耗来源
- 在不扩大故障的前提下选择继续、降载或取消变更
先把异常与目标实例对齐
先确认当前是否存在目标 DDL,以及它已经运行多久。不要只凭“发布后变慢”就认定 DDL 是唯一原因。多实例主机尤其要先把 MySQL 实例映射到对应的 OS 进程,避免监控错实例。
SELECT
    @@port AS port,
    @@datadir AS datadir,
    @@pid_file AS pid_file;

SELECT
    PROCESSLIST_ID,
    PROCESSLIST_TIME,
    PROCESSLIST_STATE,
    PROCESSLIST_INFO
FROM performance_schema.threads
WHERE PROCESSLIST_INFO IS NOT NULL
  AND PROCESSLIST_INFO LIKE 'ALTER TABLE%';
预期结果:
+------+--------------------+----------------------+
| port | datadir            | pid_file             |
+------+--------------------+----------------------+
| <PORT> | <PATH>/mysql/     | <PATH>/mysql/<ID>.pid |
+------+--------------------+----------------------+

+----------------+------------------+-------------------+--------------------------------------+
| PROCESSLIST_ID | PROCESSLIST_TIME | PROCESSLIST_STATE | PROCESSLIST_INFO                     |
+----------------+------------------+-------------------+--------------------------------------+
| <ID>           | <VALUE>          | <STATE>           | ALTER TABLE app.orders ADD INDEX ... |
+----------------+------------------+-------------------+--------------------------------------+
实际路径、端口、进程 ID 和状态会不同。随后从这套实例自己的 @@pid_file 读取 PID,再确认进程命令行;不要使用 pidof mysqld | awk '{print $1}' 随意选第一个进程,因为多实例主机上它可能属于另一套 MySQL。
pid_file="<PATH>/mysql/<ID>.pid"
pid="$(cat "$pid_file")"
ps -p "$pid" -o pid=,args=
pidstat -p "$pid" 1 3
iostat -x 1 3
df -h "<PATH>/mysql"
预期输出:
<VALUE> mysqld --defaults-file=<PATH>/my.cnf
<VALUE> <VALUE> <VALUE> mysqld
Device  r/s  w/s  rkB/s  wkB/s  await  %util
<DEV>   <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE>
Filesystem  Size  Used  Avail  Use%  Mounted on
<DEV>       <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <PATH>
这样 CPU、IO 和空间采样都明确绑定到目标实例。若没有目标 DDL,会返回空结果;此时应把范围扩展到批处理、备份、全表查询、实例迁移或宿主机竞争,而不是继续围绕表结构变更推断。
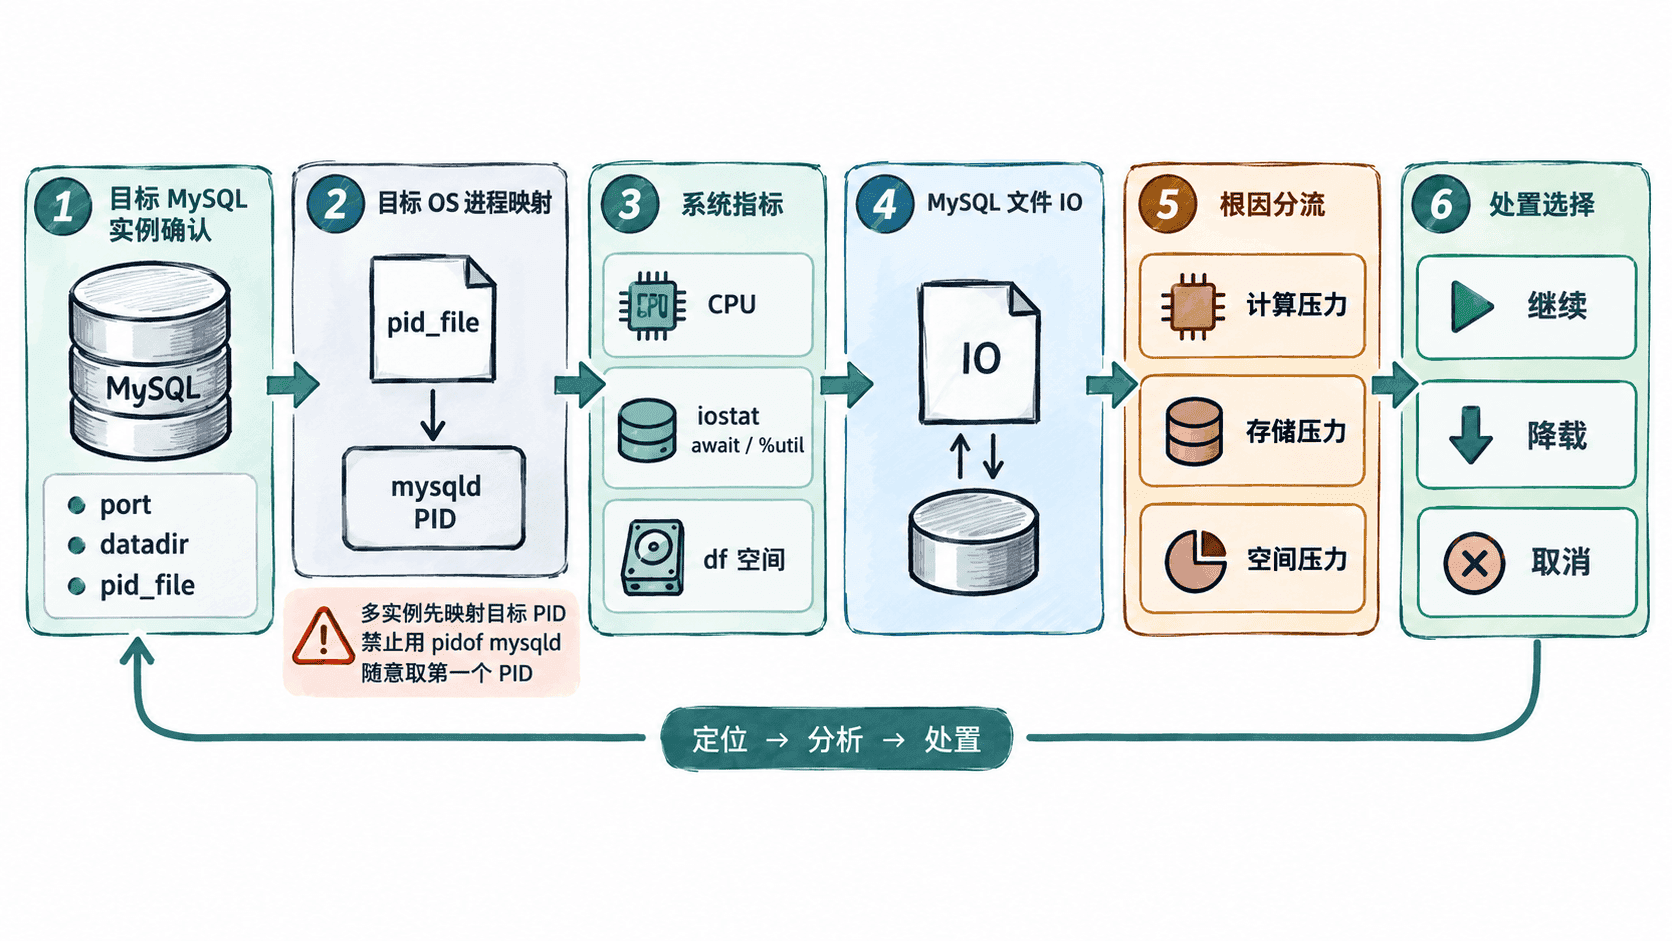
用系统指标区分 CPU、IO 与空间
数据库主机应连续采样,而不是只看某一秒的峰值。CPU 长时间接近可用核心上限且 IO 延迟正常,优先怀疑排序、索引键处理和并行计算;await、%util 与读写吞吐同步升高,说明瓶颈更接近存储;可用空间持续下降则要继续找新表副本、临时文件、日志或其他增长源。
用 MySQL 文件 IO 确认读写热点
系统指标只能告诉你“磁盘忙”,还需要确认 MySQL 正在对哪些文件产生大量读写。Performance Schema 的文件汇总适合做现场快照:
SELECT
    FILE_NAME,
    COUNT_READ,
    SUM_NUMBER_OF_BYTES_READ,
    COUNT_WRITE,
    SUM_NUMBER_OF_BYTES_WRITE
FROM performance_schema.file_summary_by_instance
ORDER BY
    SUM_NUMBER_OF_BYTES_READ + SUM_NUMBER_OF_BYTES_WRITE DESC
LIMIT 10;
预期结果:
+-------------------------+------------+----------------------------+-------------+-----------------------------+
| FILE_NAME               | COUNT_READ | SUM_NUMBER_OF_BYTES_READ  | COUNT_WRITE | SUM_NUMBER_OF_BYTES_WRITE  |
+-------------------------+------------+----------------------------+-------------+-----------------------------+
| <PATH>                  | <VALUE>    | <VALUE>                    | <VALUE>     | <VALUE>                     |
| <PATH>                  | <VALUE>    | <VALUE>                    | <VALUE>     | <VALUE>                     |
+-------------------------+------------+----------------------------+-------------+-----------------------------+
这些计数是累计值,单次查询只能看到“谁累计最多”。更可靠的方法是在 DDL 前后各采一次,比较增量:数据文件读写快速增长常见于表扫描或重建;新索引相关文件写入增加说明索引构建正在落盘;redo、binlog 或其他日志文件增长则要结合并发 DML 与持久化策略判断,不能把全部写入都归因于 DDL。
根据现象判断资源来源
增加二级索引时,服务器需要读取基表记录、提取索引键并构建新的 B+Tree,CPU 与读写都可能上升。需要重建表的变更成本更高,因为除了读取旧数据,还要写出新表副本,并在在线阶段处理并发修改带来的变更记录。
磁盘空间下降不能只看最终表大小。重建过程中可能同时存在旧表、新表、DDL 临时文件以及正常的 redo、binlog;即使 DDL 失败或被取消,也可能经历清理阶段,空间与 IO 不一定立即回落。
选择继续、降载还是取消
资源仍有明显余量、业务延迟稳定,而且 DDL 已进入可预期的持续处理阶段时,可以继续观察,不要因为短时峰值频繁中断。若 CPU 或 IO 已挤压前台请求,可先减少同机批任务、降低应用写入洪峰,或暂停同时进行的其他维护操作。
当数据盘接近容量红线、IO 延迟持续导致业务超时,或者宿主机 CPU 已长期饱和时,应优先保护业务。取消 DDL 可以停止继续扩张,但要预期清理、回滚或删除临时对象本身仍会消耗一段时间,不能把 KILL QUERY 当成瞬时恢复按钮。
取消前先记录会话 ID,然后执行:
KILL QUERY <DDL_ID>;预期结果:
Query OK, 0 rows affected (<TIME> sec)随后继续采样 pidstat、iostat、磁盘可用空间和 MySQL 文件 IO 增量。只有资源曲线开始回落、业务延迟恢复,并确认没有新的自动重试 DDL,才能认为止损完成。
用同一组指标完成闭环
故障结束后应保留三组数据:DDL 开始前的基线、异常期间的峰值、处置后的恢复值。下次变更前据此估算实例余量和磁盘空间,而不是继续依赖“在线 DDL 应该影响不大”的经验判断。
如果 CPU 高但存储健康,下次重点评估索引构建和并发计算的资源窗口;如果 IO 延迟是主因,应把表重建规模、设备吞吐和前台负载一起纳入发布条件;如果空间最先触线,则在执行前预留旧表、新副本、临时文件和日志的安全余量。