
MySQL / 系统课时
理解 ALGORITHM=INPLACE
理解 ALGORITHM=INPLACE
本课解决一个常见误判:ALGORITHM=INPLACE 并不代表“数据原地不动”。你将区分无需表重建与需要重建的 In-place DDL,并理解在线建索引中的扫描、排序、临时空间和并发 DML 日志成本。
学习目标
- 区分
INPLACE、表重建和COPY三个概念 - 解释在线建索引期间扫描、排序与 DML 日志的作用
- 用
ALGORITHM=INPLACE, LOCK=NONE把算法与并发要求显式写入变更 SQL
INPLACE 不等于不重建
ALGORITHM=INPLACE 的准确含义是避免使用 ALGORITHM=COPY 那种由 Server 层逐行复制到完整表副本的路径,但 In-place 操作仍可能重建 InnoDB 表。因此判断成本时不能只看算法名,还要继续问两个问题:是否重建聚簇索引,以及是否需要重建或创建二级索引。
例如,增加普通二级索引支持 INPLACE 且不重建整表,但必须扫描聚簇索引并构建新索引;增加主键、调整列顺序、把列改为 NULL/NOT NULL 等操作则可能在 INPLACE 下重建表。相反,删除或重命名某些索引这类操作可能只是较轻的元数据修改。同样是 INPLACE,资源代价可以相差几个数量级。
一次在线建索引会发生什么
以增加二级索引为例,InnoDB 需要扫描聚簇索引提取键值,把待建索引数据写入临时排序文件,排序后装载成新的 B+Tree。若 LOCK=NONE 被支持,业务写入可以继续进行;并发 DML 的变化会记录到 online alter log,DDL 后期再把这些变化应用到新结构,最后完成元数据切换。
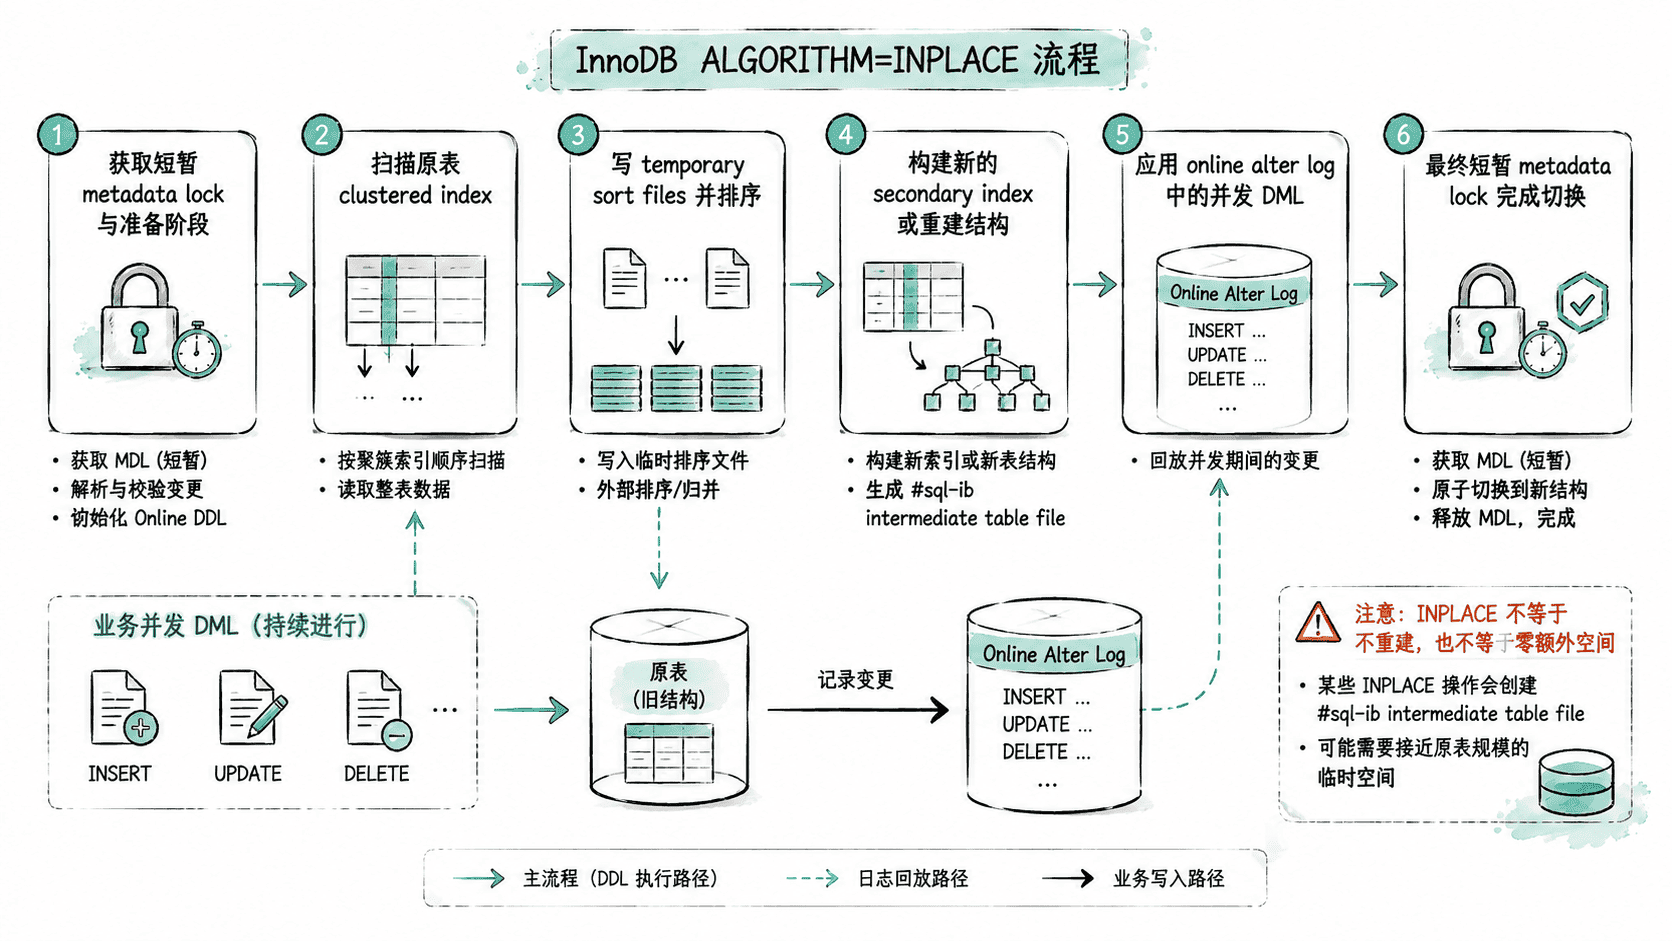
这条路径解释了为什么“在线”仍可能很重:它减少的是业务阻塞时间,不是 CPU、I/O、临时磁盘或复制延迟。DDL 越久、并发写入越多,online alter log 越大,结束阶段需要回放的变化也越多。
用 ALGORITHM 和 LOCK 把风险写进 SQL
下面创建一个测试表,并显式要求 In-place 算法和并发 DML 能力。若当前操作无法满足 ALGORITHM=INPLACE 或 LOCK=NONE,MySQL 会报错,而不是按更弱的并发条件继续执行。
CREATE DATABASE IF NOT EXISTS ddl_lab;
USE ddl_lab;

DROP TABLE IF EXISTS orders;
CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  created_at DATETIME NOT NULL,
  amount DECIMAL(10,2) NOT NULL
) ENGINE=InnoDB;

INSERT INTO orders VALUES
  (1, 101, '2026-01-01 10:00:00', 99.00),
  (2, 101, '2026-01-02 11:00:00', 199.00),
  (3, 202, '2026-01-03 12:00:00', 299.00);

ALTER TABLE orders
  ADD INDEX idx_customer_created (customer_id, created_at),
  ALGORITHM=INPLACE,
  LOCK=NONE;

SELECT INDEX_NAME, SEQ_IN_INDEX, COLUMN_NAME
FROM INFORMATION_SCHEMA.STATISTICS
WHERE TABLE_SCHEMA = 'ddl_lab'
  AND TABLE_NAME = 'orders'
  AND INDEX_NAME = 'idx_customer_created'
ORDER BY SEQ_IN_INDEX;
预期结果
INDEX_NAME            SEQ_IN_INDEX  COLUMN_NAME
idx_customer_created  1             customer_id
idx_customer_created  2             created_at
索引创建成功只能证明该操作支持所要求的算法与锁级别,不能证明它“没有扫描数据”。对大表执行同一条 DDL 时,聚簇索引扫描、排序、索引写入和日志回放仍可能消耗大量资源。
评估重建、排序和在线日志成本
上线前至少要拆开评估三类成本。重建成本关注是否需要重写聚簇数据、临时中间文件和额外磁盘;部分在线重建会在原表目录创建短暂的 #sql-ib 中间文件。排序成本常见于创建或重建二级索引,需要临时排序空间和 DDL 工作线程。日志成本来自并发 DML,受 innodb_online_alter_log_max_size 限制;写入过猛导致日志超限时,DDL 可能失败。
因此,评审 In-place DDL 时不要只问“是否在线”。更有效的问题是:是否重建表、会扫描多少数据、要创建哪些排序或中间文件、并发写入会产生多少 online alter log、最终 MDL 能否及时拿到。这些答案才决定它是否适合直接在高峰期执行。