
MySQL / 系统课时
处理 Waiting for table metadata lock
处理 Waiting for table metadata lock
线上执行 ALTER TABLE 时一旦出现 Waiting for table metadata lock,关键不是立刻杀会话,而是先找出谁持有 MDL、谁在等待,以及等待中的 DDL 是否正在把后续业务请求一起排进队列。本篇给出一套从定位阻塞链到止损、再到验证恢复的操作顺序。
学习目标
- 从等待中的 DDL 反查持有表级元数据锁的会话与事务
- 根据阻塞者状态选择等待、终止阻塞者或取消 DDL
- 识别 MDL 队列放大,并在处置后验证业务请求恢复
先确认是不是 MDL 阻塞
Waiting for table metadata lock 表示语句正在等待元数据锁,而不是在等待 InnoDB 行锁。DDL 通常需要更强的表级 MDL;如果已有事务访问过该表且迟迟没有结束,它持有的锁会一直保留到事务提交或回滚。
先从进程列表确认等待语句、持续时间和目标表:
SELECT ID, USER, HOST, DB, COMMAND, TIME, STATE, INFO
FROM information_schema.PROCESSLIST
WHERE STATE = 'Waiting for table metadata lock'
ORDER BY TIME DESC;
预期结果:
+------+--------+------------+------+---------+--------+---------------------------------+--------------------------------------+
| ID   | USER   | HOST       | DB   | COMMAND | TIME   | STATE                           | INFO                                 |
+------+--------+------------+------+---------+--------+---------------------------------+--------------------------------------+
| <ID> | <USER> | <HOST>     | app  | Query   | <TIME> | Waiting for table metadata lock | ALTER TABLE orders ADD INDEX ...     |
+------+--------+------------+------+---------+--------+---------------------------------+--------------------------------------+
实际会话 ID、等待秒数与 SQL 会不同。此时不要把 TIME 很大的会话直接等同于阻塞者;它只说明该语句等待得久。
反查阻塞者与等待链
MySQL 8.x 的 sys.schema_table_lock_waits 已把等待方和阻塞方关联起来,比单独阅读 metadata_locks 更适合现场排查。将表名替换为实际对象:
SELECT
    object_schema,
    object_name,
    waiting_pid,
    waiting_query,
    waiting_query_secs,
    blocking_pid,
    blocking_account,
    blocking_lock_type,
    blocking_lock_duration
FROM sys.schema_table_lock_waits
WHERE object_schema = 'app'
  AND object_name = 'orders'
ORDER BY waiting_query_secs DESC;
预期结果:
+---------------+-------------+-------------+----------------------+--------------------+--------------+------------------+--------------------+------------------------+
| object_schema | object_name | waiting_pid | waiting_query        | waiting_query_secs | blocking_pid | blocking_account | blocking_lock_type | blocking_lock_duration |
+---------------+-------------+-------------+----------------------+--------------------+--------------+------------------+--------------------+------------------------+
| app           | orders      | <ID>        | ALTER TABLE ...      | <VALUE>            | <ID>         | <USER>@<HOST>    | SHARED_WRITE       | TRANSACTION            |
+---------------+-------------+-------------+----------------------+--------------------+--------------+------------------+--------------------+------------------------+
如果 sys 视图不可用,可回到 performance_schema.metadata_locks,对同一 OBJECT_SCHEMA、OBJECT_NAME 同时观察 LOCK_STATUS='PENDING' 与 LOCK_STATUS='GRANTED',再通过 OWNER_THREAD_ID 连接 performance_schema.threads 获取连接 ID。
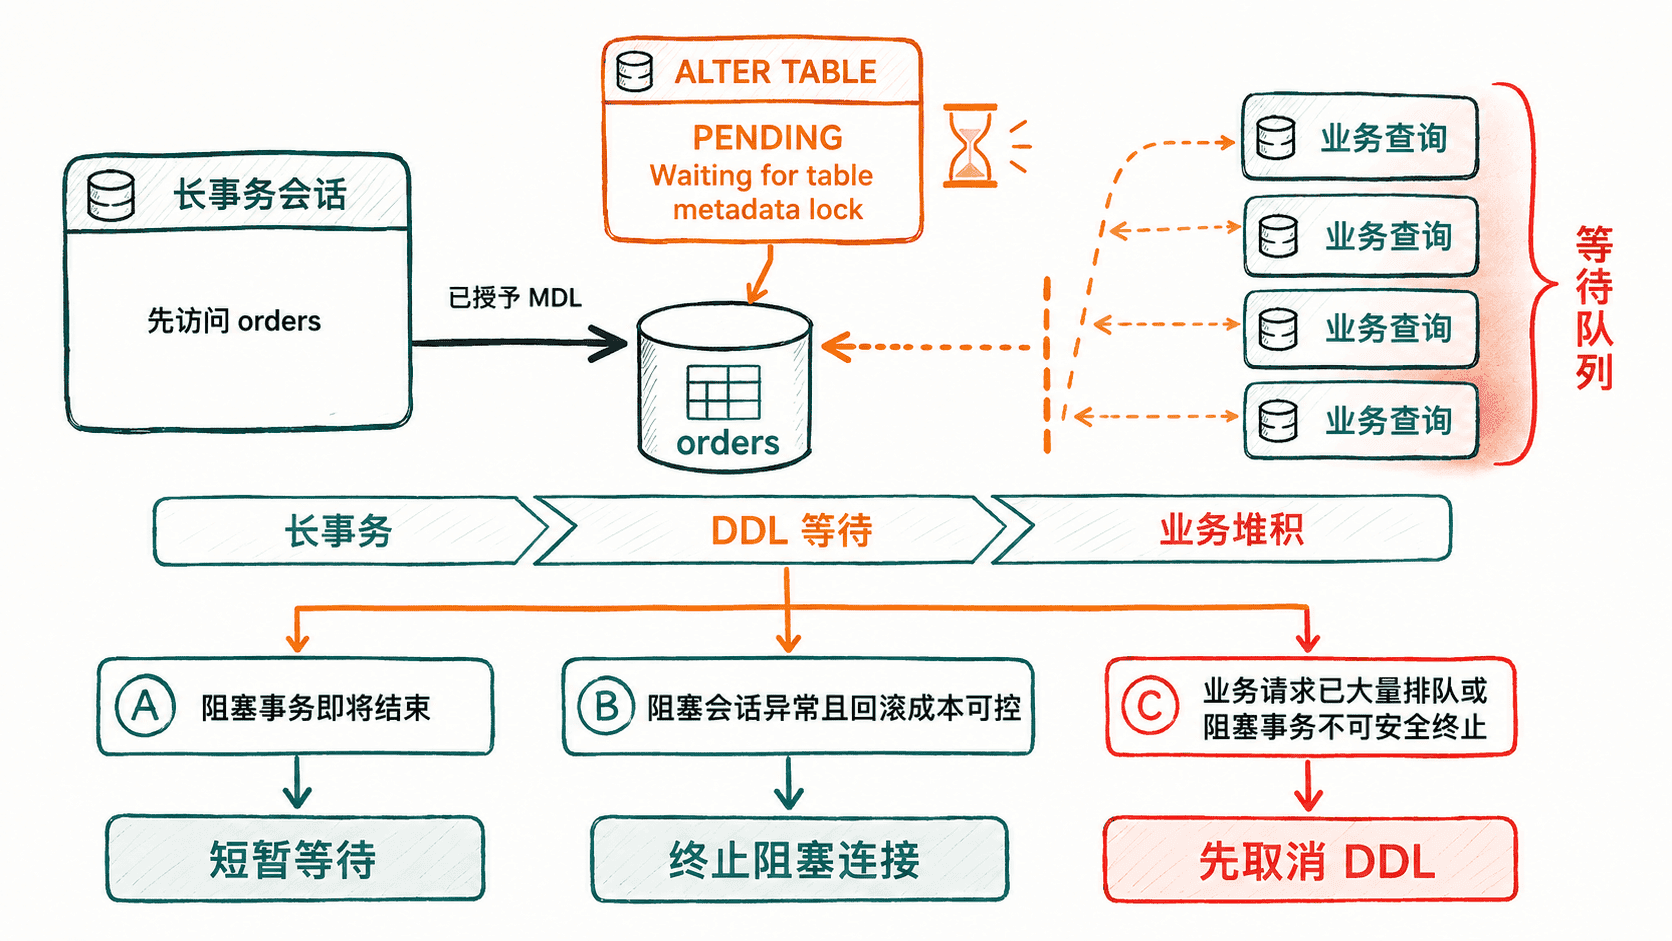
决定等、杀阻塞者还是取消 DDL
判断顺序应先看业务影响,再看阻塞事务的可终止性。阻塞者如果是已知的短事务,且等待队列尚未扩大,可以给它少量时间自然提交;如果阻塞会话长期空闲在事务中、业务方确认可以回滚,终止该连接才能释放事务持有的 MDL。
如果阻塞事务正在执行关键写入、回滚代价很大,或者大量业务查询已经排在 DDL 后面,优先取消等待中的 DDL通常更稳妥。取消待执行的强锁请求后,后续兼容锁有机会重新通过,能先恢复流量,再单独处理长事务。
终止前先查看阻塞连接当前状态:
SELECT
    t.PROCESSLIST_ID,
    t.PROCESSLIST_USER,
    t.PROCESSLIST_TIME,
    t.PROCESSLIST_STATE,
    t.PROCESSLIST_INFO,
    et.STATE AS transaction_state,
    et.TIMER_WAIT AS transaction_timer
FROM performance_schema.threads AS t
LEFT JOIN performance_schema.events_transactions_current AS et
       ON et.THREAD_ID = t.THREAD_ID
WHERE t.PROCESSLIST_ID IN (<BLOCKING_ID>, <DDL_ID>);
预期结果:
+----------------+------------------+------------------+-------------------+----------------------+-------------------+-------------------+
| PROCESSLIST_ID | PROCESSLIST_USER | PROCESSLIST_TIME | PROCESSLIST_STATE | PROCESSLIST_INFO     | transaction_state | transaction_timer |
+----------------+------------------+------------------+-------------------+----------------------+-------------------+-------------------+
| <BLOCKING_ID>  | <USER>           | <VALUE>          | <STATE>           | <SQL_OR_NULL>        | ACTIVE            | <VALUE>           |
| <DDL_ID>       | <USER>           | <VALUE>          | Waiting for table metadata lock | ALTER TABLE ... | <VALUE> | <VALUE> |
+----------------+------------------+------------------+-------------------+----------------------+-------------------+-------------------+
events_transactions_current 只展示当前可观测到的事务事件,字段也受 Performance Schema 配置影响;无法看到事务事件时,仍应结合应用连接池、事务日志与 PROCESSLIST 判断。
处置时先控制队列扩散
取消等待中的 DDL可执行:
KILL QUERY <DDL_ID>;预期结果:
Query OK, 0 rows affected (<TIME> sec)若确认要终止阻塞连接,可执行:
KILL CONNECTION <BLOCKING_ID>;预期结果:
Query OK, 0 rows affected (<TIME> sec)<DDL_ID>、<BLOCKING_ID> 与耗时以现场为准。若 DDL 由发布平台自动重试,必须同时暂停重试,否则刚清掉的待锁请求会再次进入队列。
为避免以后同类事故扩大,可在执行 DDL 的专用会话设置较短的 MDL 等待上限,让拿不到锁的变更尽快失败而不是长期排队:
SET SESSION lock_wait_timeout = 10;
ALTER TABLE app.orders ADD INDEX idx_created_at (created_at);
预期结果有两种,实际只会出现其中一种:
# 及时获得 MDL
Query OK, 0 rows affected (<TIME> sec)

# 超过 lock_wait_timeout
ERROR 1205 (HY000): Lock wait timeout exceeded; try restarting transaction
这里的 10 秒只是演示值,生产环境应根据发布窗口和业务容忍度设定。
验证锁队列已经清空
处置完成后再次检查目标表的等待关系:
SELECT
    object_schema,
    object_name,
    waiting_pid,
    blocking_pid
FROM sys.schema_table_lock_waits
WHERE object_schema = 'app'
  AND object_name = 'orders';
预期结果:
Empty set还要确认业务侧延迟和连接池等待开始回落,而不是只看 DDL 状态消失。如果取消 DDL 后队列立即消退,说明待处理的强 MDL 请求确实参与了放大;如果仍有等待,则继续沿新的 blocking_pid 追查,不要把多个阻塞链混成一个问题。