
智能合约与以太坊 / 系统课时
排查随机波动与资源超时
排查随机波动与资源超时
Foundry 模糊测试在本地通过、CI 偶尔失败,或突然运行很久,通常需要区分随机输入、外部依赖、无效输入和资源预算四类原因。本篇通过固定随机种子、复现失败案例、分析拒绝率与分级调整测试预算,建立一套能够直接用于 CI 的排查方法。
学习目标
- 区分随机波动、测试环境变化、输入拒绝和执行超时。
- 使用 Foundry 命令固定随机输入并追踪失败案例。
- 合理配置 Fuzz 测试预算,并验证修复后的稳定性。
根据失败现象确定排查方向
同样的测试有时通过、有时失败,并不意味着 Solidity 合约存在随机执行行为。EVM 在相同初始状态、交易输入及区块环境下具有确定性。变化通常来自测试输入、链上状态、外部 RPC 或运行环境。
| 观察到的现象 | 优先检查 | 判断依据 |
|---|---|---|
| 只有部分随机种子失败 | 输入相关的业务缺陷 | 固定种子后能稳定复现 |
| 同一种子仍偶发失败 | Fork 状态、环境变量、并发资源 | 输入一致但外部条件不同 |
| 报告过多输入被拒绝 | vm.assume 过滤过严 |
有效样本比例过低 |
| 增加运行次数后 CI 超时 | 执行预算或单次调用成本 | 耗时随测试规模增长 |
| 本地通过、CI 稳定失败 | 工具版本或配置差异 | 两端编译器及测试参数不同 |
建议先记录完整失败命令、Foundry 版本、Git 提交、测试名称、随机种子和 CI 执行环境,再修改代码。不要一开始就调高超时或重复运行整个测试套件。
一个实用的诊断顺序是:先复现失败,再判断固定输入后是否仍波动,然后检查外部依赖和输入过滤,最后调整执行预算。这样能避免把真实的合约缺陷误判为机器性能问题。
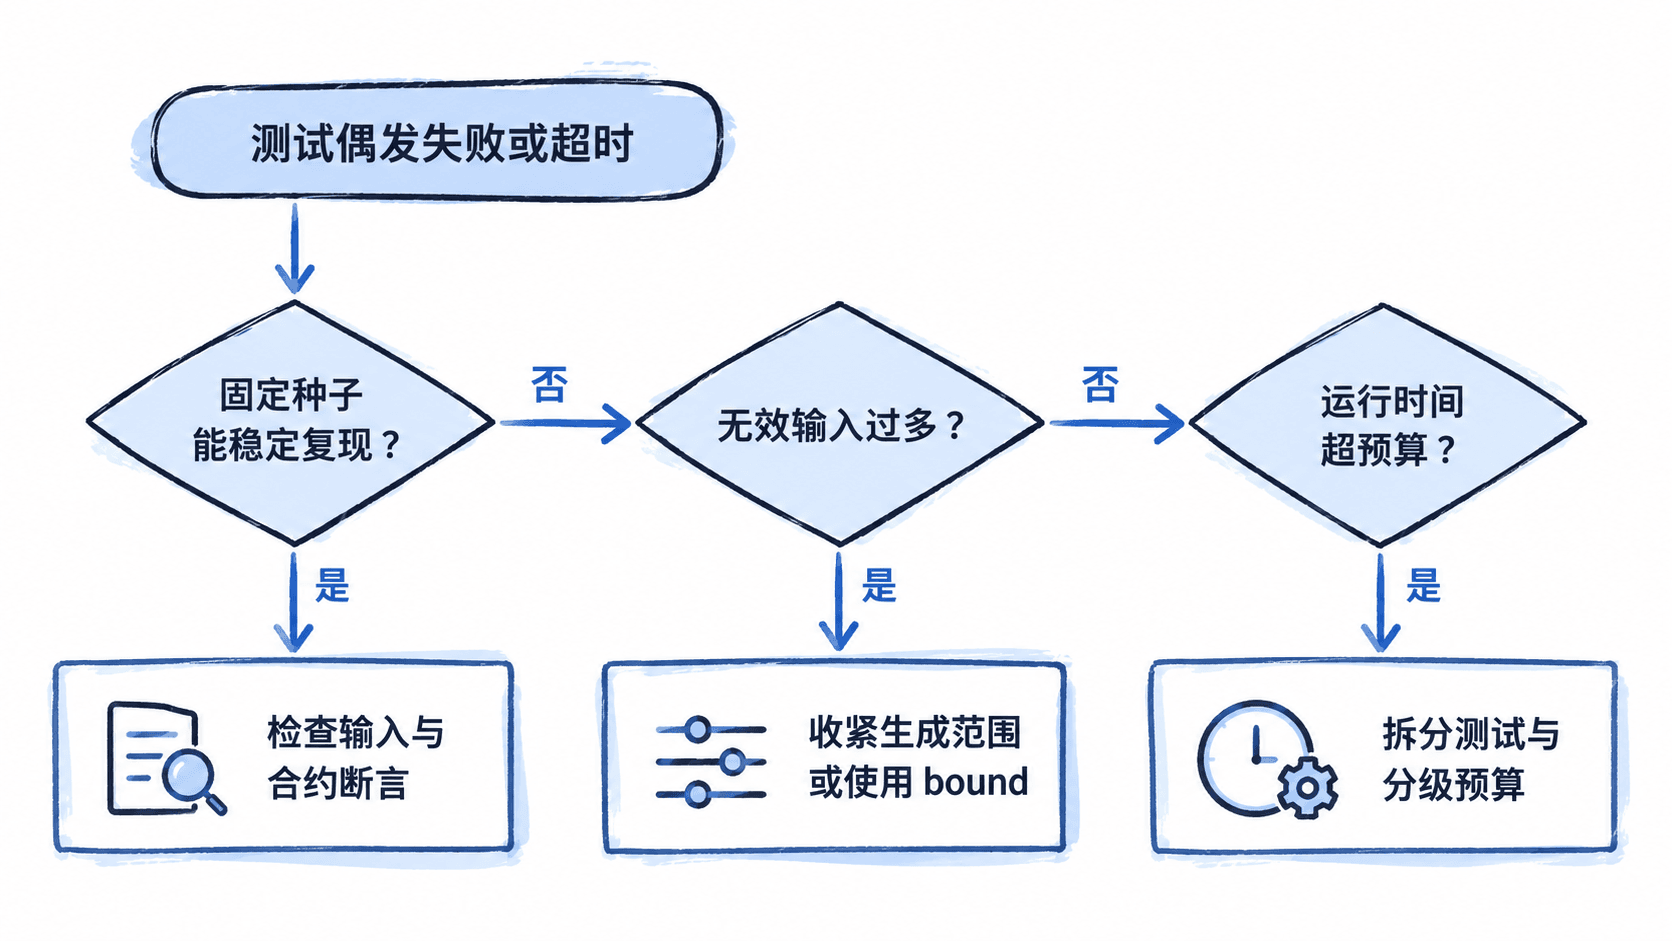
固定随机种子并复现失败输入
在已安装 Foundry、进入包含 foundry.toml 的项目根目录后,先检查当前工具版本,再仅执行出现波动的测试。以下命令适用于提供 --fuzz-seed 与 --fuzz-runs 参数的 Foundry 版本,实际可通过 forge test --help 确认。
# 记录当前 Foundry 版本,便于与 CI 对比
forge --version

# 固定随机种子和执行次数,只排查目标测试
forge test --match-test '^testFuzz_Deposit$' --fuzz-seed 0x1234 --fuzz-runs 1000 -vvvv
预期结果:第一条命令输出安装的 Forge 版本;第二条命令执行名称匹配的测试,成功时测试结果显示 PASS,失败时显示 FAIL 并提供失败信息。-vvvv 用于展开详细执行轨迹,实际耗时、Gas 数值及失败参数由项目决定。
如果固定种子后每次都在相同输入附近失败,优先检查金额边界、整数舍入、状态前置条件和断言。若相同种子仍有不同结果,则检查是否使用 Fork、动态时间、环境变量或外部数据。
Foundry 的失败输出可能包含反例(Counterexample),测试失败时应记录具体参数。相比只保留随机种子,能够稳定触发问题的最小反例更适合加入回归测试。
下面是一个可运行的独立示例。将其保存为 test/DepositFuzz.t.sol,使用 Foundry 标准测试库 forge-std,不依赖外部 RPC。
// SPDX-License-Identifier: MIT
pragma solidity ^0.8.20;

import {Test} from "forge-std/Test.sol";

contract DepositFuzzTest is Test {
    function testFuzz_Deposit(uint256 amount) public pure {
        // 限制为业务允许的金额范围,避免无意义输入。
        amount = bound(amount, 1, 1000);

        uint256 fee = amount / 100;
        uint256 received = amount - fee;

        // 验证金额守恒,包含整数除法的舍入情况。
        assertEq(received + fee, amount);
    }
}
执行验证:
forge test --match-test '^testFuzz_Deposit$' --fuzz-seed 0x1234 --fuzz-runs 1000预期输出包含类似测试状态:
[PASS] testFuzz_Deposit(uint256)输出中的具体运行次数、Gas 统计和耗时依 Foundry 版本及配置而不同。如果实际项目出现反例,可将金额固定为该反例,单独编写确定性的回归断言,而不是依赖随机测试下次再次生成相同输入。
排除外部状态与执行环境变化
固定随机种子并不等于固定整个测试环境。使用 Fork 测试时,vm.createSelectFork、--fork-url 等机制会读取远端链状态;如果没有锁定区块,合约余额、储备量、预言机价格可能随链头更新而变化。
诊断 Fork 测试时,先固定 RPC 数据来源与区块高度。以下为命令模板,其中环境变量 RPC_URL 需要提前配置,<BLOCK_NUMBER> 必须替换成实际存在的区块号。
# 固定 Fork 区块并缩小测试范围
forge test --fork-url "$RPC_URL" --fork-block-number <BLOCK_NUMBER> --match-test '^testFuzz_Deposit$' -vvv
预期结果:若测试实际使用 Fork 状态,重复执行时将以指定区块的链状态作为基线;如果 RPC 服务不可用、区块不存在或服务商不支持访问该历史状态,命令会失败。固定区块不能消除 RPC 网络超时、服务限流及本地并发资源争用。
对于纯单元测试,尽量避免引入真实 RPC。涉及区块时间的测试,使用 vm.warp 设置指定时间;涉及区块高度的测试,使用 vm.roll 固定高度;涉及调用者身份的测试,使用 vm.prank 或 vm.startPrank 指定调用地址。
CI 环境至少核对以下项目:
- Foundry 版本:使用团队验证过的具体版本或提交,不在不同任务中随意升级。
- 编译配置:核对 Solidity 编译器、优化器和
evm_version。 - 外部依赖:核对锁定的 Git 子模块或依赖版本,以及 Fork 区块。
- 并发资源:检查 Runner 的 CPU、内存与同时运行的测试任务。
- 缓存行为:遇到难以解释的差异时,执行
forge clean后重新测试。
不要将真实 RPC 密钥写入仓库,也不要为了让 CI 通过而关闭失败断言。
处理无效输入过多和测试预算耗尽
vm.assume 适合排除少量不满足前置条件的输入,但当有效范围极小时,随机生成器需要不断重试。比如从完整的 uint256 空间中随机选择小于 1000 的整数,使用 vm.assume(amount < 1000) 可能导致大量拒绝,最终耗尽拒绝预算。
对于业务允许范围,可以使用 bound 将输入映射到合法区间;只有需要保持某种原始输入分布或逻辑条件时,才考虑 vm.assume。注意 bound 会改变测试输入的分布,它不适合用来验证非法输入必须回退的场景。
在 foundry.toml 中可以为快速反馈和较高强度验证配置不同 Profile。下面是可直接加入项目的配置示例:
[profile.default.fuzz]
runs = 256
max_test_rejects = 65536

[profile.ci.fuzz]
runs = 2000
max_test_rejects = 65536
这份配置定义默认运行 256 次、CI 运行 2000 次的成功样本预算,并设置最大输入拒绝数量。runs 不是生成输入的总次数上限:被拒绝的样本不会计入成功执行次数。配置字段以当前项目 forge config 输出及安装版本支持情况为准。
检查配置并运行 CI Profile:
# 检查配置是否被正确读取
FOUNDRY_PROFILE=ci forge config

# 按 CI Profile 执行目标测试
FOUNDRY_PROFILE=ci forge test --match-test '^testFuzz_Deposit$'预期结果:forge config 的配置输出应反映 CI Profile 中的 Fuzz 运行次数;测试命令在示例代码不变且环境正常时通过,测试报告中的执行次数应对应 2000 次成功样本。
若实际项目还启用了 Invariant 测试,需要分别检查 [invariant] 的 runs 和 depth,不能误以为调整 [fuzz] 就会限制状态序列测试的总调用量。
区分资源超时与业务缺陷
模糊测试总耗时大致由样本次数、单次调用成本、输入拒绝、失败反例缩减和环境开销组成。假设 2000 次有效执行每次平均需要 15 毫秒,仅测试调用部分约为 30 秒,尚未计入编译、初始化、反例缩减及远端 RPC 延迟。
遇到超时,先通过缩小运行范围和运行次数判断成本来自哪里,而不是直接把所有测试的超时上限增加到数十分钟。
# 对同一个测试进行小规模诊断
forge test --match-test '^testFuzz_Deposit$' --fuzz-runs 100 -vv

# 扩大样本数,对比耗时变化
forge test --match-test '^testFuzz_Deposit$' --fuzz-runs 1000 -vv
预期结果:两个命令均执行同一个测试,显示对应的通过或失败状态及运行统计。若第二次明显变慢,说明执行规模可能是重要因素;若少量样本也很慢,则应检查初始化、RPC、复杂存储操作或系统资源。具体耗时不能由命令预先确定。
| 诊断结果 | 优先修复方法 |
|---|---|
| 测试耗时近似随 runs 线性增加 | 将普通 PR 检查和夜间深度测试分开 |
| 单次调用特别慢 | 减少不必要的部署、重复计算和远端 RPC |
| 大量样本被拒绝 | 缩小输入定义域,减少过度使用 assume |
| 只在 CI 并行任务中超时 | 限制并发任务数或增加 Runner 资源 |
| 失败后长时间停在反例处理 | 检查失败原因与反例缩减成本,不隐藏断言失败 |
可以先以 PR 检查 256~1000 次有效样本、夜间深度检查 5000~10000 次作为团队预算的实验起点,再根据实际 Runner 性能和测试耗时调整。这些数字是建议的执行策略,不是 Foundry 强制阈值。
验证修复确实消除了波动
排查结束后,应该验证同一输入能够重复得到相同结论,并确认更换种子不会重新触发类似失败。
- 固定之前出现问题的随机种子,重复执行目标测试至少 5 次。
- 对已经发现的失败输入新增确定性回归用例,确保修复前失败、修复后通过。
- 使用 3~5 个不同随机种子重新测试,覆盖不同样本集合。
- 在与生产 CI 相同的 Runner、Foundry 版本和配置下再次运行。
- 对比修复前后的通过率、耗时和拒绝输入情况,保留日志供回归分析。
可通过下面的 Bash 命令重复验证,适用于安装了 Foundry 的 Linux 或 macOS CI Runner:
# 任意一次失败都立即停止,避免重复执行掩盖错误
set -e
for i in 1 2 3 4 5; do
  forge test --match-test '^testFuzz_Deposit$' --fuzz-seed 0x1234 --fuzz-runs 1000
  echo "Verification $i passed"
done
预期结果:每轮测试均通过,并依次打印以下确认信息:
Verification 1 passed
Verification 2 passed
Verification 3 passed
Verification 4 passed
Verification 5 passed
实际日志还会包含各轮 Forge 测试报告。如果任意一轮失败,set -e 会让脚本停止,不会继续打印该轮的成功确认。五次通过只能提高稳定性信心,不能证明测试永远不会波动。
对于持续集成,建议把失败时的种子、反例、测试命令、工具版本及失败轨迹作为构建日志或工件保留。只有能够重复复现、解释根因并通过回归验证的修复,才应视为真正解决了不稳定测试问题。