
智能合约与以太坊 / 系统课时
将测试按成本划分运行层级
将测试按成本划分运行层级
智能合约项目同时运行单元测试、参数模糊测试和状态不变量测试,容易让每次提交都等待很久。本课将根据执行成本和缺陷风险设计三级测试策略,使用 Foundry Profile 配置不同运行预算,并把快速反馈与深度检查分配到合适的执行时机。
学习目标
- 根据测试耗时、覆盖风险和反馈频率划分执行层级。
- 使用
foundry.toml为本地、PR 和深度测试配置不同预算。 - 验证各层级的执行结果,并建立测试超时后的调整规则。
为什么不能每次都运行最高强度测试
假设一个 DeFi 金库项目包含 80 个单元测试、20 个参数模糊测试和 5 个状态不变量测试。不同类型的测试,执行成本存在明显差异。
单元测试通常使用固定输入验证明确的业务规则,例如只有所有者可以修改手续费。参数模糊测试会重复生成不同输入,适合检查存款金额边界、舍入误差等问题。不变量测试还会连续调用多个函数,探索存款、赎回和转账组合形成的状态序列。
下面是一组用于预算规划的示例测量值,并非 Foundry 的固定性能指标:
| 测试类型 | 执行规模 | 示例耗时 | 主要风险覆盖 |
|---|---|---|---|
| 单元测试 | 80 个测试用例 | 4 秒 | 权限、固定边界、明确业务分支 |
| 参数模糊测试 | 20 个测试,每个 256 次运行 | 18 秒 | 输入范围、算术边界、舍入问题 |
| 状态不变量测试 | 5 个测试,每个 64 次运行、深度 50 | 45 秒 | 跨函数状态组合、资产守恒、状态失配 |
总耗时约为 67 秒。若开发者一天提交 20 次,仅测试等待就可能累计超过 22 分钟,而且增加不变量测试的执行深度后,耗时还会继续增长。
更合理的方案是让本地测试优先覆盖常见回归,让 PR 测试承担合并质量门禁,并使用定时深度测试探索低概率状态缺陷。
设计三级运行预算
以下预算适合一个中小规模的智能合约仓库,作为初始方案使用。实际数值应根据 CI 机器配置和历史执行时间调整。
| 层级 | 触发时机 | Fuzz runs | Invariant runs × depth | 目标反馈时间 |
|---|---|---|---|---|
| 快速层 | 本地修改后 | 64 | 16 × 20 | 30 秒以内 |
| 标准层 | PR 创建或更新 | 512 | 64 × 50 | 3 分钟以内 |
| 深度层 | 每晚定时及发布前 | 5000 | 256 × 200 | 20 分钟以内 |
这里的 fuzz.runs 表示每个参数模糊测试的运行次数;invariant.runs 表示每组不变量测试的运行次数,invariant.depth 表示每次运行尝试的调用序列长度。两者相乘可以粗略估算每个不变量测试的状态调用预算,但不代表实际成功执行的调用数量,也不能直接换算为代码覆盖率。
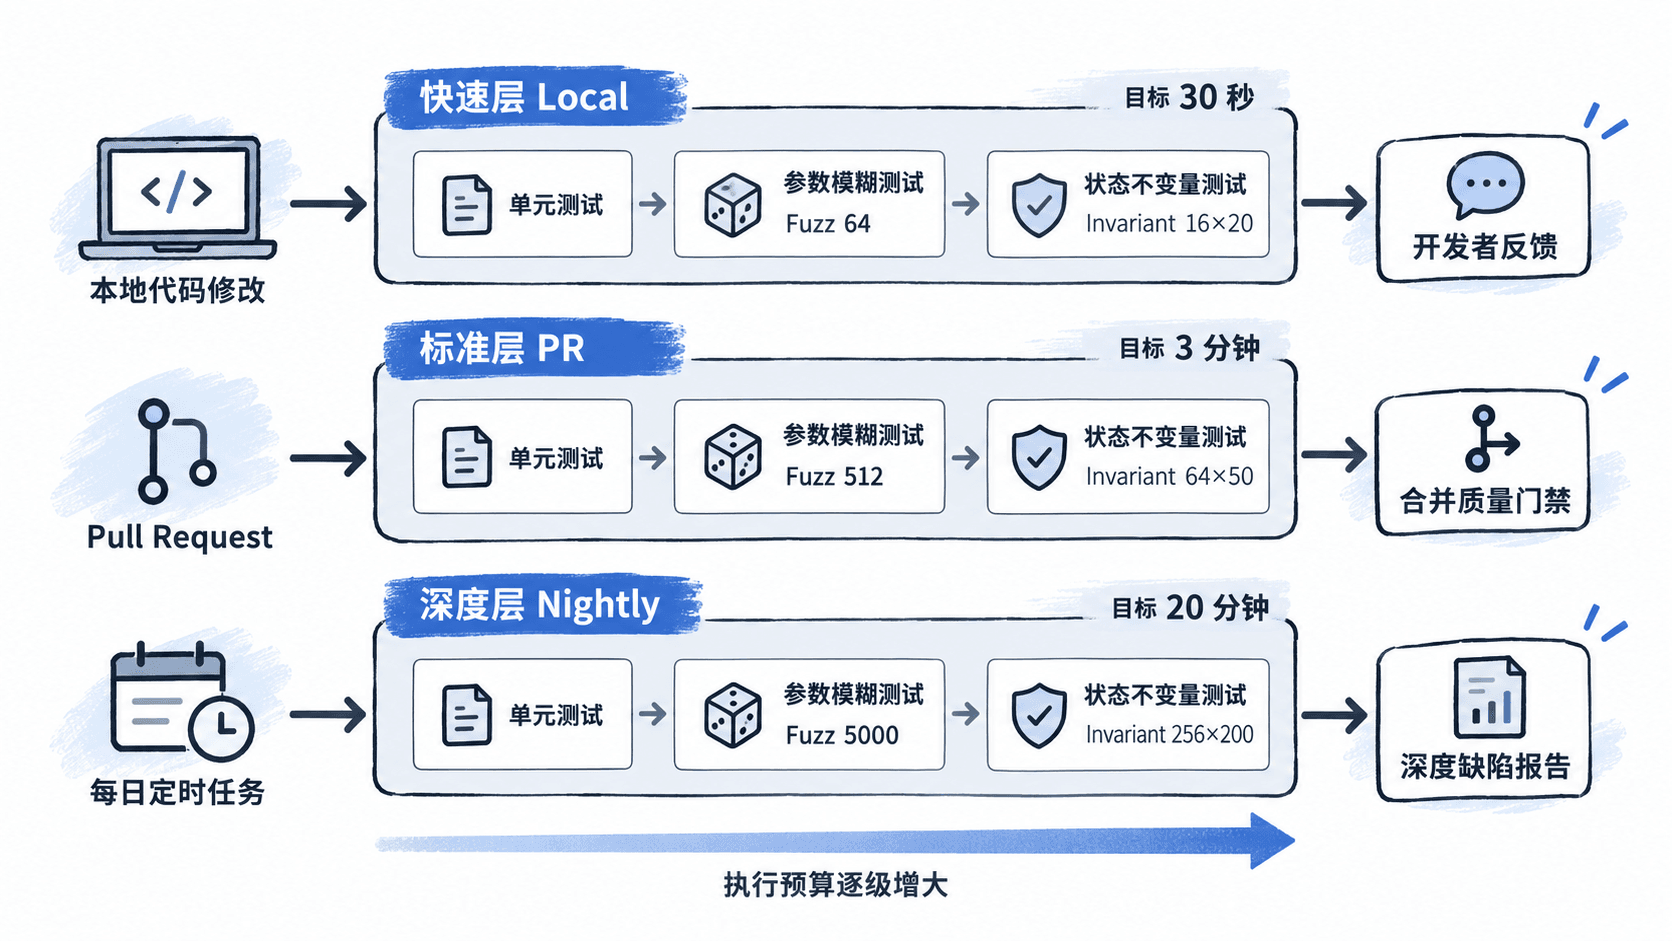
预算设计需要注意三个判断:
- 单元测试在全部层级运行,不应因为执行深度增加而被替代。
- PR 必须覆盖所有核心安全性质,例如金库资产守恒、份额供应量一致性以及未授权操作限制。
- 深度层增加探索次数和序列长度,但不应把关键安全测试完全推迟到夜间。
如果快速层已经超过 30 秒,优先分析具体慢测试,而不是直接减少重要断言或删除不变量。
配置 Foundry 的分层 Profile
Foundry 使用项目根目录的 foundry.toml 管理配置。以下示例适用于支持 [profile.<名称>.fuzz] 和 [profile.<名称>.invariant] 配置结构的 Foundry 版本。
在项目根目录创建或修改 foundry.toml,保留项目已有的编译器、依赖和 RPC 设置,然后加入以下配置:
[profile.default]
src = "src"
test = "test"
out = "out"
libs = ["lib"]

[profile.default.fuzz]
runs = 64

[profile.default.invariant]
runs = 16
depth = 20

[profile.pr.fuzz]
runs = 512

[profile.pr.invariant]
runs = 64
depth = 50

[profile.nightly.fuzz]
runs = 5000

[profile.nightly.invariant]
runs = 256
depth = 200
配置中的 default 是本地快速层,pr 和 nightly 是自定义 Profile。后两者会继承默认 Profile 中未覆盖的配置项,因此不必重复声明项目路径。
为了验证配置是否生效,在已安装 Foundry 且存在有效 Forge 测试的项目根目录执行:
# 检查工具是否可用
forge --version

# 本地快速层
forge test

# PR 标准层
FOUNDRY_PROFILE=pr forge test

# 夜间深度层
FOUNDRY_PROFILE=nightly forge test
预期结果:三个测试命令都会执行匹配的 Forge 测试。对于全部通过的测试,终端会显示测试结果及成功汇总;运行 Fuzz 或 Invariant 测试时,相关报告会体现对应的运行次数。不同 Foundry 版本的输出格式和实际耗时可能不同。
例如,标准层中某个通过的模糊测试可能出现如下信息:
[PASS] testFuzz_Deposit(uint256) (runs: 512, μ: <GAS>, ~: <GAS>)其中 <GAS> 仅表示随测试内容变化的 Gas 统计值,不是终端实际输出的字面量。测试名称也需要替换成项目中真实存在的名称。
可以通过 forge config 查看当前生效配置。如果 Profile 未切换,检查环境变量是否设置在同一条命令的执行环境中,以及是否有其他配置来源覆盖了对应参数。
将测试层级接入持续集成
以 GitHub Actions 为例,PR 创建或更新时运行标准层,每天定时运行深度层。以下示例假设代码已托管在 GitHub、仓库根目录包含 Foundry 项目,并且测试不依赖未配置的外部密钥或私有 RPC。
在 .github/workflows/forge-tests.yml 中创建工作流:
name: Forge Tests

on:
  pull_request:
  schedule:
    - cron: '0 2 * * *'
  workflow_dispatch:

jobs:
  test:
    runs-on: ubuntu-latest
    timeout-minutes: 25
    steps:
      - uses: actions/checkout@v4
        with:
          submodules: recursive

      - name: Install Foundry
        uses: foundry-rs/foundry-toolchain@v1

      - name: Run Forge tests
        env:
          FOUNDRY_PROFILE: ${{ github.event_name == 'pull_request' && 'pr' || 'nightly' }}
        run: forge test
这是完整的工作流配置示例。GitHub Actions 的 cron 时间使用 UTC,因此 0 2 * * * 表示每天 UTC 02:00;实际定时任务可能存在调度延迟。手动触发 workflow_dispatch 时也会选择 nightly Profile。
预期结果:
- 创建或更新 PR 后,工作流运行标准层,使用 512 次参数模糊测试预算以及 64 × 50 的不变量预算。
- 定时工作流触发后,使用 5000 次参数模糊测试预算以及 256 × 200 的不变量预算。
- 测试失败时,
forge test返回非零退出码,作业显示失败;测试全部通过时,作业显示成功。
工作流中的 25 分钟是单个 Job 的超时上限,不等于保证测试能在 20 分钟内完成。PR 分支保护应要求 PR 测试通过后才能合并;定时测试失败则需要单独通知维护者,避免问题长期未处理。
正式项目还应固定经过验证的 Foundry 工具链版本或提交版本,避免工具升级造成执行时间与行为变化。同时建议为依赖安装、编译和测试分别记录耗时,不能把首次下载编译器的时间误认为模糊测试执行成本。
用测量结果调整预算
先在相同机器和相同代码版本上分别运行三个层级,并记录冷缓存与热缓存的执行时间。对于高成本测试,应重复执行至少 3 次,避免单次测量受到机器负载影响。
下面给出一组示例测量结果:
| 层级 | 第 1 次 | 第 2 次 | 第 3 次 | 判断 |
|---|---|---|---|---|
| 快速层 | 18 秒 | 16 秒 | 17 秒 | 满足 30 秒目标 |
| 标准层 | 96 秒 | 91 秒 | 94 秒 | 满足 3 分钟目标 |
| 深度层 | 14 分钟 | 13 分钟 | 15 分钟 | 满足 20 分钟目标 |
建议使用最近 20 次成功执行的同类 CI 任务计算 P95 耗时,同时独立统计失败、超时和因基础设施问题取消的次数。如果样本太少,先观察最大值,不要直接把一次短耗时当成稳定指标。
常见调整方式包括:
- 快速层超时:检查是否存在大型 Fork 测试、重复部署或耗时过高的 Handler;将非关键重型场景拆到独立测试套件,同时保留关键断言。
- PR 层超时:先定位最慢的不变量测试,检查是否存在无效调用、过多拒绝输入或重复状态初始化。确认覆盖风险后再调整
runs和depth。 - 夜间层耗时波动:核对 Runner 资源、RPC 延迟及 Fork 区块固定情况。外部状态不固定时,增加测试运行次数并不能消除环境波动。
- 深度层发现缺陷:保留失败输入或调用序列,将最小复现转化为固定回归测试,优先纳入 PR 层,避免下一次仍要依赖夜间随机探索才能发现同一问题。
最终的验收标准是:本地快速层能够及时发现常见回归,PR 标准层在规定时间内完成关键安全检查,夜间深度层持续探索复杂状态组合;任何深度层新发现的真实缺陷,都应沉淀成后续提交必跑的回归测试。