
游戏叙事与剧情 / 系统课时
对话数据怎样支持角色与选项
对话数据怎样支持角色与选项
一条对话不只是“角色说一句话”。程序还要知道谁在说、显示什么文本、有哪些可选项、哪些选项此刻可见,以及选择后跳到哪里。本课把这些信息拆成稳定的数据边界,并用一个可运行的小例子验证运行时如何消费它们。
学习目标
- 能把说话人、文本、选项、条件和表现资源拆成职责清晰的数据字段
- 能设计可被运行时直接消费的选项结构,而不是把业务逻辑写进文案
- 能判断哪些信息属于剧情逻辑,哪些只属于 UI 与音画表现
从运行时需要反推数据结构
对话数据首先服务运行时,而不是服务表格排版。一个可落地的节点至少要回答五个问题:当前节点是谁说的、说什么、怎样表现、玩家能选什么、选择后去哪里。
| 信息 | 推荐职责 | 不建议做法 |
|---|---|---|
speakerId |
引用角色定义 | 直接重复角色姓名、头像路径等整套资料 |
text |
当前对白文本 | 在文本里混入跳转指令 |
presentation |
头像、语音、表情等表现资源 | 让资源缺失改变剧情分支 |
options |
玩家可选项集合 | 仅保存显示文案,不保存稳定选项标识 |
conditions |
声明选项可见条件 | 塞入任意脚本字符串 |
nextNodeId |
指向下一节点 | 用数组下标充当长期引用 |
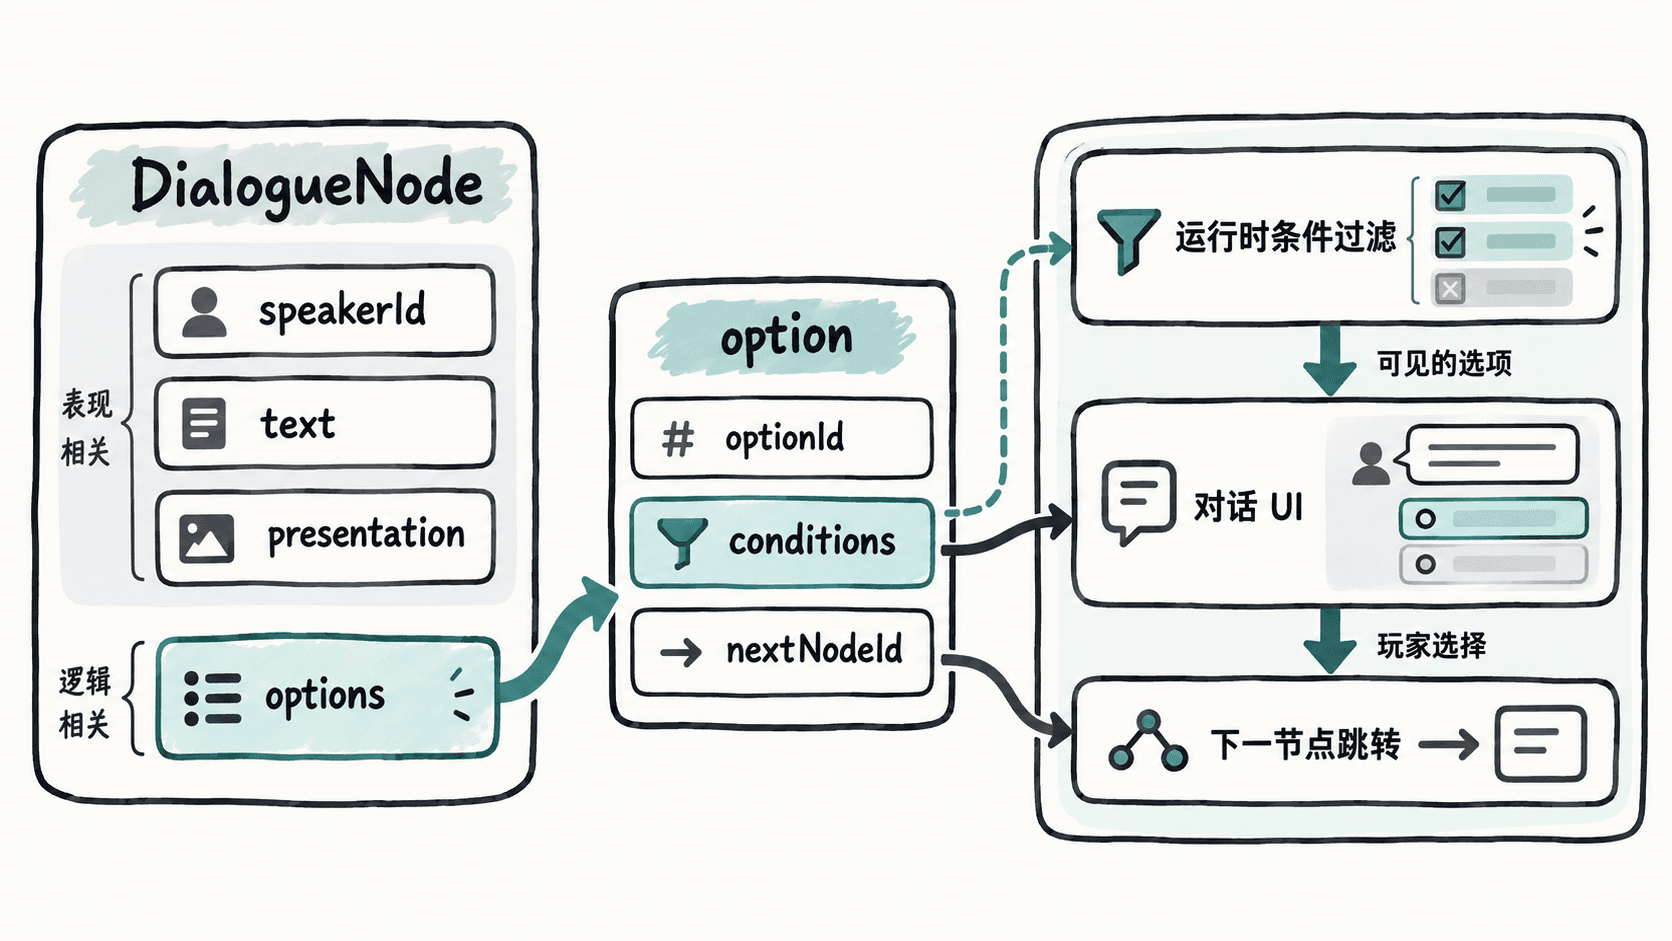
下面的数据已经能让策划直接读懂,同时让程序不必猜测字段含义。这里的 presentation 即使缺少资源,也不应阻止主对话逻辑继续执行。
{
  "nodeId": "dialogue.guard.gate.001",
  "speakerId": "character.guard",
  "text": "城门已经关闭,你有什么事?",
  "presentation": {
    "portraitAssetId": "portrait.guard.neutral",
    "voiceAssetId": "voice.guard.gate.001"
  },
  "options": [
    {
      "optionId": "ask_reason",
      "text": "为什么关闭城门?",
      "conditions": [],
      "nextNodeId": "dialogue.guard.gate.002"
    },
    {
      "optionId": "show_pass",
      "text": "出示通行证",
      "conditions": [
        {
          "type": "flag_equals",
          "key": "has_gate_pass",
          "value": true
        }
      ],
      "nextNodeId": "dialogue.guard.gate.010"
    }
  ]
}
这类结构的验证重点不是“JSON 能否解析”,而是引用和规则是否完整。例如 speakerId 必须能找到角色定义,nextNodeId 必须指向真实节点,条件类型也必须属于运行时支持的白名单。
让条件保持声明式
条件最好表达“要检查什么”,而不是“执行一段什么代码”。例如 flag_equals、quest_state_is、inventory_contains 都可以由运行时统一解释;如果直接把 player.flags['x'] && ... 之类脚本放进数据,编辑器校验、跨平台执行和安全审查都会变困难。
下面的 Python 示例模拟运行时过滤可见选项。它只支持一种条件类型,便于看清核心边界。
def condition_matches(condition, context):
    if condition["type"] == "flag_equals":
        return context["flags"].get(condition["key"]) == condition["value"]
    raise ValueError(f"unsupported condition type: {condition['type']}")

def visible_options(node, context):
    result = []
    for option in node["options"]:
        if all(condition_matches(c, context) for c in option["conditions"]):
            result.append((option["optionId"], option["text"], option["nextNodeId"]))
    return result

node = {
    "options": [
        {
            "optionId": "ask_reason",
            "text": "为什么关闭城门?",
            "conditions": [],
            "nextNodeId": "dialogue.guard.gate.002",
        },
        {
            "optionId": "show_pass",
            "text": "出示通行证",
            "conditions": [
                {
                    "type": "flag_equals",
                    "key": "has_gate_pass",
                    "value": True,
                }
            ],
            "nextNodeId": "dialogue.guard.gate.010",
        },
    ]
}
context = {"flags": {"has_gate_pass": True}}

for option_id, text, next_node_id in visible_options(node, context):
    print(f"{option_id} -> {text} -> {next_node_id}")
预期输出:
ask_reason -> 为什么关闭城门? -> dialogue.guard.gate.002
show_pass -> 出示通行证 -> dialogue.guard.gate.010
把 has_gate_pass 改成 False 后,第二个选项会被过滤,但数据本身不需要改写。这样条件系统和剧情内容可以独立演进。正式加载时还可以按 nodeId、speakerId 建立哈希索引,跳转和角色查询都直接按 ID 定位,避免每次对话都线性扫描整份数据。
选项需要稳定标识而不只是文案
选项文本会频繁润色,因此日志、埋点、存档和条件回溯都不应使用显示文案作为键。optionId 应在节点内保持稳定,文案改成“给守卫看通行证”时,既有埋点仍然能识别这是同一个选择。
nextNodeId 也比“跳到第 3 项”稳定。数组顺序只是编辑器展示顺序,一旦策划插入新节点,基于下标的引用就可能悄悄跳错目标。
把表现资源放在可降级层
头像、语音、立绘和特效通常会晚于剧情逻辑完成,因此应允许这些资源为空或加载失败。运行时可以回退到默认头像、纯文本或无语音模式,但不应因为一个 voiceAssetId 失效就阻塞分支选择。
对话数据真正需要稳定的是“身份、条件和跳转”。表现资源可以丰富体验,却不应成为剧情正确性的前提。只要这条边界明确,策划可读性、资源迭代和运行时效率就能同时兼顾。