
游戏叙事与剧情 / 系统课时
多人协作时如何管理剧情数据
多人协作时如何管理剧情数据
剧情系统进入多人协作后,真正拖慢效率的往往不是剧情逻辑本身,而是多人同时修改同一批数据造成的冲突、重复 ID 和错误合并。本课建立一套可落地的数据拆分、唯一标识、自动校验与审查流程,让策划和程序可以并行工作。
学习目标
- 按稳定职责拆分剧情数据,减少多人修改同一文件的概率
- 设计不会因排序、移动或重构而变化的剧情唯一 ID
- 用自动校验与代码审查阻止重复 ID、悬空引用和误合并进入主分支
先解决多人共改一个文件的问题
最危险的组织方式,是把全部对话、任务和条件都放进一个巨大的 JSON、YAML 或表格文件。即使 Git 能完成文本合并,两名成员同时调整节点顺序、插入对白或修改任务条件时,也很容易产生语法上能够合并、语义上却已经错误的结果。
更稳妥的原则是按稳定的内容所有权拆分,而不是按文件大小机械切片。例如主线按章节拆分,支线按任务拆分,可复用角色、变量和条件定义放入独立注册表。这样一个需求通常只会修改少数几个明确文件。
narrative/
  main/
    act-01.json
    act-02.json
  quests/
    quest-blacksmith.json
    quest-harbor.json
  shared/
    characters.json
    variables.json
这种目录不是唯一标准,关键是让文件边界与团队的工作边界尽量一致。如果两个策划长期负责不同任务线,他们最好也长期修改不同的数据文件。
唯一 ID 必须脱离文件位置
节点 ID 不应使用数组下标、行号或类似 dialogue_17 的临时编号,因为插入、排序和拆文件都会改变这些位置。更合适的是使用稳定、全局唯一且创建后不再修改的业务 ID。
下面是一条对话节点的数据示例。id 用于保存进度、跳转和外部引用,显示文本、所在文件甚至节点顺序都可以改变,但已经发布的 id 应保持不变。
{
  "id": "dlg.harbor.guard.first-meet",
  "speakerId": "npc.harbor.guard",
  "text": "港口今天封锁了。",
  "nextId": "dlg.harbor.guard.ask-reason"
}
团队还需要约定 ID 的命名空间,例如 dlg.、quest.、npc.、flag.。命名空间不是为了好看,而是为了在日志、报错和代码审查中快速判断一个引用属于什么领域。
把冲突检查放到合并之前
多人协作不能只依赖人工发现问题。提交剧情数据后,应先进行机器校验,再进入人工审查。机器负责确定性的规则,例如重复 ID、缺失引用和非法字段;审查者重点判断剧情逻辑、变量生命周期以及修改范围是否合理。
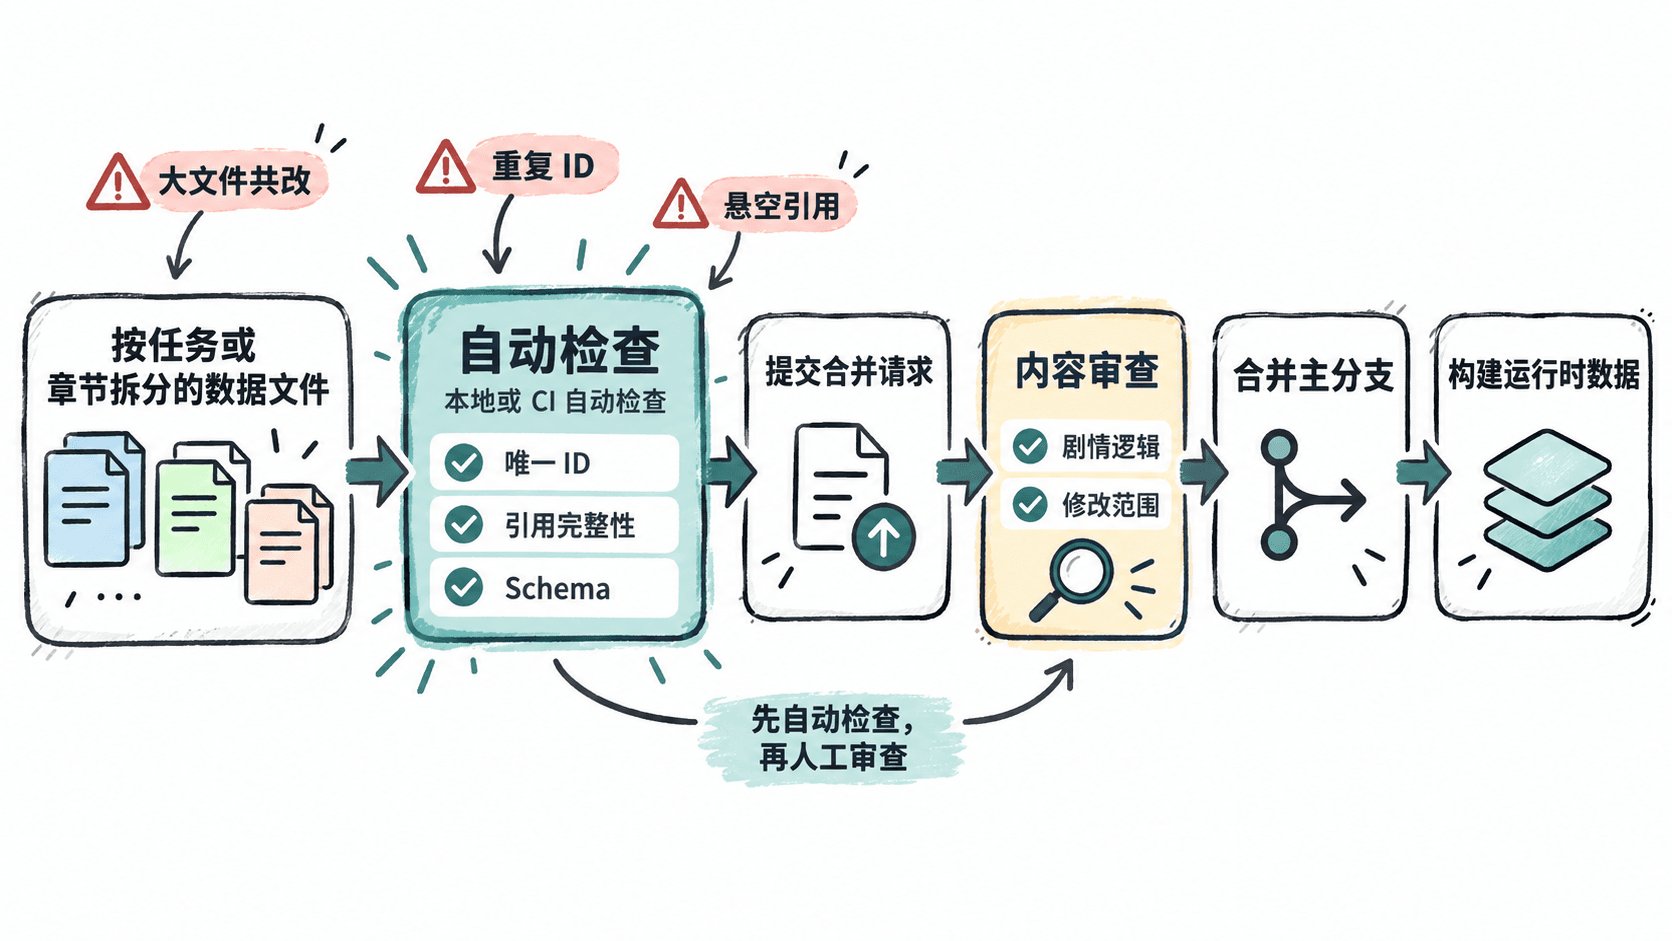
下面的完整 Python 示例模拟合并前的 ID 校验。真实项目中可以把同样规则接到 CI,对仓库内全部剧情文件执行扫描。
from collections import Counter


def validate_nodes(nodes: list[dict]) -> None:
    ids = [node["id"] for node in nodes]
    duplicated = sorted(
        node_id for node_id, count in Counter(ids).items() if count > 1
    )

    if duplicated:
        raise ValueError(f"duplicate narrative ids: {duplicated}")

    known_ids = set(ids)
    for node in nodes:
        next_id = node.get("nextId")
        if next_id is not None and next_id not in known_ids:
            raise ValueError(
                f"unknown nextId {next_id!r} referenced by {node['id']!r}"
            )


if __name__ == "__main__":
    sample_nodes = [
        {
            "id": "dlg.harbor.guard.first-meet",
            "nextId": "dlg.harbor.guard.ask-reason",
        },
        {
            "id": "dlg.harbor.guard.ask-reason",
            "nextId": None,
        },
    ]

    validate_nodes(sample_nodes)
    print("narrative validation passed")
预期输出:
narrative validation passed如果第二个节点被删除,校验器应立即报告第一个节点引用了不存在的 nextId。这类错误越早在提交阶段被阻止,越不容易演变成运行时才出现的断链。
审查重点不是逐字检查 JSON
人工审查应关注机器难以判断的问题:某次提交是否同时修改了过多任务线、一个公共变量是否改变了既有语义、删除节点是否考虑已有存档、跨文件引用是否符合剧情设计。对于大范围重构,最好把“纯移动或改格式”和“剧情逻辑修改”拆成不同提交,否则审查者很难看出真正发生了什么变化。
实际项目中,可以把剧情数据管理归纳为三个约束:文件边界稳定、业务 ID 稳定、合并入口有自动校验。这三点建立后,多人开发的主要矛盾就会从“谁又把文件合坏了”转变为正常的内容评审与设计讨论。