
游戏叙事与剧情 / 系统课时
文本与资源引用怎么防止失效
文本与资源引用怎么防止失效
剧情内容通常会同时引用角色、语音、立绘、场景和本地化文本。真正危险的不是资源多,而是脚本直接保存文件路径或显示名称:一次改名、移动目录或语言切换,就可能让大量剧情节点断链。本课用稳定 ID、资源目录和提交校验把这些引用从“碰运气”变成可管理的数据关系。
学习目标
- 理解为什么剧情数据不应直接依赖资源文件名、目录和展示文本
- 用稳定资源 ID 建立角色、语音、立绘、场景与本地化文本之间的间接引用
- 在资源重命名和迁移后验证引用仍然能够正确解析
把显示名称和资源身份分开
最容易失效的设计,是让剧情节点直接保存 Assets/Characters/Alice/portrait_happy.png、Alice 或中文台词本身。文件移动后路径失效,角色改名后名称失效,而直接保存文案还会让本地化版本难以切换。
更稳妥的做法是为可引用对象分配不会随着展示名称变化的稳定 ID,例如 char.alice、portrait.alice.happy、voice.prologue.001、scene.station 和 loc.dialogue.prologue.001。剧情节点只保存这些 ID,真正的文件路径、显示名称和语言文本由独立目录解析。
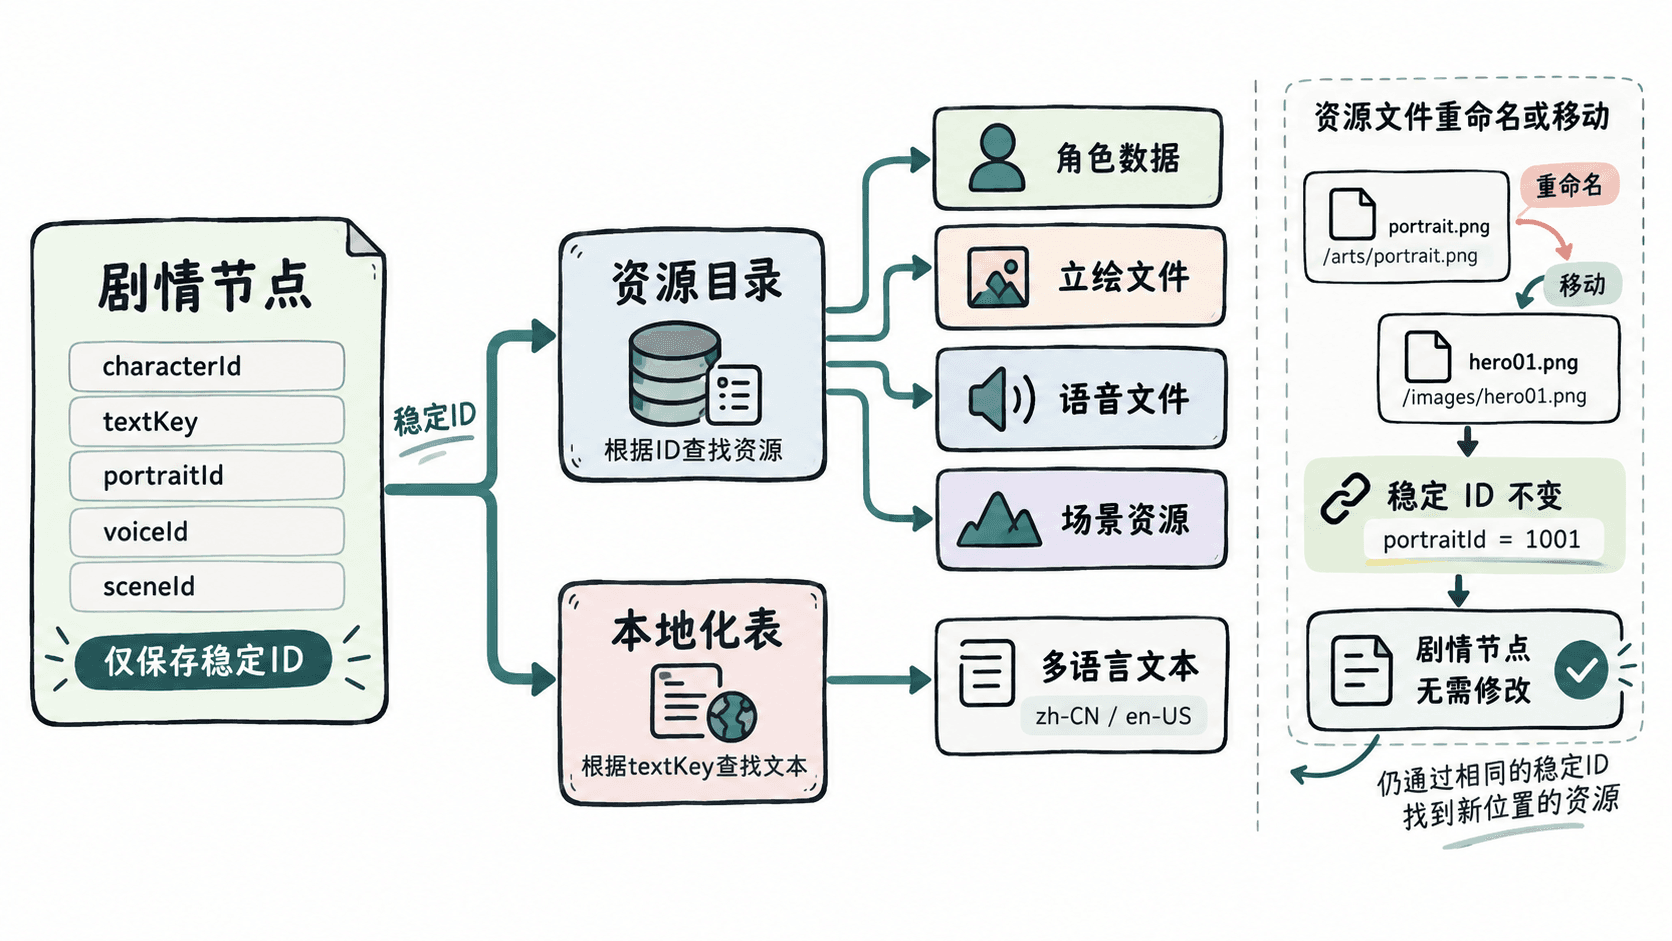
用资源目录集中解析引用
下面的示例把剧情节点和资源目录分开保存。剧情数据只引用稳定 ID;真正运行时再通过目录解析资源。这样即使立绘文件从 portraits/alice_happy.png 移到 characters/alice/happy.webp,只需修改目录,不需要批量修改剧情节点。
from dataclasses import dataclass

@dataclass(frozen=True)
class DialogueNode:
    speaker_id: str
    text_key: str
    portrait_id: str
    voice_id: str
    scene_id: str

RESOURCE_CATALOG = {
    "char.alice": {"type": "character", "name": "Alice"},
    "portrait.alice.happy": {
        "type": "portrait",
        "path": "characters/alice/happy.webp",
    },
    "voice.prologue.001": {
        "type": "voice",
        "path": "voice/zh-CN/prologue_001.ogg",
    },
    "scene.station": {
        "type": "scene",
        "path": "scenes/station.scene",
    },
}

LOCALIZATION = {
    "loc.dialogue.prologue.001": "我们终于到站了。",
}

def resolve_node(node: DialogueNode) -> dict[str, str]:
    refs = {
        "speaker": node.speaker_id,
        "portrait": node.portrait_id,
        "voice": node.voice_id,
        "scene": node.scene_id,
    }
    missing = [resource_id for resource_id in refs.values() if resource_id not in RESOURCE_CATALOG]
    if node.text_key not in LOCALIZATION:
        missing.append(node.text_key)
    if missing:
        raise ValueError(f"missing references: {', '.join(missing)}")

    return {
        "speaker": RESOURCE_CATALOG[node.speaker_id]["name"],
        "text": LOCALIZATION[node.text_key],
        "portrait": RESOURCE_CATALOG[node.portrait_id]["path"],
        "voice": RESOURCE_CATALOG[node.voice_id]["path"],
        "scene": RESOURCE_CATALOG[node.scene_id]["path"],
    }

if __name__ == "__main__":
    node = DialogueNode(
        speaker_id="char.alice",
        text_key="loc.dialogue.prologue.001",
        portrait_id="portrait.alice.happy",
        voice_id="voice.prologue.001",
        scene_id="scene.station",
    )
    print(resolve_node(node))
预期输出:
{'speaker': 'Alice', 'text': '我们终于到站了。', 'portrait': 'characters/alice/happy.webp', 'voice': 'voice/zh-CN/prologue_001.ogg', 'scene': 'scenes/station.scene'}这个例子里的路径仍然可能变化,但变化被限制在 RESOURCE_CATALOG 内。剧情节点只依赖稳定 ID,因此路径调整不会扩散成大量剧情文件修改。
处理重命名、删除和本地化变化
资源重命名通常分成两类。只修改展示名称或文件路径时,应保持稳定 ID 不变;如果确实需要废弃 ID,则先建立迁移映射,把旧 ID 转换成新 ID,再删除旧条目。不要在同一次提交中直接删除旧 ID 并期待所有剧情作者同步修改。
本地化文本也应遵循同样原则。剧情节点保存 textKey,不同语言分别维护对应文本。增加日语或英语不会改变节点结构,而缺失某种语言时,校验工具可以准确指出缺的是哪个 key,而不是把问题误判为整段剧情数据损坏。
提交前验证引用闭包
真正可靠的资源引用需要同时检查“存在”和“类型正确”。提交剧情时,应遍历所有节点,确认角色、立绘、语音、场景和本地化 key 都能解析,并检查被引用资源是否仍处于可发布状态。对于准备删除的资源,还应反向查询哪些剧情节点仍然依赖它。
一个实用的约束是:剧情内容只能引用资源目录中已经登记的稳定 ID,资源删除必须先保证反向引用数量为零。这样重命名只是目录更新,删除则变成显式迁移流程,而不是上线后才发现某段对话突然没有立绘或语音。
当稳定 ID、集中资源目录、本地化 key 和提交校验同时存在时,剧情内容就不再依赖脆弱的文件位置。策划可以改显示名称,美术可以整理目录,音频可以调整格式,而剧情节点仍保持稳定。