
游戏叙事与剧情 / 系统课时
设计剧情节点与连接关系
设计剧情节点与连接关系
剧情一旦出现选择、条件和回流,单纯把“下一句是谁”写在节点里就会迅速失控。本节建立统一的节点与连接模型,让线性剧情和分支剧情使用同一种结构,并在加载阶段就发现重复 ID、悬空连接和不合法出口。
学习目标
- 设计能同时表达线性与分支路径的节点、边数据结构
- 为节点建立稳定且可校验的唯一标识
- 在数据进入运行时前验证连接完整性和出口规则
节点负责内容,连接负责去向
最常见的早期设计,是在每个节点里直接写一个 nextNodeId。它对线性剧情很方便,但一旦加入二选一、条件分支或失败出口,就会不断出现 nextNodeId、successNextId、failNextId、optionNextIds 等字段,数据结构会被节点类型拖着走。
更稳定的做法是把“节点”和“连接”拆开。节点只描述本节点是什么、需要哪些业务数据;连接单独描述从哪个节点出发、到哪个节点,以及这条边在什么条件或端口下成立。线性剧情只是“每个节点恰好有一条默认边”的特例。
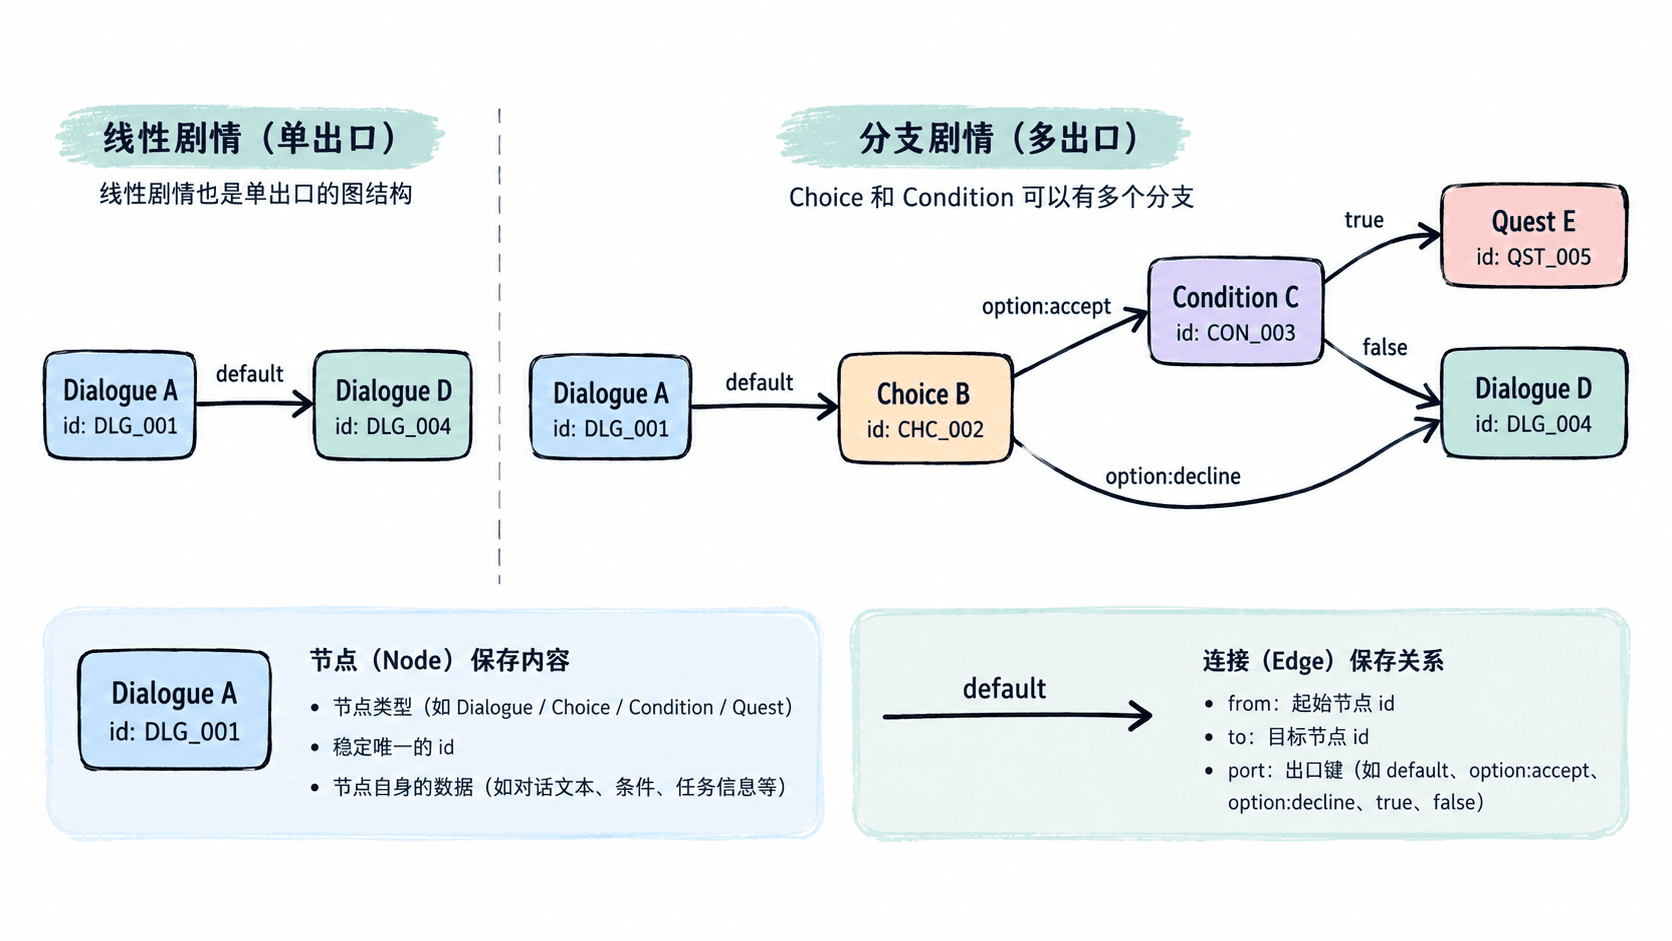
用统一结构表达节点和边
下面示例用一组节点和一组边表达剧情图,并在加载时校验 ID 与引用关系。port 用来描述边从哪个语义出口离开节点,而不是把不同分支字段硬编码进节点公共结构。
type NodeType = "dialogue" | "choice" | "condition" | "end";

interface NarrativeNode {
  id: string;
  type: NodeType;
  data: Record<string, unknown>;
}

interface NarrativeEdge {
  from: string;
  to: string;
  port: string;
}

interface NarrativeGraph {
  startNodeId: string;
  nodes: NarrativeNode[];
  edges: NarrativeEdge[];
}

function validateGraph(graph: NarrativeGraph): string[] {
  const errors: string[] = [];
  const ids = new Set<string>();

  for (const node of graph.nodes) {
    if (ids.has(node.id)) {
      errors.push(`duplicate node id: ${node.id}`);
    }
    ids.add(node.id);
  }

  if (!ids.has(graph.startNodeId)) {
    errors.push(`missing start node: ${graph.startNodeId}`);
  }

  for (const edge of graph.edges) {
    if (!ids.has(edge.from)) {
      errors.push(`edge source not found: ${edge.from}`);
    }
    if (!ids.has(edge.to)) {
      errors.push(`edge target not found: ${edge.to}`);
    }
  }

  return errors;
}

const graph: NarrativeGraph = {
  startNodeId: "dialogue-01",
  nodes: [
    { id: "dialogue-01", type: "dialogue", data: { text: "要接任务吗?" } },
    { id: "choice-01", type: "choice", data: { options: ["accept", "decline"] } },
    { id: "quest-accepted", type: "end", data: { result: "accepted" } },
    { id: "end-declined", type: "end", data: { result: "declined" } }
  ],
  edges: [
    { from: "dialogue-01", to: "choice-01", port: "default" },
    { from: "choice-01", to: "quest-accepted", port: "accept" },
    { from: "choice-01", to: "end-declined", port: "decline" }
  ]
};

console.log(validateGraph(graph));
预期输出
[]空数组表示基础结构校验通过。实际项目还应继续验证节点类型自己的规则,例如 choice 节点是否至少存在两个合法出口,但这类规则应建立在同一套图结构之上。
唯一标识必须脱离显示文本
节点 ID 不应由对白文本、编辑器坐标或数组下标临时生成。文本会被本地化,坐标会被拖动,数组顺序会被重新保存;如果这些变化导致 ID 改变,存档、测试快照和外部任务引用都会失效。
工程上可以使用 UUID、ULID,或由编辑器创建时生成的稳定字符串。关键要求只有两个:同一剧情资源内不能重复,节点内容修改时 ID 不能无故变化。运行时和存档应引用 ID,而不是依赖“第几个节点”。
给连接规则加上可验证约束
只有“from 和 to 都存在”还不够。不同节点类型通常有不同出口约束:普通对白通常只有一个 default 出口;选择节点的 port 应对应某个选项;终止节点不应再有出边。把这些规则放在导入或构建阶段,比运行到半小时后才发现死路更容易定位。
可以把验证分成三层:结构层检查重复 ID 与悬空引用;类型层检查节点自己的必填数据;图层检查不可达节点、非法出口和是否存在预期终点。这样错误信息能准确告诉内容作者“哪一个节点、哪一条边、违反了什么规则”。
线性与分支不需要两套模型
当连接被独立建模后,线性路径只是每个非终点节点只有一条可用边;分支路径只是某些节点拥有多条带不同 port 的边。运行时只需根据当前节点执行结果选择一个出口,再从边表中找到目标节点,不必维护两套跳转逻辑。
这个结构还为后续条件表达式、任务状态、编辑器可视化和静态检查保留了扩展空间。真正需要守住的边界是:节点描述“发生什么”,连接描述“接下来去哪”,稳定 ID 负责让两者可以被可靠引用。