
游戏叙事与剧情 / 系统课时
策划编辑器需要暴露哪些字段
策划编辑器需要暴露哪些字段
策划编辑器不是把运行时对象的所有属性搬到面板上,而是把“策划能安全决定的内容”变成受约束的字段。本篇从节点、条件、动作、资源和引用五类信息划定编辑范围,并给出可校验的数据结构,避免无效入口、悬空引用和运行时才暴雷的配置。
学习目标
- 区分必须让策划编辑的业务字段与应由程序固定的运行时字段。
- 设计节点、条件、动作、资源和引用字段的最小可用集合。
- 在保存阶段完成类型、引用和互斥规则校验,而不是把错误留到运行时。
先按责任划分字段
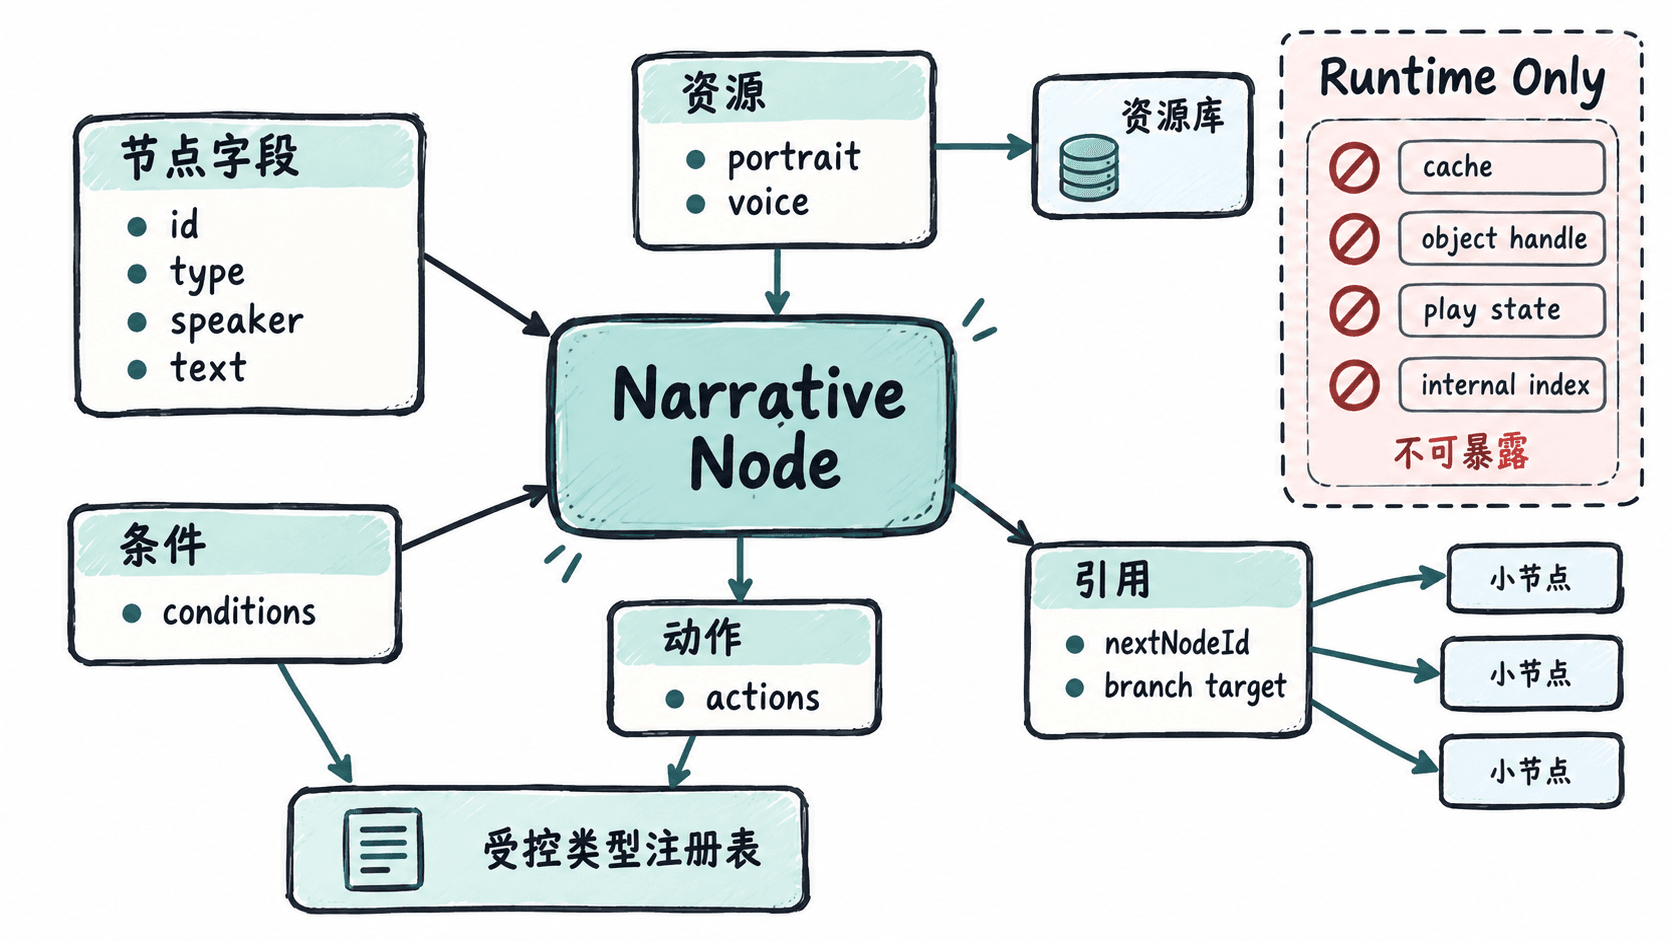
一个剧情节点通常同时包含内容、流程控制和运行时状态。编辑器真正应该暴露的是内容和规则,例如节点 ID、台词、进入条件、完成动作、下一节点引用和资源引用;缓存句柄、对象实例、播放状态、内部索引、脏标记等运行时字段则不应出现。
可以把字段分成五组:节点字段描述“这是什么”,条件字段描述“什么时候可进入”,动作字段描述“进入或完成时做什么”,资源字段描述“需要哪些可替换内容”,引用字段描述“接下来指向谁”。这五组已经覆盖大多数策划操作,不需要把底层系统 API 原样暴露。
最小字段集要能表达完整意图
下面是一份足够支撑普通对白节点的配置示例。它不是要求所有节点都拥有所有字段,而是展示“可编辑数据”和“运行时状态”分离后的形态。
{
  "id": "dlg-forest-001",
  "type": "dialogue",
  "speaker": "npc_guard",
  "text": "前面的桥已经封锁了。",
  "conditions": [
    {
      "type": "quest-state",
      "questId": "quest-rescue",
      "state": "started"
    }
  ],
  "actions": [
    {
      "type": "set-flag",
      "key": "heard_bridge_warning",
      "value": true
    }
  ],
  "resources": {
    "portraitId": "portrait-guard-neutral",
    "voiceId": "vo-forest-001"
  },
  "nextNodeId": "dlg-forest-002"
}
这份配置保存后,编辑器应至少验证 id 唯一、type 已注册、条件和动作类型存在、资源 ID 可解析、nextNodeId 指向真实节点。运行时只消费通过校验的数据,不再猜测缺失字段应该代表什么。
字段不要只做“自由文本”
最危险的编辑器设计,是把所有参数都做成字符串。比如 questId 应来自任务数据源选择器,state 应来自限定枚举,voiceId 应来自资源选择器,节点引用应使用可跳转到目标节点的引用控件。这样错误可以在编辑时暴露,而不是上线后才发现 "complated" 拼错。
只有真正开放的文案、备注和某些数值参数适合自由输入。即便如此也应设置约束,例如文本长度、数值范围、是否允许空值。对动作参数还要根据 type 动态展示字段:set-flag 需要 key 和 value,give-item 则需要 itemId 和 count,无关字段不应继续留在面板里。
保存前做结构化校验
下面的完整 Python 示例模拟编辑器保存前校验。重点不是 Python 本身,而是验证顺序:先检查基础字段,再检查类型注册,最后检查跨资源引用。
from typing import Any

NODE_TYPES = {"dialogue", "choice"}
CONDITION_TYPES = {"quest-state"}
ACTION_TYPES = {"set-flag", "give-item"}
KNOWN_NODES = {"dlg-forest-001", "dlg-forest-002"}
KNOWN_RESOURCES = {"portrait-guard-neutral", "vo-forest-001"}

node: dict[str, Any] = {
    "id": "dlg-forest-001",
    "type": "dialogue",
    "speaker": "npc_guard",
    "text": "前面的桥已经封锁了。",
    "conditions": [
        {"type": "quest-state", "questId": "quest-rescue", "state": "started"}
    ],
    "actions": [
        {"type": "set-flag", "key": "heard_bridge_warning", "value": True}
    ],
    "resources": {
        "portraitId": "portrait-guard-neutral",
        "voiceId": "vo-forest-001",
    },
    "nextNodeId": "dlg-forest-002",
}

def validate(data: dict[str, Any]) -> list[str]:
    errors: list[str] = []

    if data.get("type") not in NODE_TYPES:
        errors.append("未知节点类型")

    for condition in data.get("conditions", []):
        if condition.get("type") not in CONDITION_TYPES:
            errors.append("未知条件类型")

    for action in data.get("actions", []):
        if action.get("type") not in ACTION_TYPES:
            errors.append("未知动作类型")

    next_node = data.get("nextNodeId")
    if next_node and next_node not in KNOWN_NODES:
        errors.append("下一节点引用不存在")

    for resource_id in data.get("resources", {}).values():
        if resource_id and resource_id not in KNOWN_RESOURCES:
            errors.append(f"资源不存在: {resource_id}")

    return errors

errors = validate(node)
print("校验通过" if not errors else "\n".join(errors))
预期输出:
校验通过实际项目里还应加入字段级错误定位,例如把“资源不存在”关联到具体控件,并阻止发布而不是阻止所有草稿保存。草稿允许不完整,进入测试或发布阶段再执行严格校验,通常更符合策划工作流。
把高级能力藏在受控入口后面
不是所有能力都应该永久显示。分支节点才展示分支条件,带语音的节点才展示语音资源,只有需要延时的动作才展示持续时间。可见性跟随节点类型和动作类型变化,可以显著减少误填。
对于程序风险高的能力,例如执行任意脚本、输入类名、反射调用方法或填写资源路径,最好不要直接开放。更稳妥的方式是由程序注册受控类型和参数定义,编辑器只让策划从白名单里选,并在保存时按同一份定义校验。
用生产流程决定哪些字段真正需要出现
字段是否暴露,应由“策划是否需要做决定”判断,而不是由“运行时对象是否有这个属性”判断。一个字段如果长期由程序固定、可从其他字段推导、只用于缓存,或者修改后会破坏数据一致性,就应从编辑器隐藏。
最终的目标不是字段越多越灵活,而是让策划能完整表达内容,同时把错误尽量提前到编辑和保存阶段。节点、条件、动作、资源、引用五组字段负责表达业务意图,运行时状态留在程序内部,二者之间再通过明确的校验和类型注册表连接。