
图形渲染与 Shader / 系统课时
CPU 粒子和 GPU 粒子怎么选
CPU 粒子和 GPU 粒子怎么选
CPU 粒子和 GPU 粒子的差异不只是性能高低,而是模拟发生的位置、可访问的数据和调试方式不同。本节建立一套选择顺序,让你先看效果需求,再判断粒子规模和瓶颈,避免为了数量盲目切换计算路径。
学习目标
- 理解 CPU 与 GPU 粒子的主要计算路径和能力边界
- 根据粒子数量、交互需求与性能瓶颈选择方案
- 知道两种方案出现问题时应分别检查什么
两条计算路径差在哪里
CPU 粒子通常由 CPU 完成生成、生命周期更新、速度或碰撞等模拟,再把渲染所需数据提交给 GPU。它最大的优势是容易访问游戏世界中的对象和逻辑,也更适合需要逐粒子判断、事件回调或精确控制的效果。
GPU 粒子则把大量粒子的更新交给 GPU 并行执行。CPU 更多负责提供发射参数、资源和少量控制信息,因此在烟雾、火花、雨雪、魔法能量等大规模同类运动中更容易扩展到较高数量。
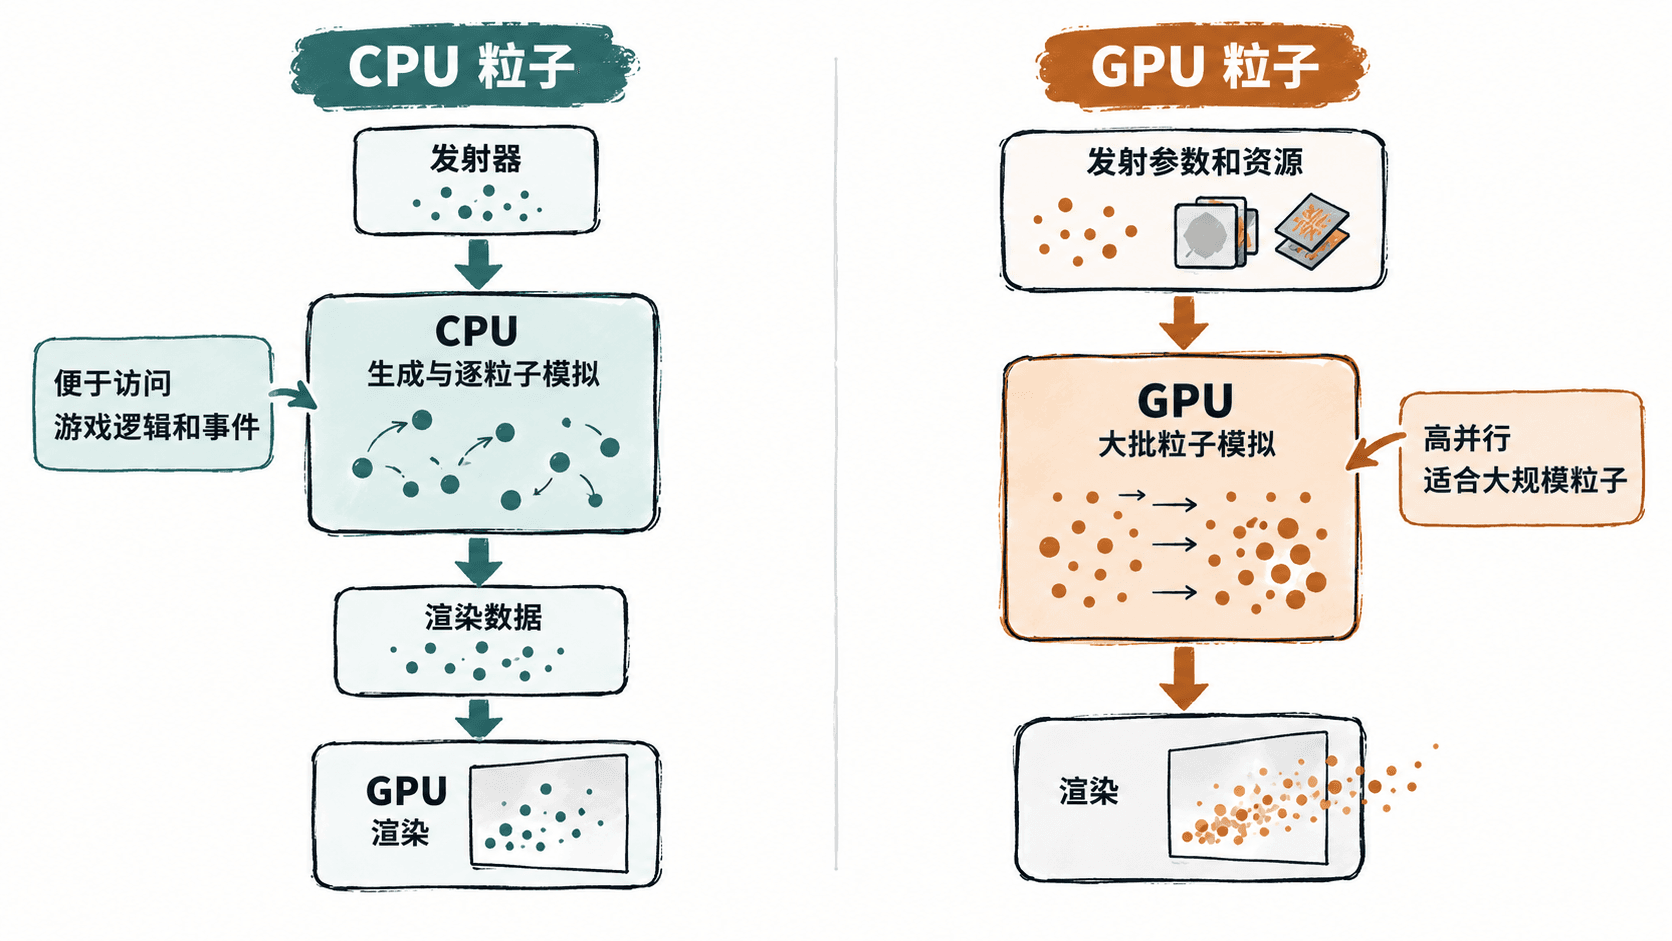
真正重要的是数据在哪里。如果一个效果需要频繁把 GPU 上每个粒子的状态读回 CPU,再驱动游戏对象,那么并行模拟带来的优势可能被同步和读回成本抵消。
先看规模再看交互需求
粒子数量是明显指标,但不能单独决定方案。几十到几千个需要复杂逻辑的粒子使用 CPU 往往更直接;成万甚至更多、运动规则相似且主要承担视觉表现的粒子,更适合考虑 GPU。
| 判断条件 | CPU 粒子更合适 | GPU 粒子更合适 |
|---|---|---|
| 粒子规模 | 中小规模 | 大规模并行 |
| 单粒子逻辑 | 分支多、控制复杂 | 规则统一、计算重复度高 |
| 游戏逻辑交互 | 需要事件、对象查询或精确反馈 | 主要负责视觉表现 |
| 状态读取 | CPU 可直接访问 | 尽量避免频繁回读 |
| 调试需求 | 容易逐粒子检查 | 更依赖统计与可视化分析 |
例如爆炸碎片如果需要命中角色后造成伤害,最好把真正参与玩法判定的对象交给 CPU 或独立游戏逻辑处理,而把大量没有玩法意义的火星交给 GPU。视觉粒子和游戏实体不必强行使用同一套实现。
GPU 粒子并不等于一定更快
GPU 模拟减少了 CPU 更新压力,但最终仍要渲染。大量半透明粒子彼此覆盖时,像素可能被反复混合,瓶颈会从模拟转移到填充率和透明过绘。此时即使 GPU 模拟本身很快,帧率仍可能明显下降。
因此出现性能问题时,应先确认 CPU 帧时间和 GPU 帧时间分别增加了多少。如果 CPU 侧粒子更新占用突出,迁移到 GPU 才有明确方向;如果 GPU 已经被透明渲染压满,继续增加 GPU 粒子只会让问题更严重。
两种方案的调试重点不同
CPU 粒子出现异常时,可以重点检查发射数量、生命周期、更新逻辑、碰撞查询以及事件回调。因为状态位于 CPU,一般更容易在调试器或运行时面板中追踪具体粒子和分支。
GPU 粒子则应优先观察总粒子数、存活数量、渲染批次、GPU 时间、过绘以及模拟缓冲区是否达到上限。某些引擎支持 GPU 粒子调试视图,但能力差异较大,不应预设能够像 CPU 对象一样逐个断点检查。
建立稳定的选择顺序
实际制作时可以先问三个问题:效果是否需要逐粒子参与玩法逻辑,目标规模是否已经让 CPU 更新成为瓶颈,以及最终画面是否受到透明过绘限制。前两个问题决定计算路径,最后一个问题决定即使切换 GPU 后还能否继续扩大规模。
对于复杂特效,常见做法不是二选一,而是混合使用:少量 CPU 粒子承担碰撞、事件和关键反馈,大量 GPU 粒子负责烟尘、火星和氛围层。这样既保留逻辑可控性,也能利用 GPU 的并行能力。