
图形渲染与 Shader / 系统课时
显存与带宽为什么也会拖慢阴影
显存与带宽为什么也会拖慢阴影
阴影性能并不只取决于 Shader 算了多少次。高分辨率 Shadow Map、级联阴影、立方体阴影和多次 PCF 采样都会增加纹理存储与读写流量。当数据规模超过缓存能够有效承载的范围后,GPU 可能花更多时间搬运阴影数据,而不是执行算术指令。
学习目标
- 能估算常见 Shadow Map 的显存占用
- 能理解阴影分辨率、纹理数量和采样次数如何增加带宽压力
- 能通过资源规模与 GPU 时间的联动判断是否存在显存或带宽瓶颈
Shadow Map 首先是一块纹理资源
一张 Shadow Map 本质上通常是深度纹理。它的基础显存占用可以近似看成“宽度 × 高度 × 每像素字节数”。例如一张 4096 × 4096、每像素 4 字节的深度纹理,仅一个切片就约占 64 MiB。
如果方向光使用 4 个级联,并且每个级联都分配独立的 4096 × 4096 深度切片,那么仅这些 Shadow Map 的理论原始存储就接近 256 MiB。实际资源大小还可能受到纹理格式、对齐、压缩方式和驱动分配策略影响,因此估算值主要用于判断量级。
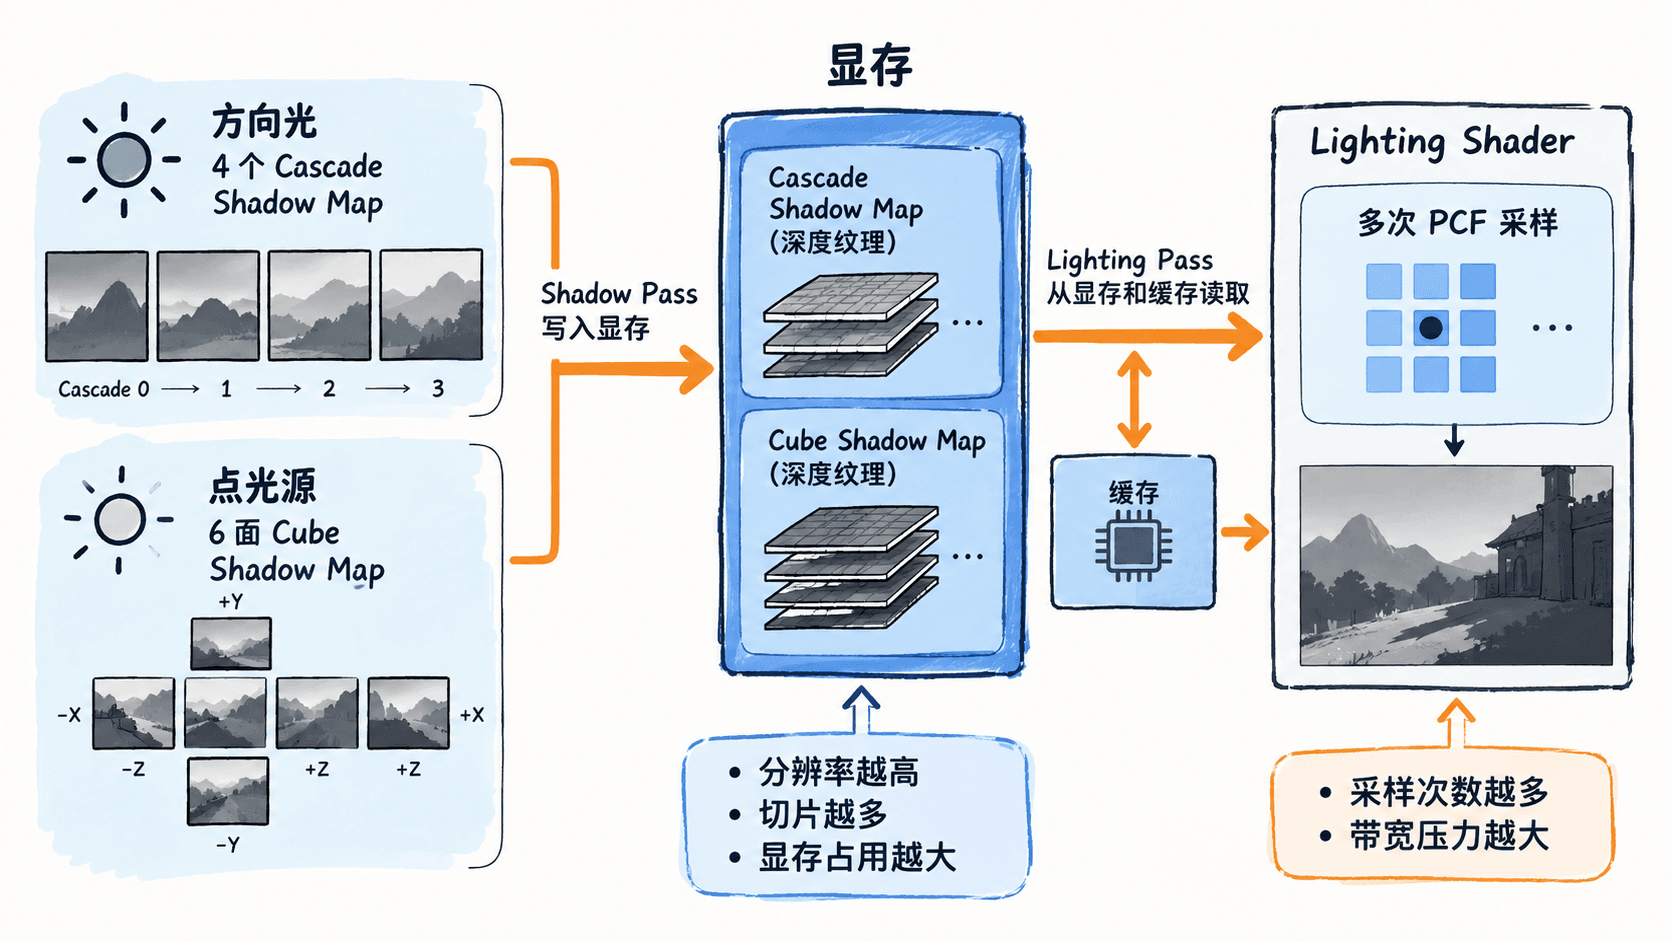
点光源通常比单张二维 Shadow Map 更容易膨胀,因为立方体阴影需要覆盖六个方向。假设六个面都使用 2048 × 2048、每像素 4 字节的纹理,仅一盏灯的原始深度数据量就约为 96 MiB。
用计算先判断资源量级
下面的脚本可以估算二维数组型 Shadow Map 的原始纹理占用。这里不包含驱动额外开销、稀疏资源、压缩或平台特定对齐,因此适合作为性能排查时的第一轮量级估算。
def shadow_memory_mib(width: int, height: int, bytes_per_pixel: int, layers: int) -> float:
    total_bytes = width * height * bytes_per_pixel * layers
    return total_bytes / (1024 * 1024)

csm = shadow_memory_mib(4096, 4096, 4, 4)
point_light = shadow_memory_mib(2048, 2048, 4, 6)

print(f"4-layer CSM: {csm:.1f} MiB")
print(f"6-face point shadow: {point_light:.1f} MiB")
预期输出:
4-layer CSM: 256.0 MiB
6-face point shadow: 96.0 MiB
这个结果不意味着 GPU 每帧一定完整传输 352 MiB,但它说明工作集已经很大。纹理越大,越难完整停留在较小的高速缓存中,Shadow Pass 写入和 Lighting Pass 读取时就更容易形成高带宽流量。
多次采样把读取成本继续放大
Shadow Map 生成之后,Lighting Pass 还要读取它。最简单的阴影比较可能只需要一次深度读取,但 PCF、PCSS 或其他软阴影方法通常会在邻域内取多个样本。每个像素需要的样本越多,对缓存和显存带宽的压力就越高。
例如某个渲染区域有 200 万个需要阴影判断的像素,每个像素执行 16 次阴影采样,那么理论上会产生约 3200 万次纹理采样请求。真实硬件会通过纹理缓存、采样合并和专用单元降低实际外部显存访问量,但采样规模仍然是判断成本的重要信号。
高分辨率 Shadow Map 还可能降低局部访问的缓存命中率。相邻屏幕像素如果映射到相邻阴影纹素,缓存能够复用数据;但当级联切换、投影跨度较大、采样核变宽或多个阴影纹理交替读取时,这种局部性会变差。
如何判断瓶颈更像带宽而不是计算
一个实用方法是做缩放实验。保持 Shader 算法基本不变,只降低 Shadow Map 分辨率,例如从 4096 降到 2048。二维纹理边长减半后,像素数量会下降到原来的四分之一。如果 Shadow Pass 和 Lighting Pass 的 GPU 时间都明显下降,就说明资源尺寸和数据流量很可能参与了瓶颈。
还可以固定 Shadow Map 分辨率,只减少 PCF 核大小或阴影采样次数。如果 Lighting Pass 明显变快,而 Shadow Pass 变化不大,说明成本更集中在读取与过滤阶段。如果只减少投射阴影的物体数量后 Shadow Pass 大幅下降,则几何处理、Draw Call 或深度写入可能比采样带宽更关键。
使用支持硬件计数器的性能分析工具时,可以进一步观察显存读写吞吐、纹理缓存命中率、纹理单元利用率和计算单元利用率。不同 GPU 厂商对指标命名不同,因此不要机械套用某个固定阈值,而应比较同一设备、同一场景在优化前后的变化。
优化时先减少无效数据
阴影资源优化通常优先从工作集规模入手。远处级联不一定需要和近处相同分辨率;静态或低优先级光源也未必需要每帧更新;小面积光源如果屏幕贡献有限,可以降低阴影尺寸或关闭投影。
数组纹理本身并不是问题,它能让资源组织和批处理更方便。真正需要警惕的是数组层数、每层分辨率与更新频率同时增大,使阴影资源长期占据大量显存,并在每帧产生高额读写流量。
判断阴影是否受显存或带宽限制,不应该只看“显存占用了多少”。更可靠的方法是先估算资源量级,再通过降低分辨率、减少切片或降低采样次数做单变量实验,最后观察 GPU 时间和硬件计数器是否同步改善。只有这些证据能够对应起来,才值得把优化重点放在阴影数据规模与带宽上。