
架构与系统设计 / 系统课时
领域模型需要覆盖所有查询吗
领域模型需要覆盖所有查询吗
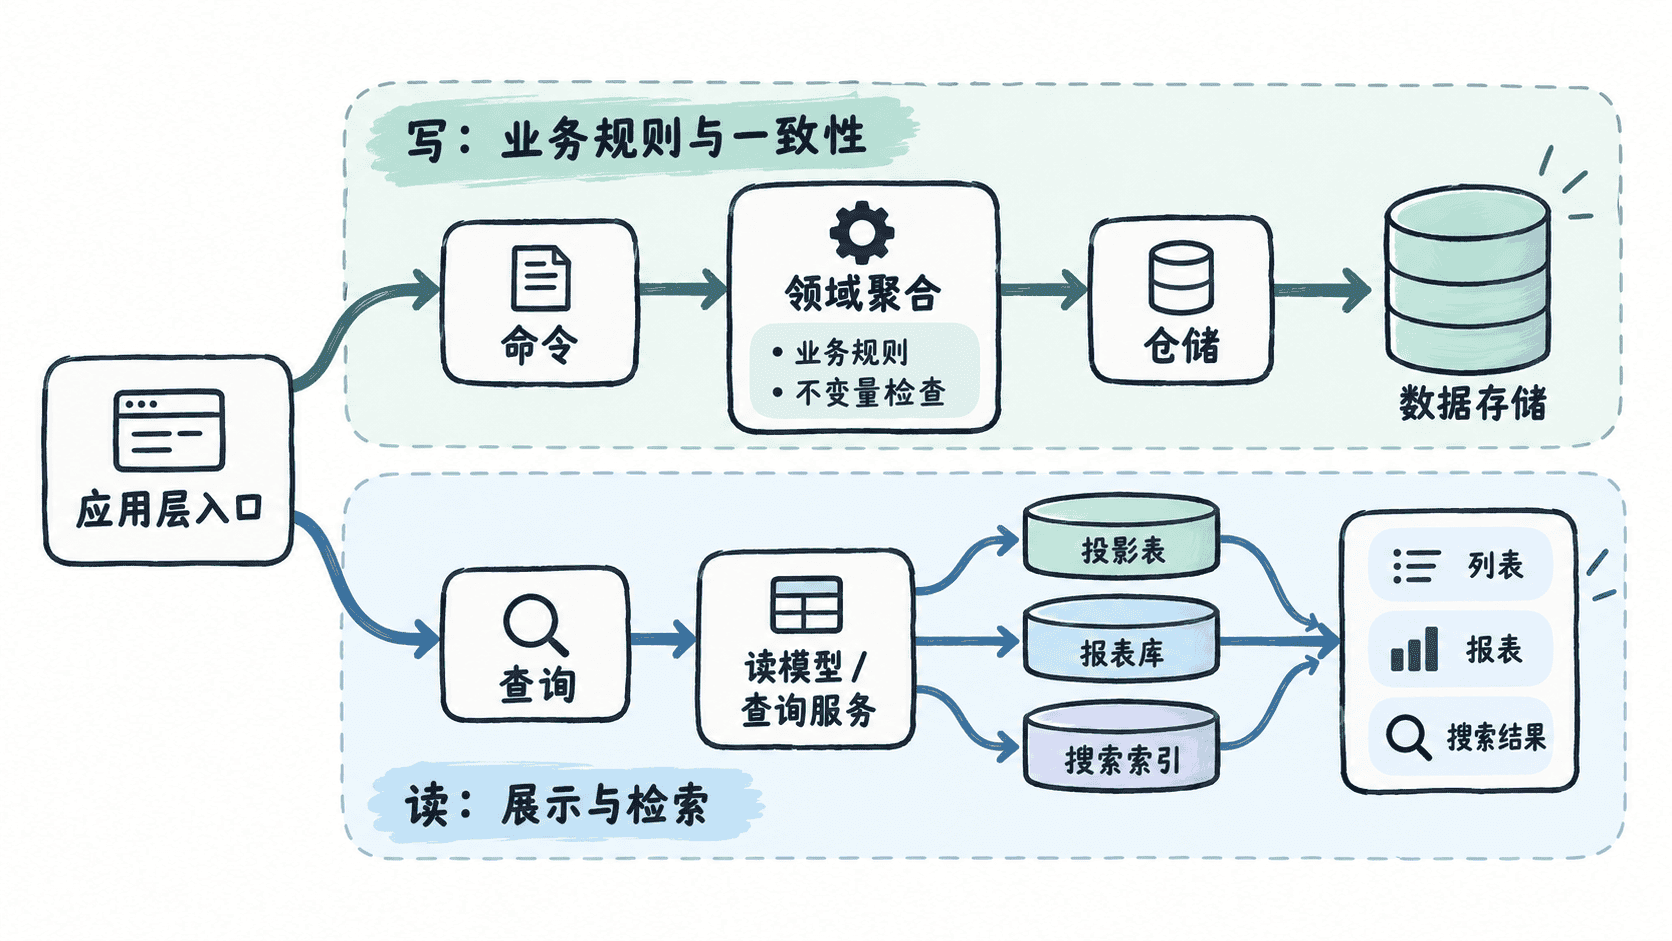
订单列表要展示十几个字段,经营报表要做聚合统计,站内搜索还需要全文检索。若强迫这些读取需求全部经过聚合根,领域模型很快会被展示字段和查询性能拖累。本篇要划清领域模型与查询模型的职责边界,让写模型守住业务规则,让读路径按读取需求独立优化。
学习目标
- 判断一个读取需求是否需要加载完整聚合
- 理解领域模型与查询模型可以采用不同的数据结构
- 避免为了列表、报表和搜索需求扩大或扭曲聚合边界
先区分业务决策和信息读取
领域模型最重要的职责不是提供所有数据,而是表达业务行为、状态变化和必须始终成立的不变量。例如“已取消订单不能再次付款”属于业务规则,执行付款命令时应由领域模型判断。
而“查询最近 30 天订单并显示客户名、商品数和支付状态”主要是在组织信息。它不改变业务状态,也通常不需要借助聚合根维护一致性,因此没有必要先还原一个完整 Order 聚合,再从对象中拼出页面需要的字段。
这两类需求的优化方向不同:写模型追求规则正确和一致性边界清晰,读模型追求检索方便、响应快速以及结果形状贴近界面。
哪些查询通常不必经过聚合
判断重点不是“数据是否来自领域对象”,而是“这次读取是否需要领域对象参与业务决策”。以下需求通常适合单独的查询模型:
| 查询需求 | 更合适的读取方式 | 原因 |
|---|---|---|
| 订单分页列表 | 面向页面的投影或查询表 | 只读取需要展示的列,避免装载整个聚合 |
| 销售统计报表 | 聚合表、分析库或专用 SQL | 统计维度与领域对象结构通常不同 |
| 商品全文搜索 | 搜索索引 | 需要分词、相关性排序等专用能力 |
| 管理后台跨对象检索 | 查询服务或组合视图 | 页面需要的数据可能跨越多个聚合 |
读模型甚至可以包含领域模型中不存在的派生字段,例如 itemCount、customerDisplayName 或月度累计金额。它们服务的是读取场景,不必为了这些字段给聚合根增加属性。
什么时候仍要回到领域模型
如果用例接下来要改变业务状态,仅靠查询结果通常不够。例如页面先查到“订单看起来可以取消”,用户点击取消后,应用层仍应按订单标识加载对应聚合,再调用取消行为,让聚合基于最新状态检查规则。
原因在于查询结果可能已经过期,也可能为了展示而省略了决定业务规则所需的信息。读模型可以帮助用户找到目标,却不应成为修改状态时绕开领域规则的捷径。
不要为了查询需求扩大聚合
常见错误是看到页面需要“一次拿齐数据”,就把客户、商品、支付、物流等对象全部挂到订单聚合中。这样虽然对象导航方便,却会扩大加载范围、增加并发冲突,并把原本独立的业务生命周期错误地绑在一起。
另一个错误是为报表不断给实体增加统计字段和只读 getter。随着报表维度变化,领域对象开始围绕展示结构设计,真正的业务行为反而被淹没。
更稳妥的原则是:聚合边界由业务一致性决定,查询结构由读取场景决定。列表、报表和搜索可以绕过完整聚合直接读取专用模型;真正改变业务状态的命令,再进入领域模型执行规则。这样既不会牺牲领域表达力,也能让查询按照自身的性能和展示需求演进。