
架构与系统设计 / 系统课时
建模为什么必须持续迭代
建模为什么必须持续迭代
领域模型很少能在第一次需求讨论后就设计正确。新的业务例外、实现中的矛盾以及上线后的反馈,都会暴露原有模型对业务理解不足的地方。持续迭代的目的不是频繁重构,而是让模型随着认知增加逐步贴近真实业务。
学习目标
- 理解领域模型为什么无法依靠一次设计完成
- 识别需求讨论、编码和反馈中常见的模型修正信号
- 用小步调整控制模型演化带来的成本
模型天然带着当前认知的边界
建模时掌握的信息总是不完整的。第一次讨论中,业务人员可能只描述正常流程;开发开始后才发现不同状态需要不同规则;真正投入使用后,又可能出现之前没人提出的例外场景。
例如最初把“订单取消”理解为任何未完成订单都可以执行,开发测试时却发现已支付订单需要先发起退款,已发货订单则进入退货流程。此时问题不只是增加两个条件判断,而是原模型中的“取消”概念可能过于宽泛,需要重新区分取消、退款和退货的业务含义。
如果坚持第一次设计不变,新增规则往往会不断堆积在条件分支、服务方法或数据库字段中,模型本身却越来越无法解释业务。
建模发生在讨论、实现和反馈的循环中
领域知识不是只在需求会议中获得的。代码实现会迫使团队面对边界条件,测试会暴露规则冲突,真实用户和运营反馈又会提供新的业务事实。这些信息都应该反过来修正模型。
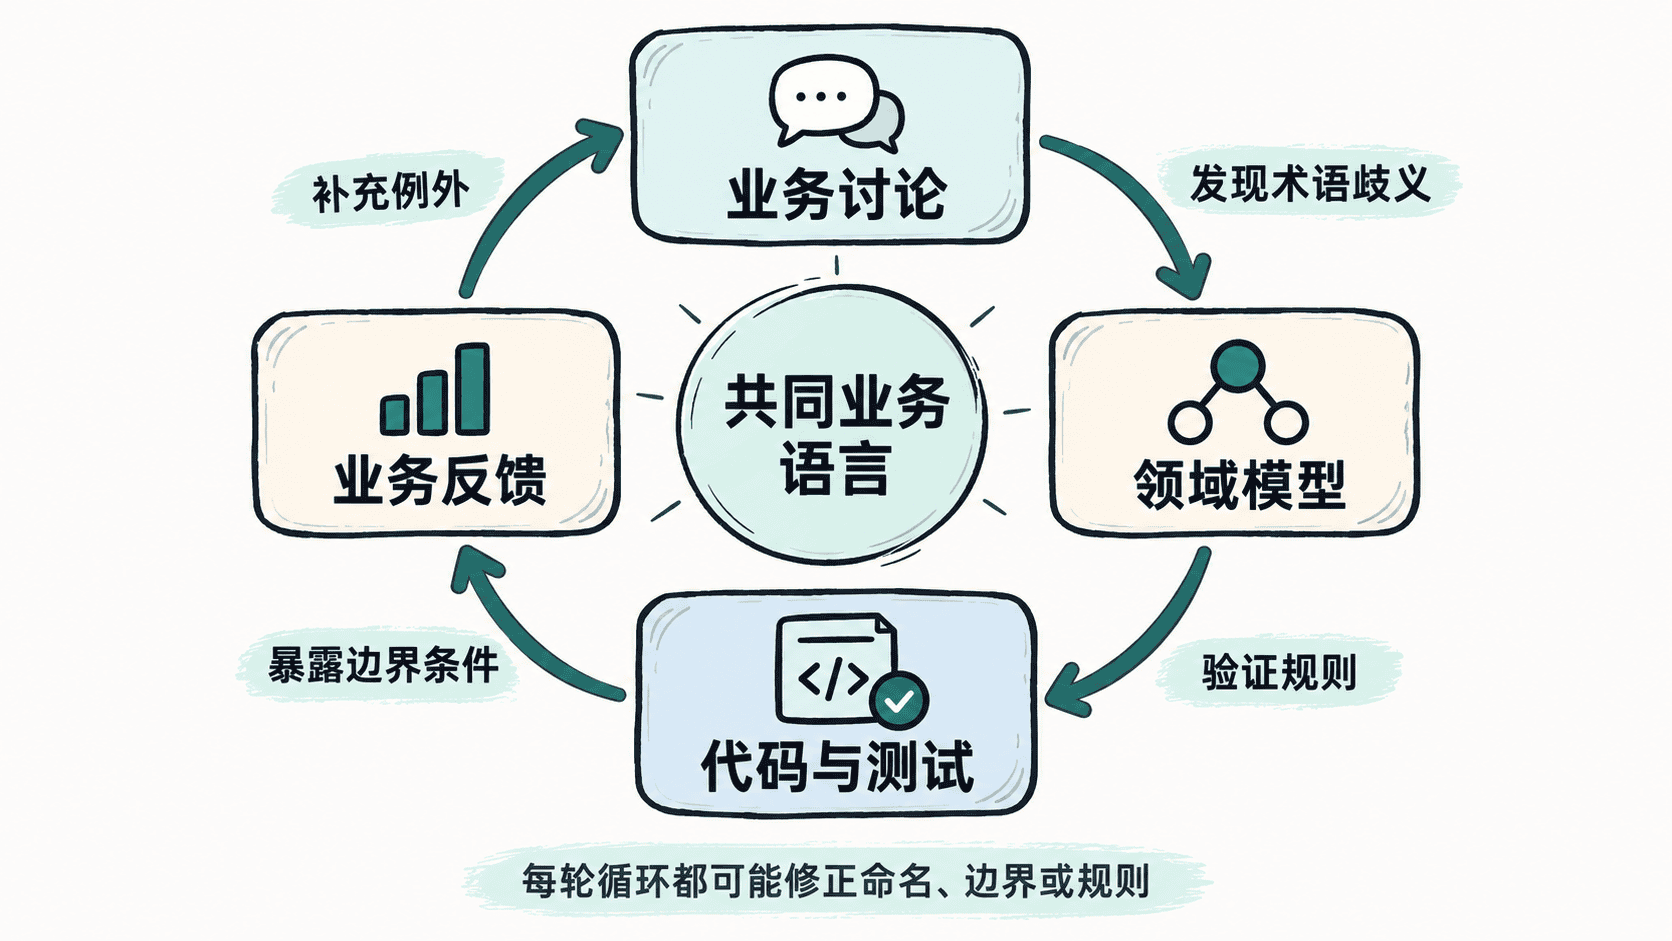
一次常见的迭代可能是:业务讨论得到“预订”概念,模型先认为预订创建后立即生效;实现时发现支付可能失败,于是团队重新确认业务语义,最终将“创建预订”和“确认预订”拆成不同状态或行为。代码没有替代建模,它只是帮助团队发现原有理解中的空白。
每轮迭代重点检查什么
模型演化通常集中在三类问题。首先是命名:同一个词是否被不同角色理解成不同含义,或者两个不同概念是否被错误地使用同一个名字。其次是边界:某条规则究竟应该由哪个对象负责,一组数据和行为是否真的需要保持一致。最后是规则:新的例外是否说明原来的状态、约束或领域行为表达得不够准确。
不是每次需求调整都必须改模型。修改页面布局、增加查询筛选条件或更换消息通知方式,如果没有改变业务事实,通常只需要调整应用层或基础设施。只有业务语言、业务规则或业务边界发生变化时,才值得重新审视领域模型。
用小步演化控制修改成本
持续迭代并不意味着允许模型随意变化。更稳妥的方式是在每次实现一个业务场景时,只修正已经获得证据的问题,同时保持变更范围可验证。
团队可以保留关键业务规则的自动化测试,并在修改模型名称、状态或边界时同步更新测试。对于暂时无法确认的问题,应明确记录假设,而不是为了追求一次性完整设计提前创造大量抽象。等新的业务场景证明抽象确实需要时,再将它引入模型。
什么时候可以暂时停止调整
领域模型没有绝对的“最终版”。更实际的标准是:当前模型能够使用一致的业务语言解释主要场景,关键规则有明确归属,新需求不需要频繁绕过模型才能实现,同时团队知道哪些地方仍然只是暂时假设。
达到这个状态后,就可以停止为了形式上的完美继续重构,把注意力放回业务交付。之后一旦新需求、实现困难或运行反馈提供了新的事实,再启动下一轮建模。持续迭代的价值正在于此:模型不是一次画完的设计图,而是团队对业务理解不断得到验证和修正后的可执行知识。