
架构与系统设计 / 系统课时
聚合之间应该怎样引用
聚合之间应该怎样引用
划分出多个聚合后,一个常见问题是:订单是否应该直接持有完整的客户、商品对象?本节用跨聚合引用说明为什么对象图越完整不一定越好,以及如何用 ID 保持边界清晰,同时仍能完成业务协作。
学习目标
- 判断对象引用是否跨越了聚合边界
- 理解跨聚合直接持有完整对象带来的耦合
- 使用 ID 引用表达聚合之间的关系
聚合内部可以直接引用对象
聚合首先是一致性边界。聚合根需要控制内部实体和值对象,才能保证一次业务操作结束后,整个聚合仍满足不变量。因此,同一聚合内部的对象引用通常是正常且必要的。
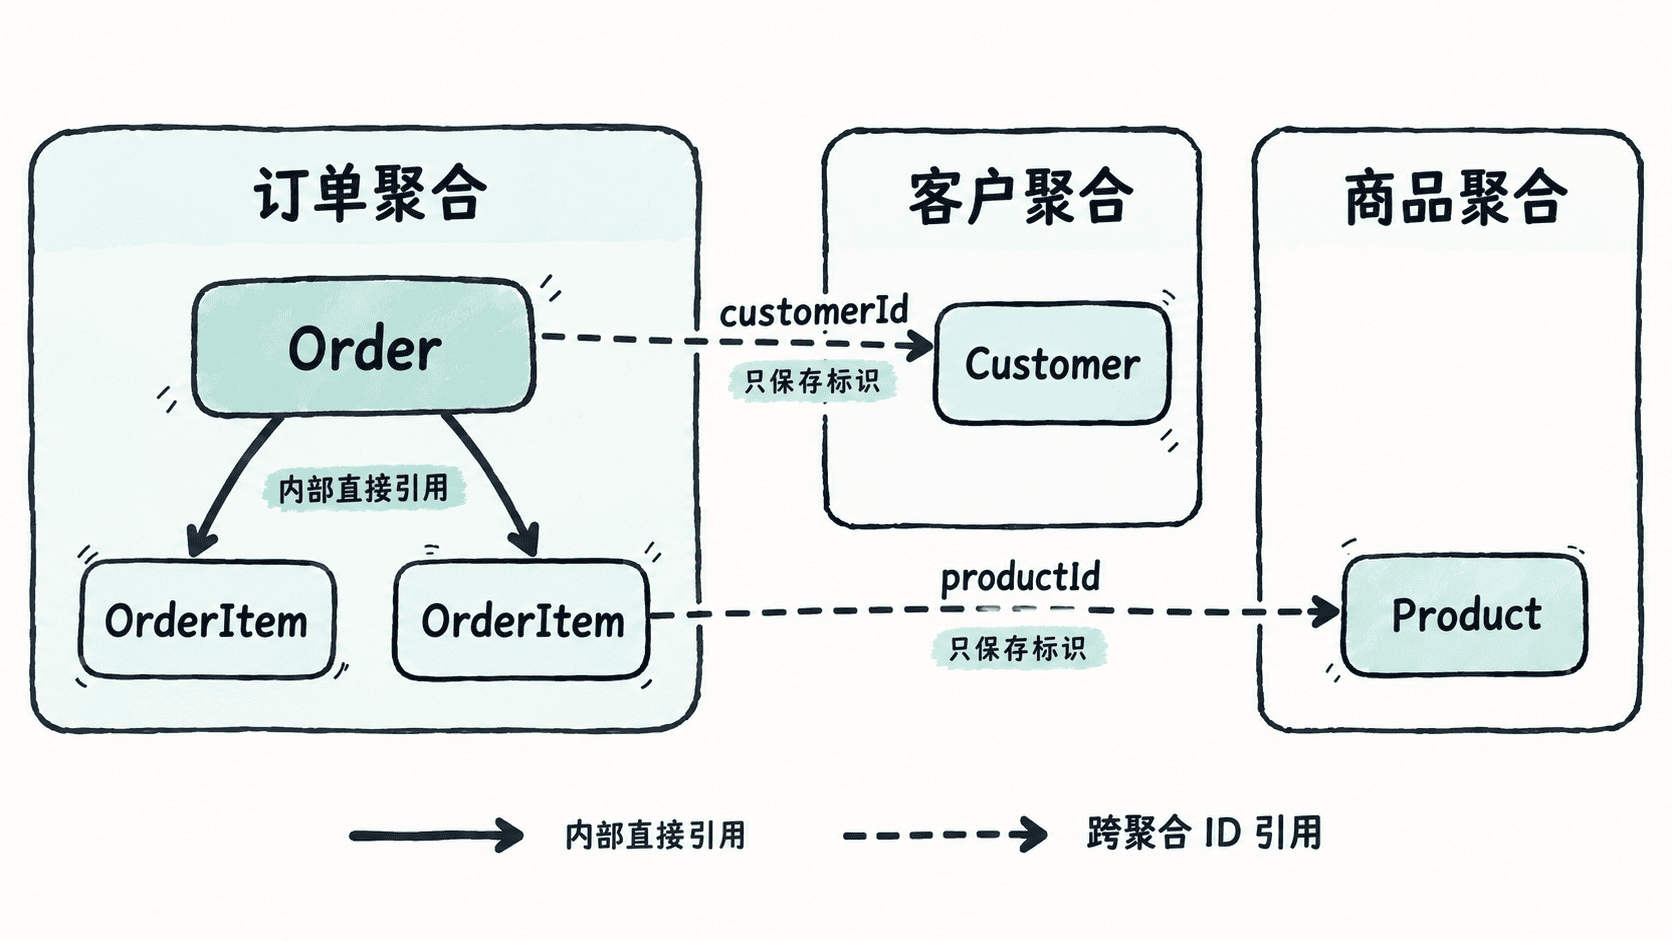
例如订单聚合可以包含订单项,因为修改订单数量时,需要同时检查订单项、订单总额等内部规则。订单根持有订单项,并不会破坏边界,因为这些对象本来就属于同一个一致性范围。
真正需要警惕的是:一个聚合把另一个聚合的根对象直接保存成自己的成员,从而形成跨边界的完整对象图。
完整对象引用为什么容易模糊边界
假设订单聚合直接持有 Customer 和 Product 对象。开发者拿到一个订单后,就可能自然地继续调用客户或商品对象上的修改方法。代码表面上很方便,但业务边界开始变得不清楚:修改订单时,究竟是否允许顺便修改客户资料?保存订单时,是否还需要级联保存商品?
更大的问题是生命周期和一致性被绑在一起。客户与商品通常可以独立存在、独立修改,也可能由不同应用服务加载。如果订单必须长期持有它们的完整对象,就容易把原本独立的聚合误当成一个大对象图管理。
跨聚合通常保存标识
更清晰的做法是让订单保存其他聚合的身份标识,例如 customerId、productId,而不是保存完整的 Customer、Product 聚合对象。这样,模型明确表达的是“订单与某个客户有关”,而不是“客户属于订单的一部分”。
需要读取另一个聚合的信息时,可以由应用服务或领域服务根据 ID 加载对应聚合。当前操作如果只需要客户名称、商品快照等历史信息,还可以把这些信息建模为订单自己的值对象或快照,而不是为了读取几个字段就长期引用外部聚合。
这里的关键不是把所有对象引用机械替换成 ID,而是先问:被引用对象是否与当前聚合共享生命周期和强一致性规则? 如果答案是否定的,它通常应该保持独立,并通过身份建立关系。
ID 引用带来的设计约束
ID 引用会刻意阻止开发者在一次对象遍历中随意修改多个聚合。需要修改客户时,应显式加载客户聚合;需要修改库存时,应显式调用对应业务流程。这种额外步骤正是在提醒代码:已经跨越了一致性边界。
它还使持久化策略更独立。订单仓储只负责恢复订单聚合,无须为了构造订单而递归加载客户、商品等完整对象,避免形成庞大的加载图和隐式级联更新。
什么时候可以传递外部信息
跨聚合协作并不意味着当前聚合不能使用其他聚合提供的信息。区别在于,它不应该因此取得对另一个聚合生命周期的控制权。
例如创建订单时,可以先读取商品聚合得到名称和成交价格,再把需要长期保留的成交信息复制为订单内部的值对象。以后商品名称或标价变化,也不会意外改变已经成立的订单历史。
因此,判断引用方式时可以抓住一个原则:聚合内部通过对象关系维护自己的不变量;聚合之间优先通过身份、事件或显式服务协作。这样既能表达业务关系,又不会把多个独立的一致性边界重新粘成一个大对象图。