
架构与系统设计 / 系统课时
聚合为什么不能设计得太大
聚合为什么不能设计得太大
把很多对象塞进同一个聚合,看上去能减少跨聚合协调,但代价往往是更大的事务、更高的并发冲突和更重的加载成本。本节从并发、事务和性能三个角度说明大聚合为什么会拖累系统,并给出判断聚合是否过大的实际信号。
学习目标
- 能解释大聚合对并发冲突和事务范围的影响
- 能识别由聚合过大引起的加载、持久化与扩展问题
- 能用一致性需求而不是对象数量决定是否拆分聚合
大聚合会扩大并发冲突面
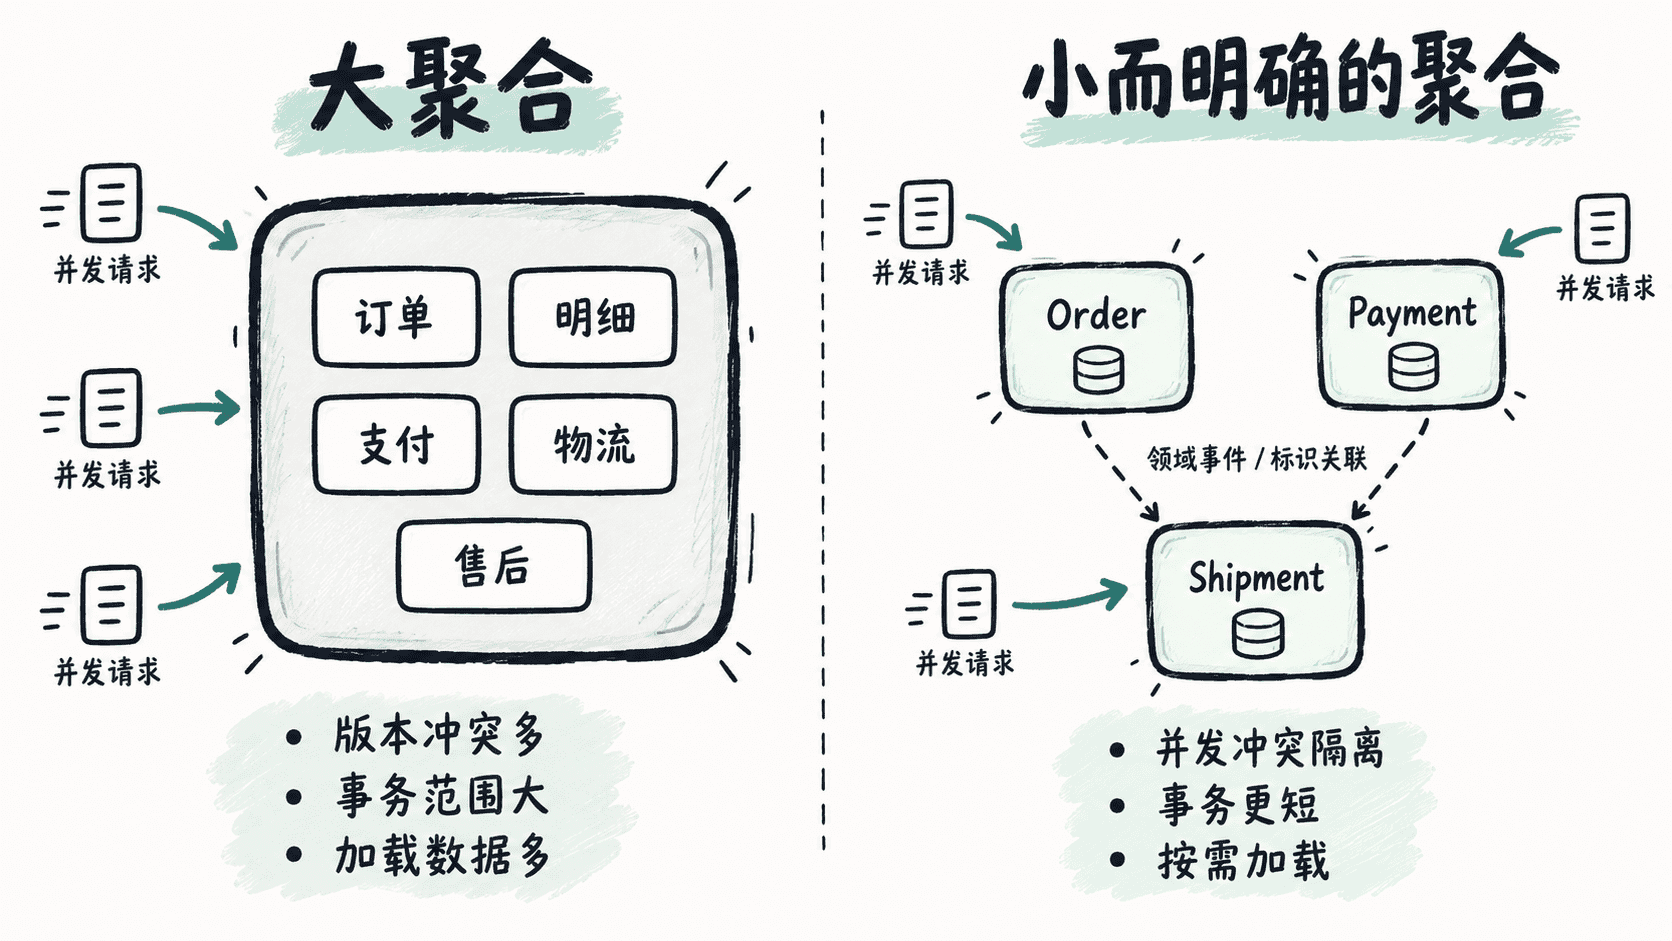
假设把订单、订单明细、支付、物流和售后都设计成一个巨大聚合。此时用户修改收货信息、支付回调更新支付状态、仓库更新发货状态,虽然修改的是不同部分,却可能竞争同一个聚合版本或同一事务边界。
在使用乐观锁时,多个互不相关的更新更容易因为版本号变化而失败重试;使用悲观锁时,锁持有时间和锁覆盖范围也会扩大。结果是业务本来可以并行处理,却被聚合设计人为串行化。
事务越大,失败成本越高
聚合内通常要求一次事务保持一致。边界越大,一次操作涉及的读取、校验和写入越多,事务持续时间就越长,也越容易出现锁等待、回滚成本增加和数据库热点。
更重要的是,大事务会把原本不需要强一致的对象绑在一起。例如订单确认并不一定需要等待物流对象创建完成。如果只是为了“模型看起来完整”就把它们放进一个聚合,会把流程协作问题错误地变成数据库原子事务问题。
性能问题通常从读写放大开始出现
大聚合还容易让持久化成本失控。一次只想修改订单备注,如果仓储层总是需要加载几十条明细、支付记录和物流轨迹,读成本会明显增加;如果 ORM 还执行级联脏检查,写入路径也会变重。
可以用下表观察典型差异:
| 维度 | 大聚合常见表现 | 边界更聚焦时 |
|---|---|---|
| 并发 | 不相关修改互相冲突 | 冲突限制在真正共享状态内 |
| 事务 | 一次提交涉及对象多、持续更久 | 事务更短,失败影响更局部 |
| 加载 | 经常读取当前操作不需要的数据 | 按聚合职责加载必要状态 |
| 扩展 | 热点集中,难以独立伸缩 | 不同聚合可按负载分别处理 |
这些问题并不意味着“聚合越小越好”。如果拆分后导致关键不变量只能靠异步补偿才能维持,就可能把本该强一致的规则拆坏。
用强一致需求决定拆分位置
判断是否应该拆分,一个实用方法是逐条列出当前聚合必须维护的不变量,然后检查每条不变量是否真的跨越所有对象。如果订单只需要保证“总金额与订单明细一致”,支付只需要保证“支付状态转换合法”,物流只需要保证“配送状态顺序合法”,它们通常没有必要共享一个聚合边界。
拆分后,聚合之间只保存对方标识,并通过应用服务、领域事件或消息完成协作。这样做接受的是“跨聚合不能依赖单个数据库事务”的事实,换来更小的冲突范围和更清晰的职责。
判断聚合是否过大,不要先数实体数量,而要看是否出现了无关操作互相冲突、事务被迫覆盖太多对象、读取大量无关数据等信号。只要某个对象不是维护当前不变量所必需,就应该认真评估它是否真的属于这个一致性边界。