
C / C++ / 系统课时
检查容器选择和迭代器安全
检查容器选择和迭代器安全
内存版商品索引系统能跑起来后,还要检查它在数据增长、删除和重建索引时是否仍然正确。本节从查找复杂度、索引一致性和迭代器失效三个角度复核设计,并把“顺序存储加脆弱二级索引”调整为更适合按商品 ID 查询的主存储结构。
学习目标
- 根据主要操作的复杂度选择
vector或unordered_map - 识别
vector扩容、插入和删除造成的迭代器失效 - 用单一主索引和按需排序快照降低索引不同步风险
先看原设计的风险
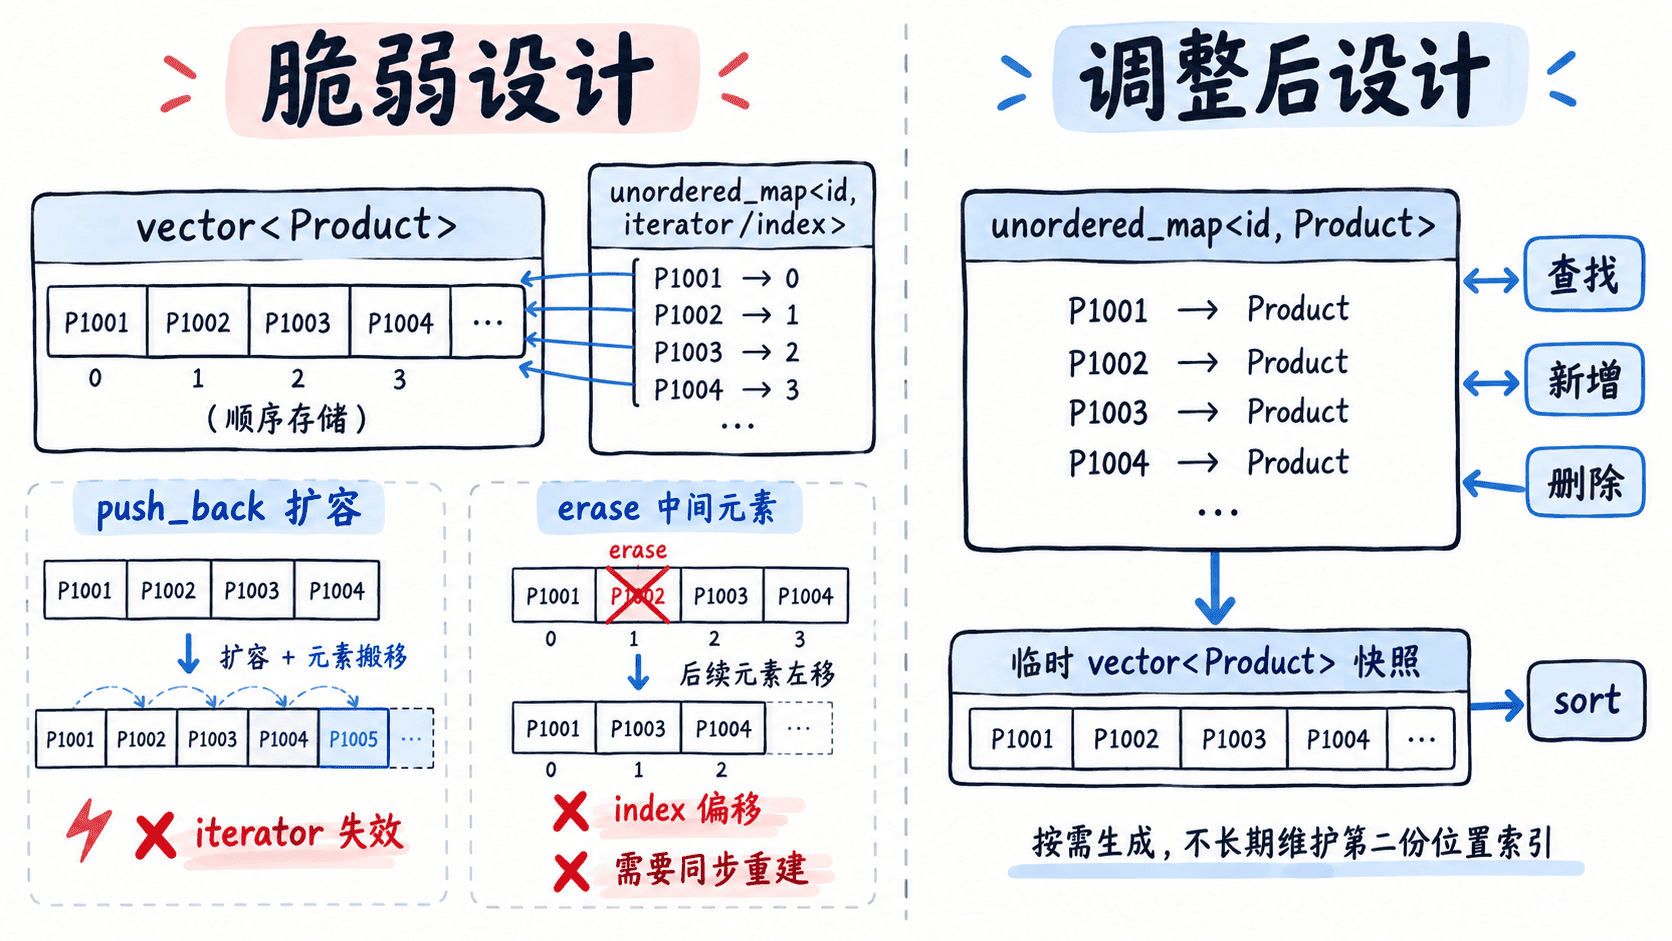
如果商品主数据放在 vector<Product> 中,又用 unordered_map<int, std::vector<Product>::iterator> 保存商品 ID 到迭代器的映射,看似能把查找从 降到平均 ,但 vector 一旦扩容,原有迭代器就可能全部失效;在中间位置执行 erase 时,被删位置及其后的迭代器也都会失效。
即使二级索引保存的是数组下标而不是迭代器,删除或插入后下标仍可能整体偏移。这样系统必须在每次结构性修改后同步更新索引,维护成本会随着操作种类增加。
按核心操作重新选容器
如果系统最频繁的操作是“按商品 ID 精确查找、添加、删除”,unordered_map<int, Product> 更贴合访问模式:这三类操作平均都是 ,商品 ID 也天然成为唯一键。代价是容器本身不维护业务排序;需要按价格或名称展示时,可以临时复制到 vector 后调用 sort。
| 操作 | vector<Product> |
unordered_map<int, Product> |
|---|---|---|
| 按 ID 查找 | 平均 | |
| 尾部新增 | 摊销 | 平均 |
| 按 ID 删除 | 查找加移动, | 平均 |
| 保持连续顺序 | 天然适合 | 不保证遍历顺序 |
| 排序展示 | 可直接 sort |
先生成快照再排序 |
因此容器选择不是“哪个更快”的泛化判断,而是让主要操作直接落在容器擅长的访问模式上。
用单一主索引实现目录
下面的程序把 unordered_map 作为商品唯一主存储。排序结果使用值拷贝生成临时快照,不把容器内部迭代器长期暴露给外部,因此后续插入、删除或 rehash 不会让调用方持有悬空迭代器。
#include <algorithm>
#include <iostream>
#include <string>
#include <unordered_map>
#include <utility>
#include <vector>

struct Product {
    int id;
    std::string name;
    int price;
};

class Catalog {
public:
    bool add(Product product) {
        int id = product.id;
        return products_.emplace(id, std::move(product)).second;
    }

    bool erase(int id) {
        return products_.erase(id) == 1;
    }

    const Product* find(int id) const {
        auto it = products_.find(id);
        return it == products_.end() ? nullptr : &it->second;
    }

    std::vector<Product> sortedByPrice() const {
        std::vector<Product> snapshot;
        snapshot.reserve(products_.size());

        // 快照与主索引解耦,排序不会修改哈希表内部结构。
        for (const auto& [id, product] : products_) {
            snapshot.push_back(product);
        }

        std::sort(
            snapshot.begin(), snapshot.end(),
            [](const Product& a, const Product& b) {
                if (a.price != b.price) {
                    return a.price < b.price;
                }
                return a.id < b.id;
            }
        );
        return snapshot;
    }

private:
    std::unordered_map<int, Product> products_;
};

int main() {
    Catalog catalog;
    catalog.add({1001, "Mouse", 129});
    catalog.add({1002, "SSD", 499});
    catalog.add({1003, "Keyboard", 259});

    if (const Product* p = catalog.find(1002)) {
        std::cout << "find 1002: " << p->name << '\n';
    }

    std::cout << std::boolalpha
              << "removed 1001: " << catalog.erase(1001) << '\n';

    for (const auto& p : catalog.sortedByPrice()) {
        std::cout << p.id << ' ' << p.name << ' ' << p.price << '\n';
    }
}
预期输出
find 1002: SSD
removed 1001: true
1003 Keyboard 259
1002 SSD 499
重新检查迭代器规则
vector 的迭代器稳定性与容量和修改位置有关:扩容会使全部迭代器、引用和指针失效;未扩容的尾部插入不会影响已有元素,但中间插入或删除会使修改位置及其后的迭代器失效。因此不要把 vector 迭代器当作长期索引保存。
unordered_map 在 rehash 时会使迭代器失效,但对仍存在元素的引用和指针保持有效;删除元素只会使被删除元素相关的迭代器、引用和指针失效。即便如此,业务层长期保存容器内部位置仍会增加生命周期耦合,更稳妥的接口通常是传商品 ID,查询时再定位。
完成这次复核后,商品 ID 成为单一事实来源;排序只产生临时视图,不再维护一个容易漂移的长期位置索引。这样复杂度和迭代器规则都更容易推导,后续新增删除逻辑也更不容易破坏索引一致性。