
C / C++ / 系统课时
哈希值怎样定位元素位置
哈希值怎样定位元素位置
unordered_map 查找看起来像“直接找到键”,实际要经过哈希函数、桶定位和桶内键比较。理解这条路径后,就能解释哈希冲突为什么不会覆盖元素,以及 load_factor 为什么会影响平均查找成本。
学习目标
- 理解哈希值、桶索引与元素定位之间的关系
- 说明哈希冲突发生后容器如何继续区分不同键
- 理解
load_factor、max_load_factor与重新哈希的关系
从键到桶要经过两步
查找一个键时,容器会先调用哈希函数得到一个 std::size_t 类型的哈希值,再根据当前桶数量把它映射到某个桶。具体映射公式属于实现细节,不能假定一定等于简单的“哈希值取模桶数”。
定位到桶后,容器仍要比较键是否真正相等。原因是哈希值不是唯一编号:不同键可能产生相同哈希值,也可能被映射到同一个桶,这就是哈希冲突。
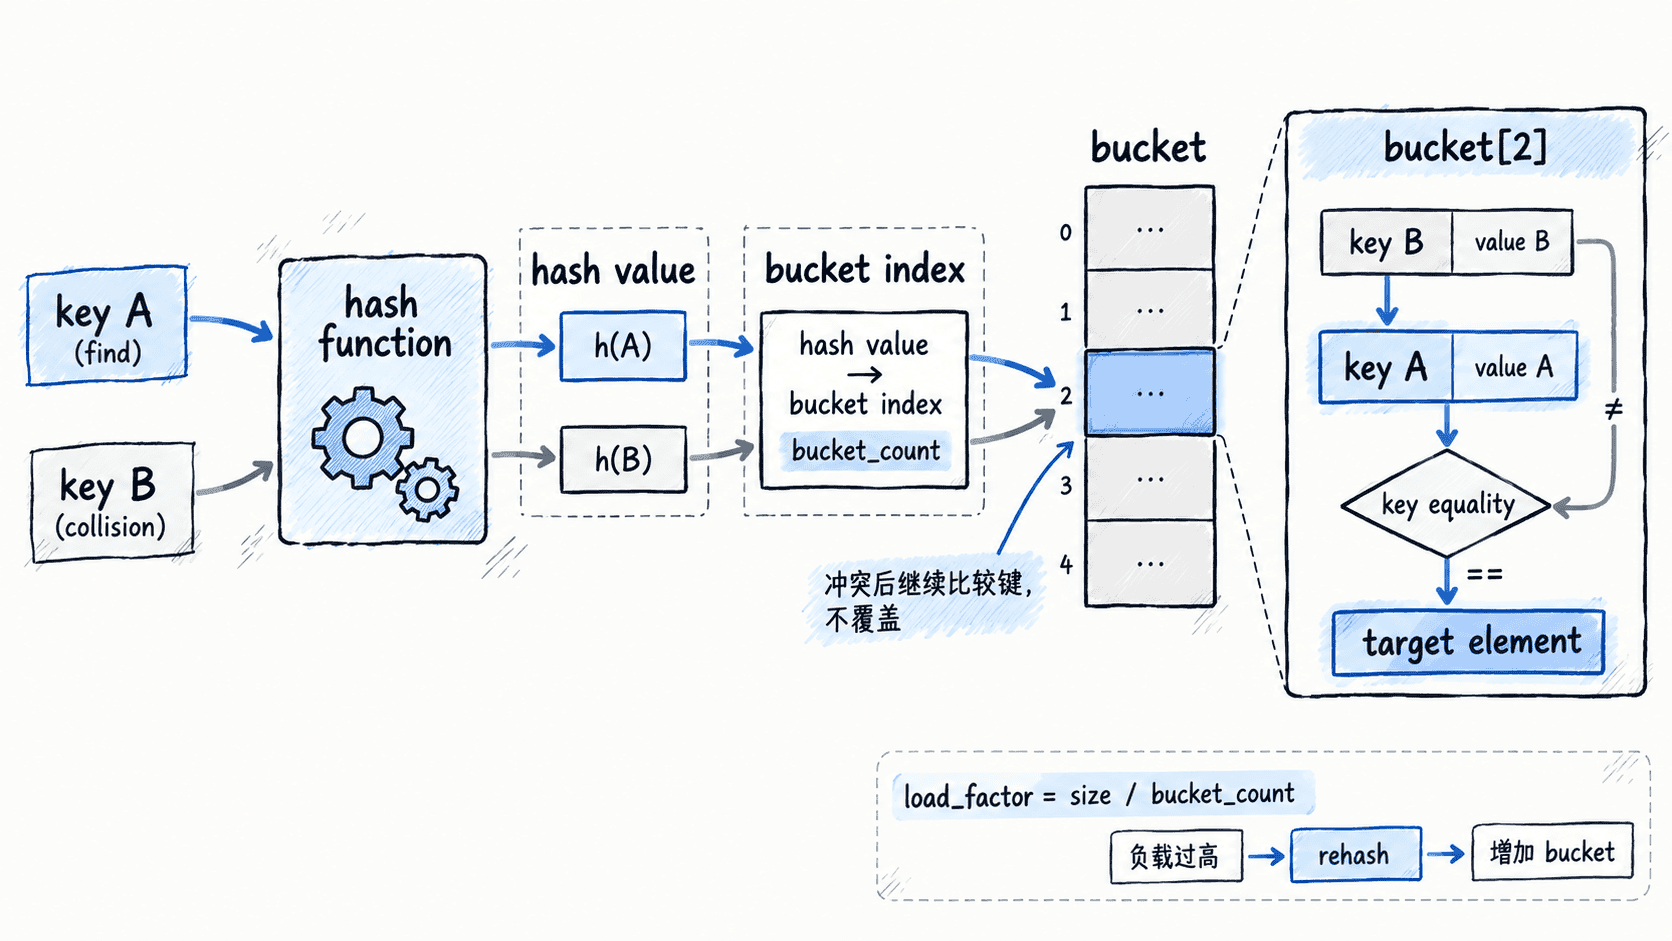
因此,哈希表的查找不是“哈希值相同就命中”,而是“哈希值帮助缩小到桶,再由键相等判断完成确认”。自定义键类型时,哈希函数与相等判断必须保持一致:如果两个键被认为相等,它们必须产生相同哈希值。
冲突不会让后插入元素覆盖前一个
下面故意把所有字符串的哈希值都设为 0,制造最极端的冲突。三个键会落入同一桶,但容器仍能通过键比较分别找到它们。
#include <cstddef>
#include <iostream>
#include <string>
#include <unordered_map>

struct ConstantHash {
    std::size_t operator()(const std::string&) const noexcept {
        // 教学用:故意让所有键产生相同哈希值。
        return 0;
    }
};

int main() {
    std::unordered_map<std::string, int, ConstantHash> scores;
    scores.emplace("alice", 88);
    scores.emplace("bob", 91);
    scores.emplace("carol", 95);

    bool sameBucket =
        scores.bucket("alice") == scores.bucket("bob");

    std::cout << std::boolalpha;
    std::cout << "same bucket: " << sameBucket << '\n';
    std::cout << "alice=" << scores.at("alice") << '\n';
    std::cout << "bob=" << scores.at("bob") << '\n';
    std::cout << "size=" << scores.size() << '\n';
}
预期输出
same bucket: true
alice=88
bob=91
size=3
这个示例说明冲突只意味着更多元素共享同一桶,不代表键值对被覆盖。真正的问题是:桶里元素越多,桶内比较次数通常越多,平均 O(1) 的优势就会减弱。
load_factor 衡量桶有多拥挤
unordered_map::load_factor() 表示平均每个桶承载多少个元素,关系可以写成:
负载因子较低时,元素通常更分散;负载因子升高时,冲突概率和桶内比较成本通常也会增加。容器会参考 max_load_factor() 决定何时扩大桶数组并重新分配元素,这个过程称为 rehash。
可以用 reserve(n) 提前为预计的元素数量准备容量,减少批量插入期间反复 rehash 的次数;也可以用 max_load_factor(x) 调整允许的最大负载因子。它们是性能调节工具,不应为了追求更低负载而无限增大桶数量,因为更多桶通常意味着更多内存开销。
观察哈希容器时该看什么
排查 unordered_map 性能时,不要只看元素个数。bucket_count()、load_factor()、max_load_factor() 能帮助判断当前桶是否过于拥挤,而 bucket(key) 可以查看某个键所在的桶。若自定义哈希函数导致大量键集中到少数桶,即使负载因子表面正常,局部冲突仍可能很严重。
哈希查找快的前提是“键能比较、哈希分布合理、桶数量与数据规模匹配”。哈希值只是定位线索,桶和键相等判断共同完成最终查找。