
C / C++ / 系统课时
binary_search 为什么要求有序
binary_search 为什么要求有序
std::binary_search 能用很少的比较判断元素是否存在,但它并不会扫描整个容器。算法之所以快,正是因为它假定区间已经按照同一套比较规则排好序,从而能在每次比较后安全地排除一半候选范围。
学习目标
- 使用
std::binary_search判断有序区间中是否存在目标值 - 理解二分查找为什么依赖有序区间,以及比较规则不一致会发生什么
- 正确处理降序排列、自定义比较器和重复元素
binary_search 实际依赖什么
假设升序序列中间位置的值是 7,目标值是 4。因为左侧元素都不大于 7,右侧元素都不小于 7,算法才能判断目标只可能位于左半区。下一轮继续对剩余区间做同样判断,候选范围会不断缩小。
如果区间没有按照查找所使用的比较规则排列,中间元素就无法代表左右两侧的关系。此时即使目标真实存在,算法也可能把包含目标的那一半直接排除。
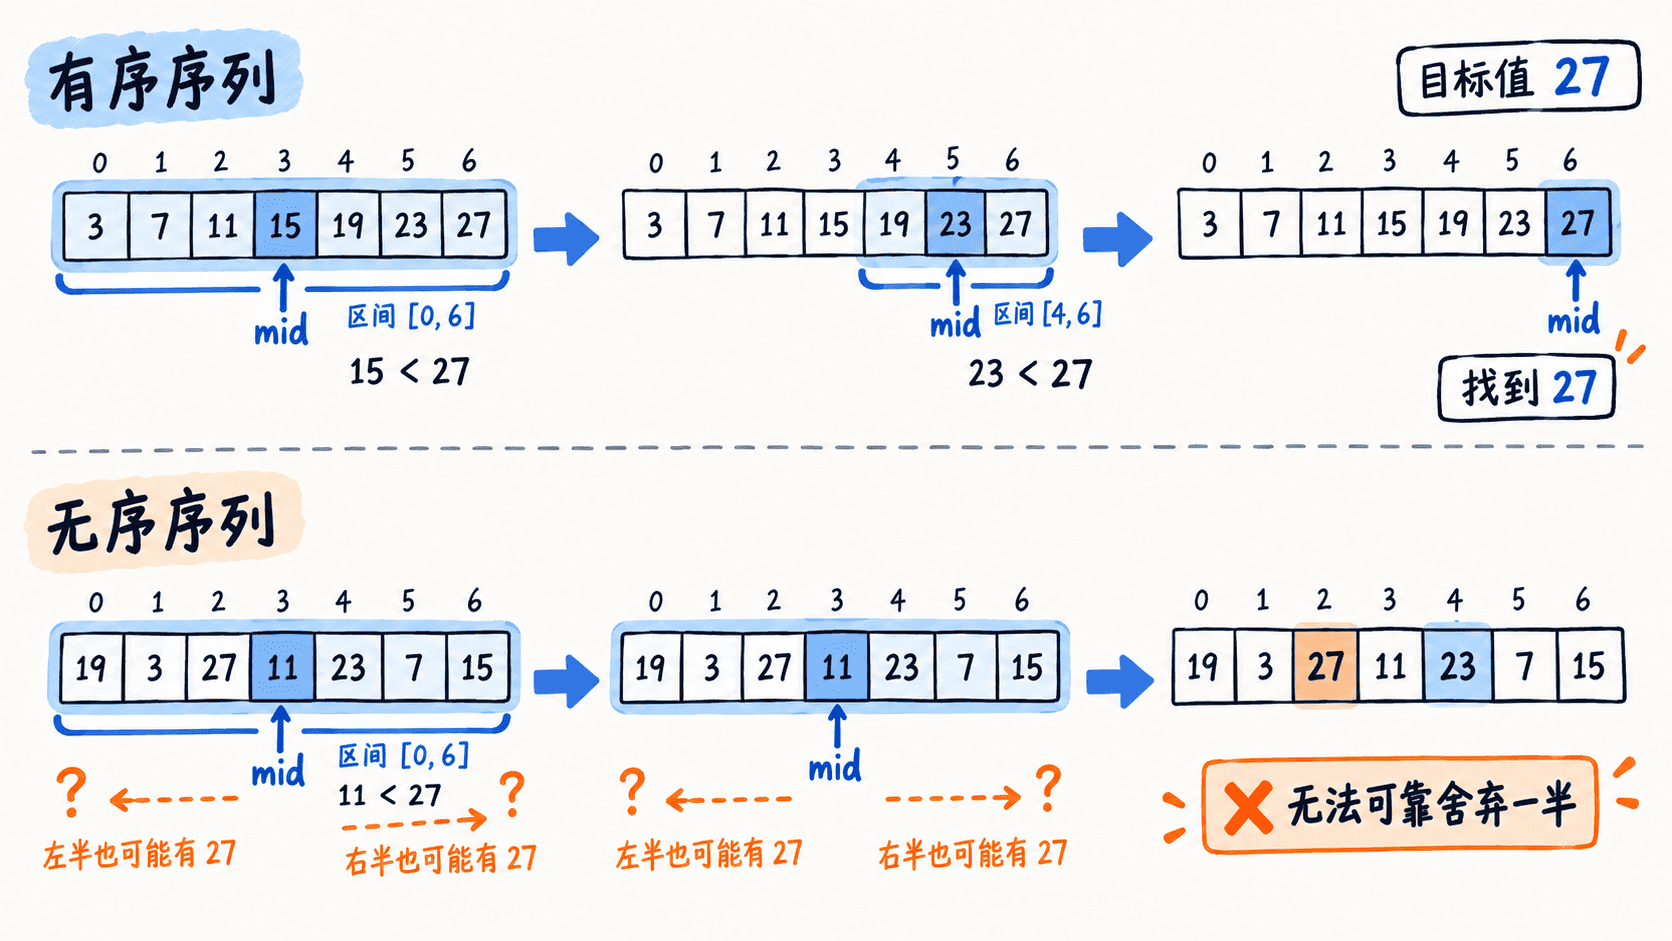
因此,所谓“要求有序”更准确地说,是区间必须满足 binary_search 所采用的排序关系。最常见的做法是先用 std::sort 排序,并在排序和查找时使用相同的比较器。
用相同规则排序和查找
下面把整数按降序排列。排序使用 std::greater<int>,查找时也必须使用同一排序关系。
#include <algorithm>
#include <functional>
#include <iostream>
#include <vector>

int main() {
    std::vector<int> nums{3, 9, 1, 7, 5, 7};

    // 区间按降序规则排列,后续查找必须保持相同规则。
    std::sort(nums.begin(), nums.end(), std::greater<int>{});

    std::cout << std::boolalpha;
    std::cout << "contains 7: "
              << std::binary_search(nums.begin(), nums.end(), 7,
                                    std::greater<int>{}) << '\n';
    std::cout << "contains 4: "
              << std::binary_search(nums.begin(), nums.end(), 4,
                                    std::greater<int>{}) << '\n';
}
预期输出:
contains 7: true
contains 4: false
这里存在两个 7 并不会造成问题。binary_search 只回答“是否至少存在一个等价元素”,不会告诉你元素的位置或出现次数。
比较规则必须保持一致
如果数据使用 std::greater<int> 排成降序,却调用不带比较器的 binary_search,默认升序比较关系与当前区间不一致。算法的有序前提已经被破坏,得到的结果不能依赖。
自定义比较器还应满足严格弱序关系。典型比较器使用 <、> 或按字段进行类似比较,而不是用 <=、>= 表示“排在前面”。后者会让相等元素也被判定为存在先后关系,破坏标准排序与二分算法需要的比较语义。
为什么它比线性查找快
对支持随机访问的有序区间,例如 std::vector,每次比较大约都能排除一半候选元素。包含 个元素时,需要的比较次数是 ;而 std::find 在最坏情况下要检查全部元素,为 。
这也解释了什么时候不该为了使用 binary_search 临时排序。如果数据只查一次,而排序本身需要 ,直接线性查找可能更简单。只有数据已经有序,或者同一批数据会执行大量查询时,维护有序区间并使用二分查找才更有价值。
最后还要区分“存在性”和“位置”。只需要知道目标有没有出现时用 binary_search;需要找到插入点、第一个匹配位置或一组重复值的边界时,应使用 lower_bound、upper_bound 等边界算法。