
C / C++ / 系统课时
设计商品对象和容器结构
设计商品对象和容器结构
这一节先不急着实现完整功能,而是从“顺序展示、按编号查询、按分类过滤”三种访问方式反推数据结构。最终得到一个适合小型内存商品索引系统的模型:vector 保存完整商品,哈希容器只保存查询索引。
学习目标
- 定义能够支持展示与查询的
Product商品类型 - 根据不同访问方式选择
vector、unordered_map和unordered_multimap - 理解“主数据只存一份,索引保存位置”的设计边界
先从访问需求反推容器
同一批商品会被不同方式访问。顺序展示要求保留插入顺序,按编号查询要求快速定位唯一商品,按分类过滤则需要一个分类对应多个商品。
| 需求 | 合适容器 | 原因 |
|---|---|---|
| 顺序展示全部商品 | vector<Product> |
连续存储,遍历简单,尾部追加高效 |
| 按商品编号查询 | unordered_map<int, size_t> |
编号唯一,可平均常数时间查到位置 |
| 按分类过滤 | unordered_multimap<string, size_t> |
同一分类允许对应多个位置 |
这里让两个哈希容器保存 vector 下标,而不是再复制一份 Product。这样商品名称、价格等字段只有一个权威来源,修改时不会出现多份数据不一致。
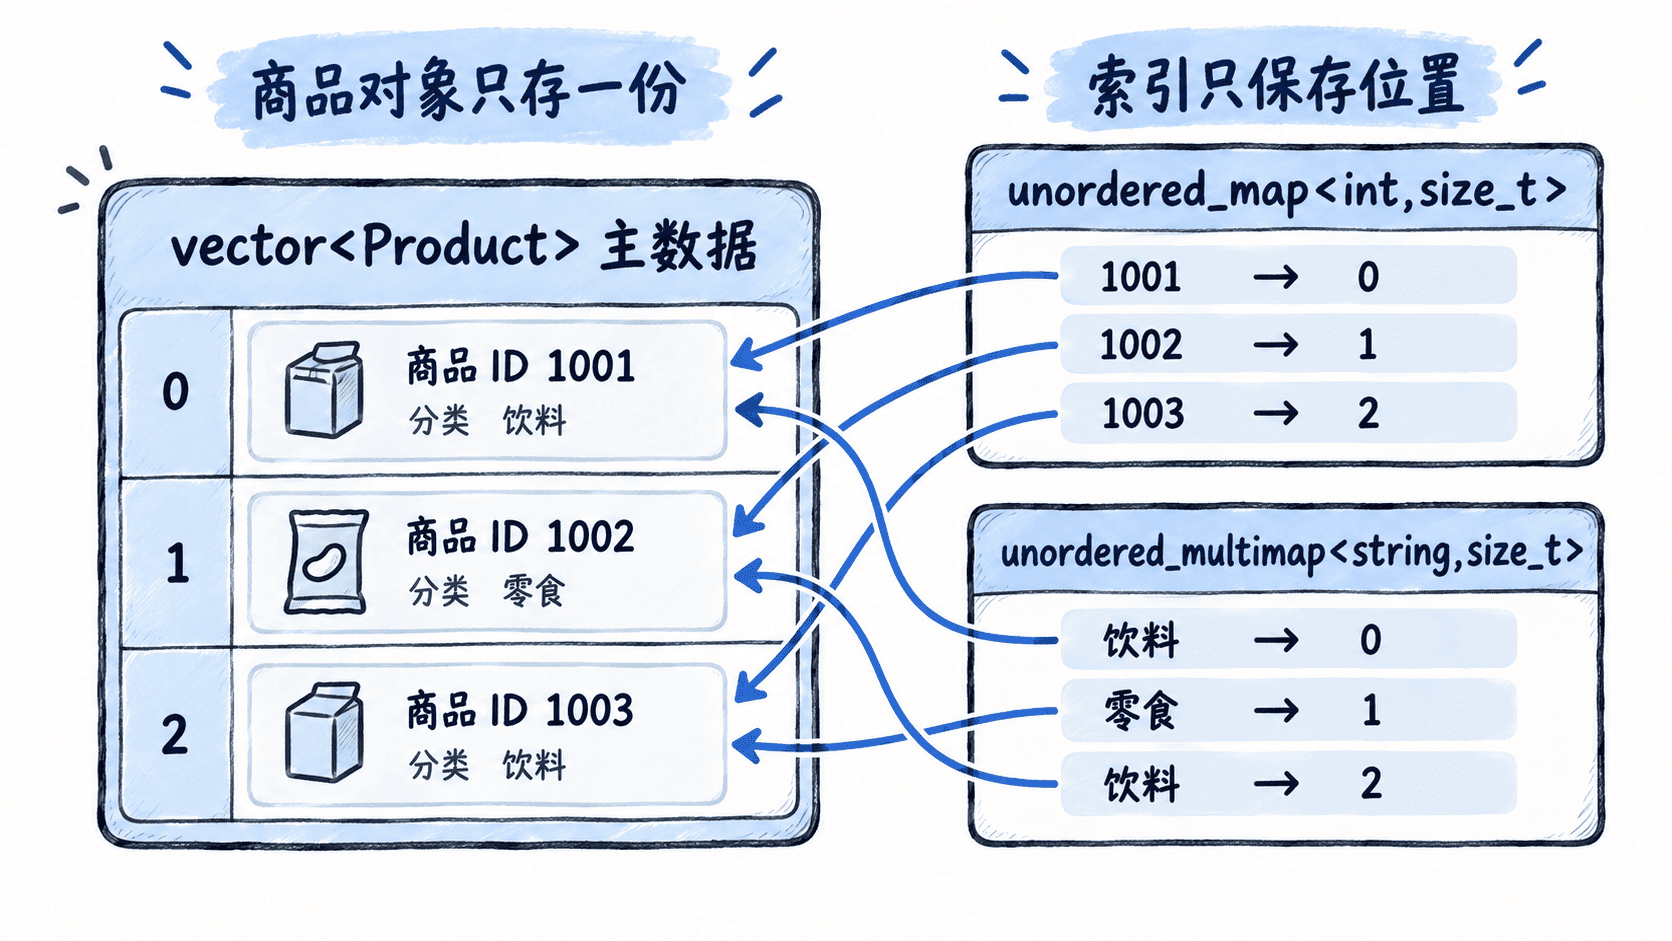
定义最小商品类型
商品对象只保留当前需求真正会使用的字段:编号、名称、分类和价格。下面的程序同时建立两个索引,并演示编号查询和分类计数。
cpp
#include <iostream>
#include <string>
#include <unordered_map>
#include <vector>

struct Product {
    int id;
    std::string name;
    std::string category;
    double price;
};

int main() {
    std::vector<Product> products{
        {101, "机械键盘", "外设", 299.0},
        {102, "美式咖啡", "饮料", 15.5},
        {103, "气泡水", "饮料", 6.0}
    };

    std::unordered_map<int, std::size_t> idIndex;
    std::unordered_multimap<std::string, std::size_t> categoryIndex;

    // 索引保存 vector 下标,商品对象本身仍只存在于 products 中。
    for (std::size_t i = 0; i < products.size(); ++i) {
        idIndex.emplace(products[i].id, i);
        categoryIndex.emplace(products[i].category, i);
    }

    const auto idIt = idIndex.find(102);
    if (idIt != idIndex.end()) {
        const Product& product = products[idIt->second];
        std::cout << "ID 102: " << product.name << ", " << product.price << '\n';
    }

    std::cout << "饮料数量: " << categoryIndex.count("饮料") << '\n';
}
预期输出
text
ID 102: 美式咖啡, 15.5
饮料数量: 2
实际商品数量和价格会随着测试数据变化,但索引关系应保持一致。
注意下标索引的失效边界
这种设计适合练习和小型内存系统,但有一个必须明确的条件:vector 在中间删除元素后,后续元素会向前移动,原来保存的下标可能失效。因此只要发生删除、排序或其他会改变元素位置的操作,就要同步更新或重建索引。
对于本练习,最简单可靠的策略是把 vector 作为唯一主数据源,在批量变更后重新遍历一次并建立索引。若将来需要大量中间删除、长期稳定引用或更复杂的并发访问,再考虑稳定句柄、节点型容器或专门的数据存储结构,而不是过早增加复杂度。
按自己的节奏,确认真正理解。