
C / C++ / 系统课时
不同迭代器为什么能力不同
不同迭代器为什么能力不同
STL 算法不会假设所有容器都能按下标访问。迭代器的能力取决于底层数据结构:vector 可以常数时间跳到远处元素,而 list 必须沿链表逐个节点移动。理解这种差异,才能判断哪些运算和算法真正适用于某种容器。
学习目标
- 认识 Forward、Bidirectional、Random Access 等常见迭代器能力层级
- 理解
vector与list的迭代器为什么支持不同操作 - 正确区分“能够移动 N 步”和“能够常数时间随机跳转”
迭代器不是统一能力的指针
迭代器提供一种统一的遍历接口,但统一接口不等于统一能力。底层容器的数据布局不同,能够高效实现的操作也不同。
常见读取型迭代器可以按能力理解为逐步增强的层级:Forward Iterator 能向前移动;Bidirectional Iterator 还能向后移动;Random Access Iterator 进一步支持 +、-、+=、比较距离等随机跳转操作。C++20 还定义了 Contiguous Iterator,用来描述元素在内存中连续排列的情况。
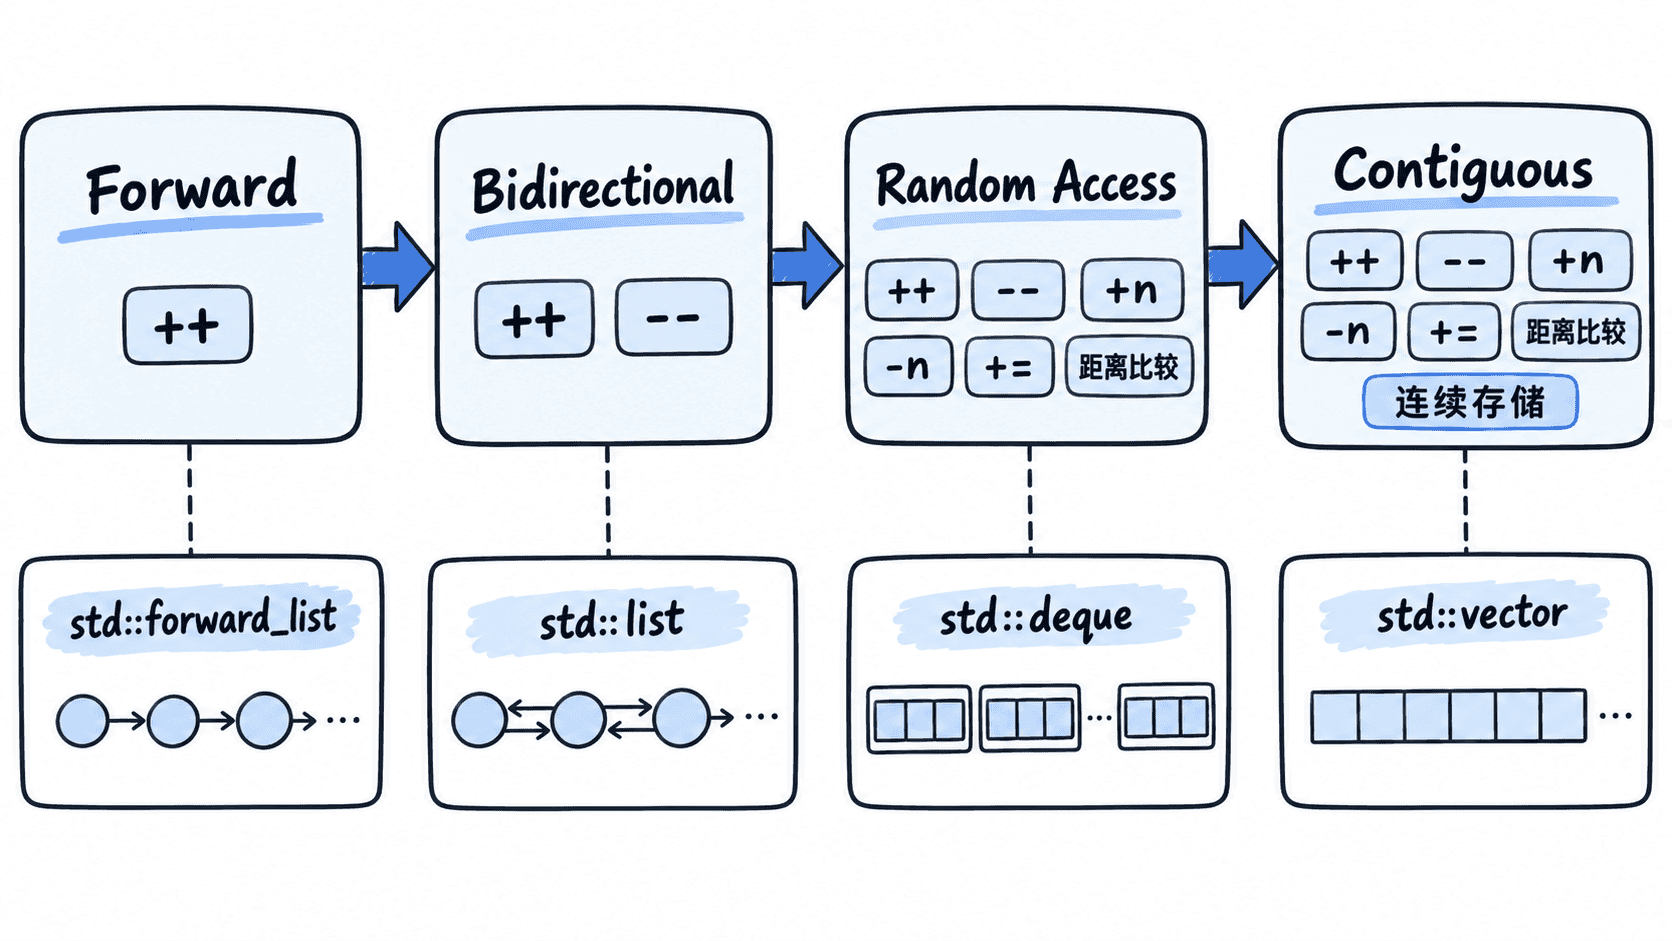
需要注意,Input Iterator 和 Output Iterator 还涉及读取、写入方向等约束,实际标准定义比一条简单继承链更细。学习容器算法时,先掌握上面的移动能力差异通常已经足够。
vector 为什么可以随机跳转
std::vector 把元素连续存放在内存中。已知当前位置和元素大小后,可以直接计算目标元素的位置,因此 it + n 不需要逐个经过中间元素。
下面的程序直接把迭代器向后移动三个位置:
#include <iostream>
#include <vector>

int main() {
    std::vector<int> values{10, 20, 30, 40, 50};

    auto it = values.begin();
    it += 3;  // Random Access Iterator 可以直接跳转

    std::cout << *it << '\n';
    std::cout << (it - values.begin()) << '\n';
}
预期输出:
40
3
这里的 it += 3 和两个迭代器相减都是随机访问迭代器支持的运算。对 vector 来说,这类位置计算通常是常数时间。
list 为什么不能使用加法跳转
std::list 通常实现为双向链表。一个节点知道前驱和后继,却不知道“向后第 100 个节点”的直接地址,因此只能沿链接逐个移动。
所以 list<int>::iterator 支持 ++it 和 --it,但不支持 it + 3、it += 3 或两个迭代器直接相减。它属于 Bidirectional Iterator,而不是 Random Access Iterator。
如果代码只想表达“向前移动 N 步”,可以使用 std::advance,它会按照迭代器能力选择合法的移动方式:
#include <iostream>
#include <iterator>
#include <list>

int main() {
    std::list<int> values{10, 20, 30, 40, 50};

    auto it = values.begin();
    std::advance(it, 3);  // 对 list 会逐个节点前进

    std::cout << *it << '\n';
}
预期输出:
40结果虽然同样到达第四个元素,但 std::advance 在 list 上需要沿链表移动,步数越大,工作量越大。它解决的是接口统一问题,并没有把链表变成随机访问结构。
算法会要求最低迭代器能力
STL 算法通常通过迭代器类别表达最低能力要求。例如只需顺序扫描的算法可以接受能力较弱的迭代器,而需要频繁计算中间位置、快速跳转的算法则可能要求 Random Access Iterator。
这也是为什么容器拥有 begin() 和 end() 还不代表它能使用所有算法。判断兼容性时,应同时看算法要求和容器提供的迭代器能力,而不是只看元素类型是否相同。
选择容器时也要把访问方式考虑进去:如果业务经常按位置跳转,vector 更符合这种访问模型;如果主要需求是在已知节点附近插入、删除并双向遍历,list 的迭代器能力已经足够。