
AI 内容创作 / 系统课时
角色声线与配音设定
角色声线与配音设定
角色声线不是“选一个好听的声音”,而是把人物身份、性格和当前处境转化为可重复执行的声音规则。本课将建立一张可测试、可交接的声线设定卡,并用统一台词完成试听与定稿。
学习目标
- 能把角色信息转化为年龄感、音色、语速、口音、情绪和禁用特征。
- 能编写可供真人配音或语音生成工具使用的声线设定卡。
- 能通过对照试听判断声线是否稳定、是否符合人物。
从人物信息推导声音参数
声线设定应先回答“这个人为什么这样说话”,再决定声音表面特征。年龄、生活状态与地域经历可以提供角色设定线索,具体音高、口音和节奏应由创作者与配音者在剧情中选择。不要从声音直接推断年龄、教育或社会身份。用台词关系与当下意图规定可听见的变化。
| 角色依据 | 可执行参数 | 检查问题 |
|---|---|---|
| 人物设定 | 音域、音色与发声习惯 | 与已定角色参考和这场表演一致吗 |
| 性格与目标 | 语速、力度、句尾处理 | 是否体现主动、犹豫或压迫感 |
| 身体与状态 | 气息、沙哑度、疲惫感 | 情绪变化时是否仍然可信 |
| 地域与经历 | 口音强度、用词习惯 | 是否影响理解或形成刻板印象 |
| 当前情绪 | 音量、停顿、重音位置 | 情绪是否推动台词而非覆盖台词 |
| 禁用特征 | 不允许出现的音色与表演习惯 | 多轮生成后是否仍能守住边界 |
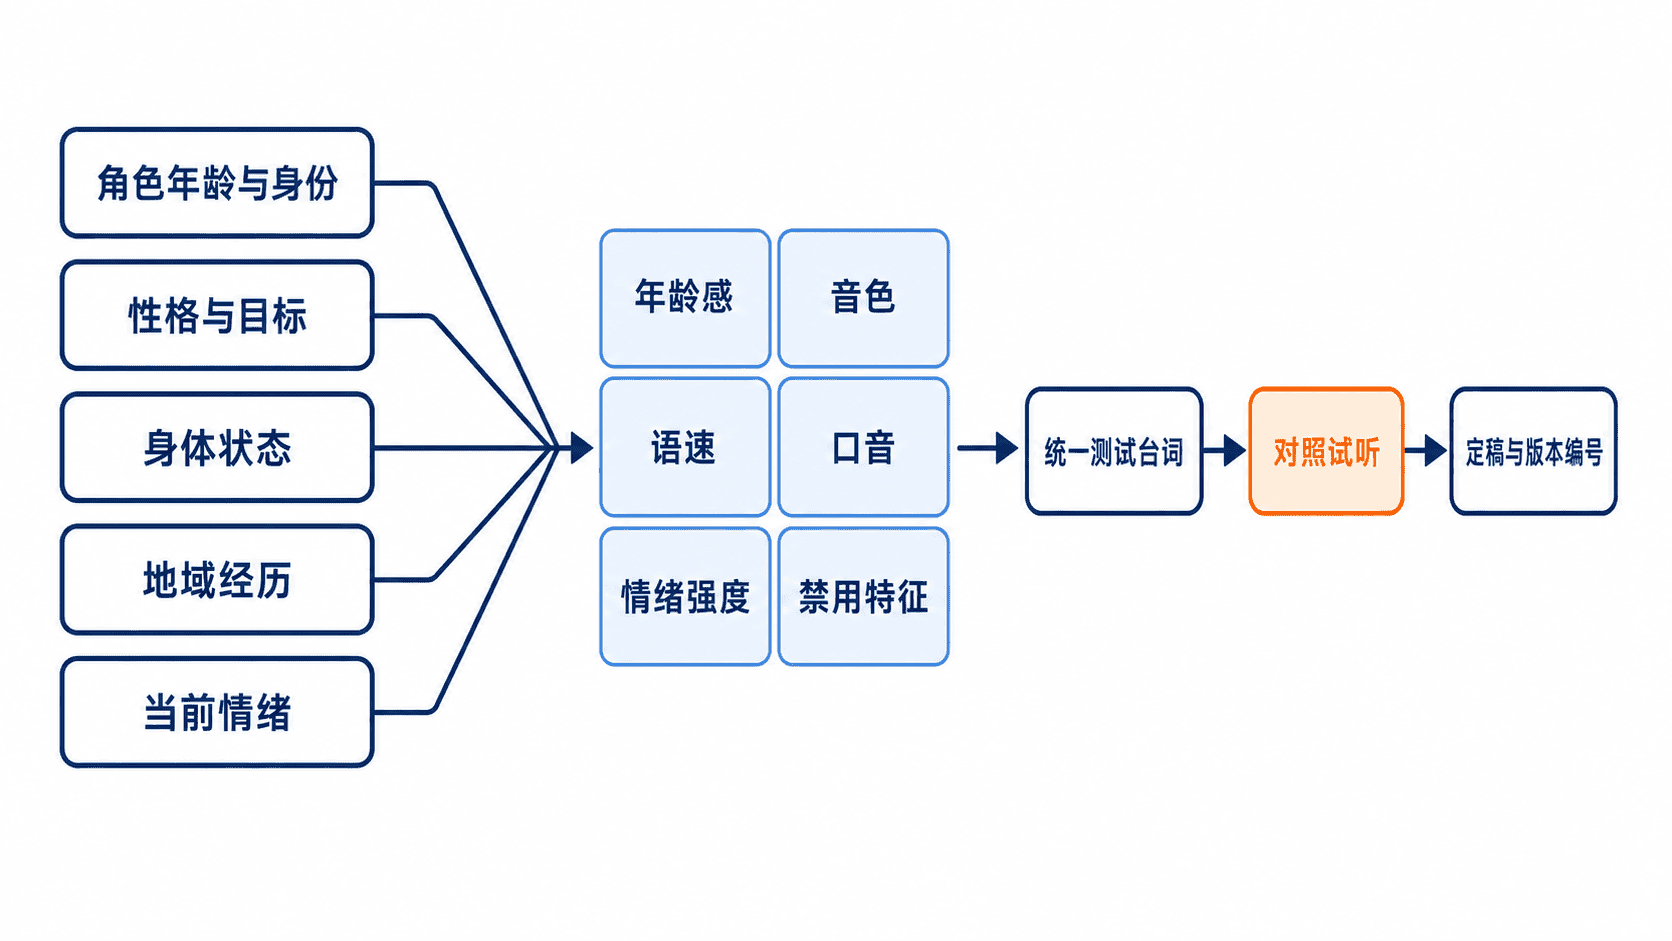
编写声线设定卡
声线设定卡要使用可听见、可比较的描述,避免只写“有磁性”“高级”“有故事感”等主观词。每个参数最好同时给出目标、允许范围和禁用项,使不同配音员或不同生成批次能够得到接近的结果。
| 字段 | 示例设定 |
|---|---|
| 角色 | 林夏,29 岁,纪录片制片人 |
| 年龄感 | 约 28~32 岁,成熟但不过度低沉 |
| 音色 | 中低音,轻微颗粒感,气息稳定 |
| 语速 | 日常偏快;解释重要信息时主动放慢 |
| 口音 | 普通话为主,保留轻微南方语调,不使用明显方言词 |
| 情绪基线 | 克制、专注,压力上升时语句变短 |
| 表演变化 | 对同事直接,对长辈收敛,对自己独白时更轻 |
| 禁用特征 | 禁止播音腔、过度气声、持续上扬句尾和夸张哭腔 |
禁用项要描述可识别的声音现象。例如“不要油腻”难以执行,改成“不要刻意压低音高,不拖长句尾,不在每句话前增加气声”才便于试听和修正。
用统一台词完成试听
先固定台词、录音环境和后期处理。比较音色时做等响度试听,比较表演力度时另保留原电平。一次只变语速或情绪幅度等一项。一次同时改变多个参数,无法判断改善来自哪里。
可准备三类测试台词:
- 信息句:检查咬字、自然语速和信息清晰度。
- 冲突句:检查力度、重音和情绪上限。
- 低声句:检查气息、细节和音色稳定性。
同一候选声线至少试听两轮。第一轮判断“像不像这个人”,第二轮把声音放进画面,判断它是否与角色表演、镜头距离和环境声匹配。仅凭单独音频觉得好听,不代表进入成片后仍然成立。
把试音和最终使用范围分开
《最后一帧》的林森可以用“时间不多了”“就留这一帧”“先听原声”作为信息句、决定句和低声句。对 s03-sh003 的可选台词只保留本片语气,不加新的叙事事实。出片前将 36–40 秒版本与无对白版本对照,检查点击和独立笑声是否仍可辨。
真人录音、合成声线和用于模仿可识别声音的参考分别记录来源、使用许可、可用场景与版本。试音获准不代表可以将录音用于训练或在所有渠道交付。权限范围要在提交给生成或剪辑环节前明确。
Tips
- 为声线卡增加版本号,例如
V1.2,并记录本次只改了“语速”还是“情绪上限”。 - 用 10~20 秒的固定基准台词做回归测试,角色再次出现时先与基准片段对照。
- 多角色同场时,不只追求每个人单独好听,还要检查音高、节奏和口音是否具有足够区分度。
常见错误
| 错误表现 | 产生原因 | 修复方法 |
|---|---|---|
| 每句都很有情绪,但人物不可信 | 把情绪当成持续强度,没有设置基线 | 先确定常态,再只在关键动作处提高强度 |
| 多轮生成后声线越来越偏 | 设定只写正向形容词,没有禁用边界 | 增加可听见的禁用特征并保留基准音频 |
| 角色年龄感正确,却像广告旁白 | 句尾、重音和节奏过度整齐 | 打破固定停顿,按人物思考过程组织节奏 |
| 口音成为注意力中心 | 口音强度过高或缺乏人物依据 | 降低到能体现经历但不影响信息理解的程度 |
本课练习
- 为一名“45 岁、长期夜班、说话谨慎的急诊医生”制作声线设定卡,至少填写年龄感、音色、语速、情绪基线、关系变化和 3 条禁用特征。验收时应能仅凭文字让另一位同学复述出相近的声音方向。
- 选取一段 15 秒台词,制作两个只在语速上不同的试听版本。记录哪个版本更符合人物目标,并说明判断依据,不能只写“更好听”。
本课总结
- 声线设定的核心是把人物事实转化为可听见、可比较、可复现的参数。
- 正向目标与禁用特征必须同时存在,才能减少多轮生成中的声线漂移。
- 定稿应基于统一台词和画面内试听,而不是仅凭单独音频的主观印象。
下一课预告
下一课将学习“旁白生成与节奏控制”,把断句、重音、停顿和语气标记转化为可执行的旁白脚本,并通过试听让信息更容易被听懂。