
AI 内容创作 / 系统课时
分镜图批量生成
分镜图批量生成
当镜头清单进入图像生产阶段,真正的难点不是一次生成多少张图,而是让每张分镜都能追溯到同一套角色、场景和镜头约束。本课将建立批量生成的输入契约、提示词清单与验收流程,使分镜草图能够快速迭代而不失去连续性。
学习目标
- 把镜头清单转换为可批量执行的提示词清单。
- 使用角色参考、场景参考和连续性锁定项控制一致性。
- 通过联络表和返工标签快速定位不合格镜头。
输入契约与批量流程
批量生成前,先把每个镜头整理成结构化记录。最低限度应包含镜号、景别、机位、主体动作、角色参考、场景参考和连续性要求。一个镜头可以有多格,各格有独立动作与提示,并继承相同机位、连续性约束和素材版本。以镜号和画格号组合定位,不把多格误算为多个镜头。
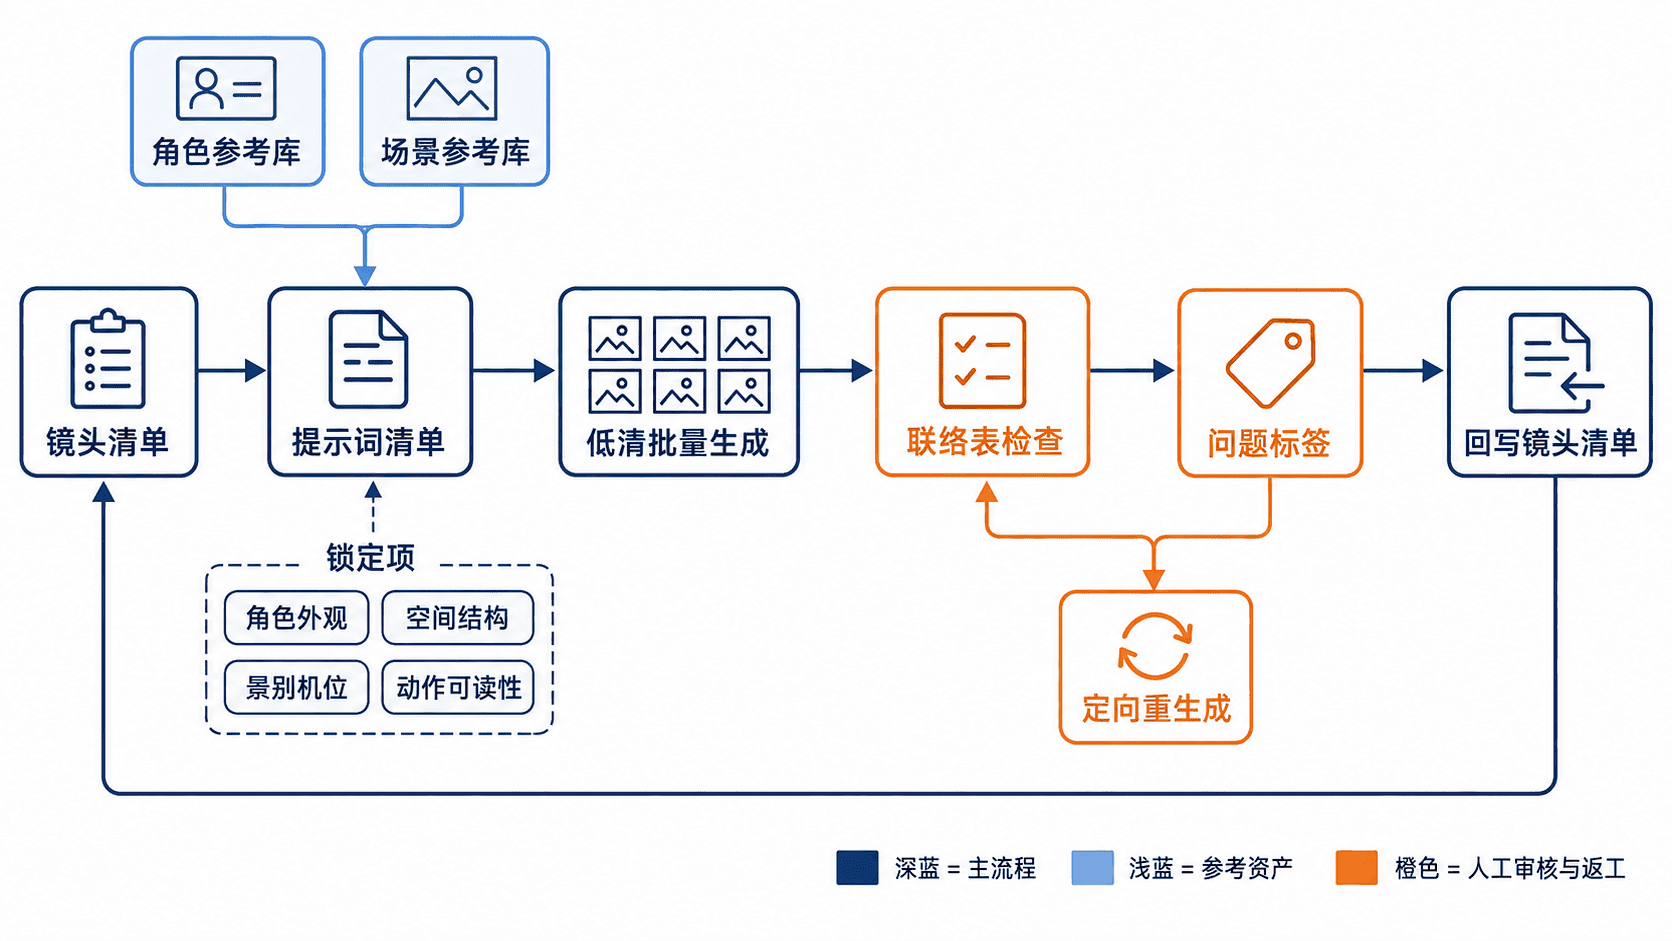
建议先按场景分组,再按角色状态排序。这样同一批次内的环境和服装变化更少,检查人员也能更快发现漂移。批量阶段先生成低清草图,确认构图后再提升分辨率,不要一开始就把算力消耗在尚未通过审核的镜头上。
一致性控制
角色参考解决“是谁”,场景参考解决“在哪里”,镜头字段解决“怎么看”。文字描述叙事意图,实际参考文件用附件字段传给支持参考条件的生成工具。文件名或资产 ID 写在文字里并不会使模型读到图片。随机种子可以帮助复现构图倾向,但不能替代身份参考,也不能保证跨模型或跨版本得到相同结果。
| 控制对象 | 必须锁定的内容 | 允许变化的内容 |
|---|---|---|
| 角色 | 面部特征、发型、服装主色、体型 | 表情、姿态、视线 |
| 场景 | 空间结构、门窗位置、主光方向 | 小道具、局部明暗 |
| 镜头 | 景别、机位高度、视角、主体位置 | 轻微构图微调 |
| 连续性 | 左右关系、持物状态、动作阶段 | 不影响叙事的小细节 |
完整可运行示例
下面的 Python 3 程序把结构化镜头记录转换为批量提示词清单,并在生成前检查参考资产是否齐全。先在 refs 目录放入本轮已批准的角色和场景参考,登记各文件 SHA-256 和用途。下面是 storyboard-job.json 的结构,样例指纹需要换成真实值。程序只生成清单,没有调用图像服务。
{
  "panels": [
    {
      "shot": "s03-sh003",
      "panel": "P01",
      "camera": "中近景,固定侧前机位",
      "action": "林森看向倒计时",
      "continuity": "保持按键手在画面下沿",
      "refs": {
        "character": "lin-v1",
        "scene": "editing-room-v2"
      }
    },
    {
      "shot": "s03-sh003",
      "panel": "P02",
      "camera": "沿用 P01",
      "action": "林森停顿后按导出",
      "continuity": "屏幕右上留空",
      "refs": {
        "character": "lin-v1",
        "scene": "editing-room-v2"
      }
    }
  ],
  "refs": {
    "lin-v1": {
      "role": "character",
      "file": "lin-v1.png",
      "sha256": "填写角色参考文件的 SHA-256",
      "approved": true
    },
    "editing-room-v2": {
      "role": "scene",
      "file": "editing-room-v2.png",
      "sha256": "填写场景参考文件的 SHA-256",
      "approved": true
    }
  }
}import hashlib
import json
from pathlib import Path
def make_manifest(panels, refs, directory):
root = directory.resolve()
seen = set()
result = []
for panel in panels:
key = (panel["shot"], panel["panel"])
if key in seen:
raise ValueError("镜号和画格号重复")
seen.add(key)
attachments = []
for role, ref_id in panel["refs"].items():
ref = refs.get(ref_id)
if not ref or not ref["approved"] or ref["role"] != role:
raise ValueError(f"参考资产未通过用途校验:{ref_id}")
path = (root / ref["file"]).resolve()
if not path.is_relative_to(root) or not path.is_file():
raise ValueError(f"参考文件缺失或越界:{ref_id}")
if hashlib.sha256(path.read_bytes()).hexdigest() != ref["sha256"]:
raise ValueError(f"参考文件版本不符:{ref_id}")
attachments.append({"role": role, "ref": ref_id, "file": ref["file"], "sha256": ref["sha256"]})
result.append({
"shot": key[0], "panel": key[1],
"prompt": f'{panel["camera"]}。{panel["action"]}。{panel["continuity"]}。',
"attachments": attachments,
})
return result
if __name__ == "__main__":
root = Path("refs")
job = json.loads(Path("storyboard-job.json").read_text(encoding="utf-8"))
rows = make_manifest(job["panels"], job["refs"], root)
Path("storyboard_manifest.json").write_text(
json.dumps(rows, ensure_ascii=False, indent=2), encoding="utf-8"
)
print(f"已校验 {len(rows)} 格分镜")预期输出:
已校验 2 格分镜程序生成的 storyboard_manifest.json 可作为后续批量调用或人工复制提示词的统一输入。适配器按工具能力读取 attachments 并绑定实际参考文件。若不支持参考图片,应显式标记为降级候选。记录工具版本、输入指纹、画格 ID、结果与退回原因,失败后只补跑受影响的格。
验收与返工
验收时不要逐张孤立查看,而要把同一场景的分镜排成联络表。先看角色和空间是否连续,再看景别、动作与视线是否符合镜头清单。发现问题后给镜头添加单一主标签,例如“角色漂移”“空间错误”“动作不清”或“机位偏差”,一次只修正最主要的问题。
常见错误是把所有失败都归结为“提示词不够长”。提示词越长不一定越稳定,真正有效的修复通常是补齐缺失参考、删除互相冲突的描述,或把复合动作拆成前后两个镜头。重生成时应保持其他参数不变,才能判断修正是否有效。
本课总结
- 批量生成的基础是结构化镜头记录,而不是临时拼接长提示词。
- 角色、场景、镜头和连续性需要分别锁定,并在联络表中统一验收。
- 返工应使用明确问题标签和单变量修正,确保结果可比较、可追溯。
下一课预告
下一课将进入“动态分镜与节奏评审”,把静态分镜、临时对白和音乐放到时间线上,通过真实时长检验镜头节奏与信息密度。