
AI 内容创作 / 系统课时
语音驱动口型同步
语音驱动口型同步
语音驱动口型同步的目标,不是让嘴巴持续运动,而是让开口、闭口和唇形变化准确服务于台词。本课将建立从音频整理、音素映射到时间轴校正的完整流程,并解决错位、闭口不足和机械抖动问题。
学习目标
- 理解音素、视素与口型关键帧之间的关系。
- 能够修正口型提前、滞后和句尾闭口失败。
- 建立可重复使用的口型同步验收流程。
核心流程与准备
一种可编辑的链路先对齐音素,再映射为可见嘴形,即视素。也有端到端方法直接输出变形系数或图像,验收仍要看音画时间和可见嘴形。多个音素可能共享同一种视素,因为镜头无法看到舌位等全部发音细节。系统随后把视素放到时间轴上,并通过插值生成连续的嘴部运动。
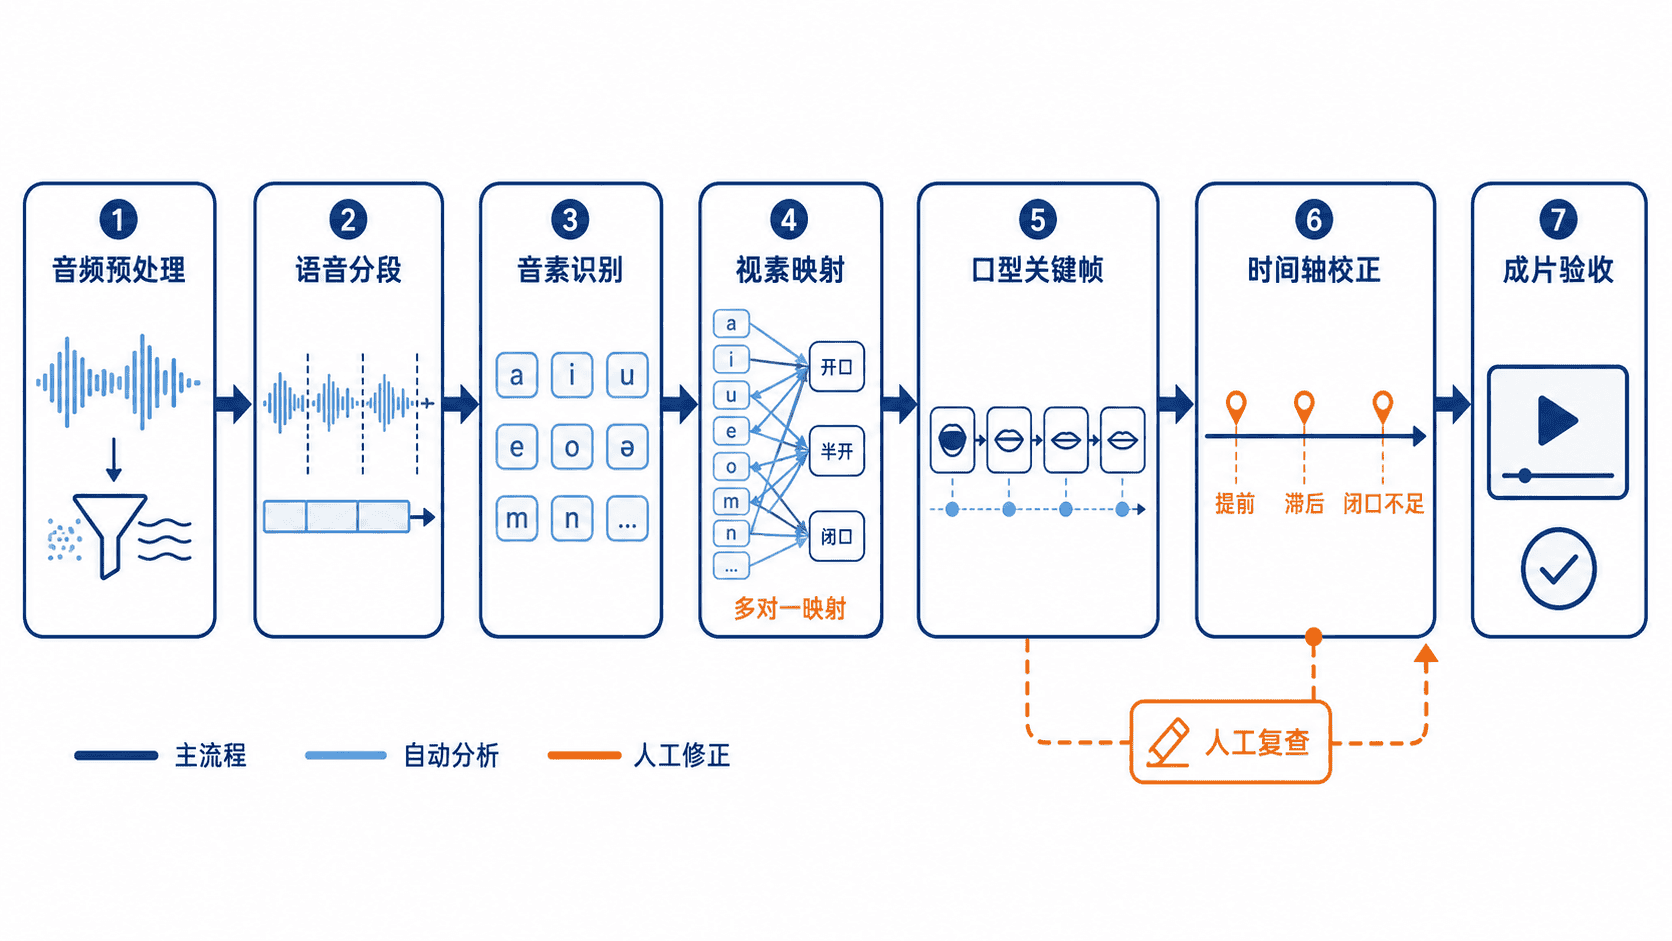
开始计算前,应使用干净、节奏稳定的单人对白。明显的背景音乐、混响和多人重叠说话会降低分段准确度。角色面部还要具备可控的下颌、嘴角和上下唇形变,否则识别结果正确也无法形成可信表演。
准备时重点检查音频起点、自然停顿和帧率基准。可在不改对白节奏的前提下修剪无效静音,并记录改后的起点。头部位姿和局部嘴形可以独立求解或联合求解,合成时要核对坐标及层级。
错位、闭口与节奏校正
先把音频采样位置、动画帧和视频展示时间换到同一时基,再比可观察的锚点。若误差近似恒定,可平移口型。若误差逐渐扩大或在剪点跳变,应先核对帧率解释、时间戳和剪辑起点。正确重采样应保持持续时间,采样率误标或错误解释才会引入漂移。不要只检查第一句话,应在片头、中段和片尾分别抽查,因为变速、重采样或帧率不一致可能造成累计漂移。
| 问题表现 | 常见原因 | 修正方法 | 验收重点 |
|---|---|---|---|
| 嘴巴先动,声音后到 | 音频起点偏移 | 整段口型向后平移 | 爆破音起点是否贴合 |
| 声音已开始,嘴巴仍静止 | 识别或缓存延迟 | 整段口型向前平移 | 第一音节是否及时出现 |
| 句尾嘴巴不闭合 | 停顿未生成闭口视素 | 在停顿处补闭口关键帧 | 嘴部是否自然回收 |
| 嘴形持续抖动 | 音素切分过密 | 合并短片段并降低幅度 | 元音保持是否稳定 |
闭口不等于始终把上下唇完全贴合。自然表演可以在短停顿中保留轻微张口或呼吸;双唇音的闭合可作为可见锚点。句尾是否闭合取决于后续呼吸和表演,不能一律加紧闭关键帧。比较闭唇与释放时要用同类参照,口唇为发音做准备可能自然早于声音。相邻音素还会产生协同发音,因此不能把每个音素切成互不相关的独立动作。
重读词通常伴随更大的下颌开合,耳语或犹豫台词则应减小幅度。角色转头时,嘴部动作必须跟随面部局部坐标变化,避免出现像二维贴图一样悬在画面上的效果。
用三个锚点区别两类时间误差
下面的数字使用 48 kHz 音频和 24 fps 恒定帧率。样本序号、帧序号均从 0 起,正值表示标记的嘴形晚于音频基准。实际比较选择已确认对应的发音事件。VFR 视频要读取每帧展示时间,而非只用帧序号除以平均帧率。
from fractions import Fraction

def measure(audio_samples, mouth_frames, *, sample_rate, fps):
    if len(audio_samples) != len(mouth_frames) or len(audio_samples) < 2:
        raise ValueError("至少要有两对音画标记")
    if sample_rate <= 0 or fps <= 0:
        raise ValueError("采样率与帧率必须为正")
    if any(b <= a for a, b in zip(audio_samples, audio_samples[1:])) or any(
        b <= a for a, b in zip(mouth_frames, mouth_frames[1:])
    ):
        raise ValueError("标记顺序须严格递增")
    audio_times = [Fraction(sample, sample_rate) for sample in audio_samples]
    mouth_times = [Fraction(frame) / fps for frame in mouth_frames]
    offsets = [(m - a) * 1000 for a, m in zip(audio_times, mouth_times)]
    return offsets, offsets[-1] - offsets[0]

for label, frames in [("固定偏移", [27, 75, 123]), ("逐渐漂移", [27, 76, 125])]:
    offsets, drift = measure([48000, 144000, 240000], frames, sample_rate=48000, fps=Fraction(24))
    values = ", ".join(f"{float(value):+.1f}" for value in offsets)
    print(f"{label}: {values} ms,首尾差 {float(drift):+.1f} ms")
首组每点都是 +125.0 ms,首尾差为 0。第二组首尾差约 +83.3 ms,平移只能对齐一个位置。用正确时间基重新对齐后再抽查中点及剪点。
验收、常见错误与练习
验收时先静音观看,检查嘴部是否平滑;再只听声音,确认停顿和重音;最后合并观看,重点检查爆破音、双唇音、长元音和句尾回收。发现问题时,优先微调时间和幅度,不要立即重算整段。
常见错误包括过度追求每个音素都精确对应、所有台词使用统一开合幅度,以及忽略镜头景别。远景不需要过密嘴形,特写则必须检查嘴角、唇闭合和牙齿暴露,口型精度应服从最终画面尺度。
练习一:选择一段 8~12 秒的单人对白,标记每句的起点、重读词、停顿和结束位置,并检查自动口型是否与四类节点一致。
练习二:人为制造“整体提前 3 帧”和“句尾不闭口”两个问题,分别修正后,对比爆破音起点与停顿状态是否恢复自然。
本课总结
- 口型同步是音素、视素、时间轴和角色形变共同作用的结果。
- 优先修正整体偏移、句尾闭口和过密抖动,再处理细节表演。
- 最终验收需要结合静音画面、纯音频和完整成片三种检查方式。
下一课预告
下一课将学习“半身与全身数字人”,重点比较不同角色方案的适用镜头,并处理手势、躯干和口型之间的协调关系。