
AI 内容创作 / 系统课时
主流生成能力边界
主流生成能力边界
选择生成工具前,先要判断任务属于哪种媒体能力,以及模型能稳定完成到什么程度。本课建立文本、图像、视频、语音和音乐五类能力地图,帮助你把“模型能生成”与“结果可用于制作”区分开来。
学习目标
- 区分五类生成能力的优势、限制与典型交付物。
- 根据镜头目标选择单模型任务或多模型组合流程。
- 识别一致性、可控性、版权和真实性方面的风险。
五类能力地图
不同模型解决的是不同层级的问题。文本模型擅长组织信息与方案,图像模型擅长定义单帧视觉,视频模型负责时间变化,语音模型承担语言表演,音乐模型塑造情绪与节奏。它们可以串联,但不能互相替代。
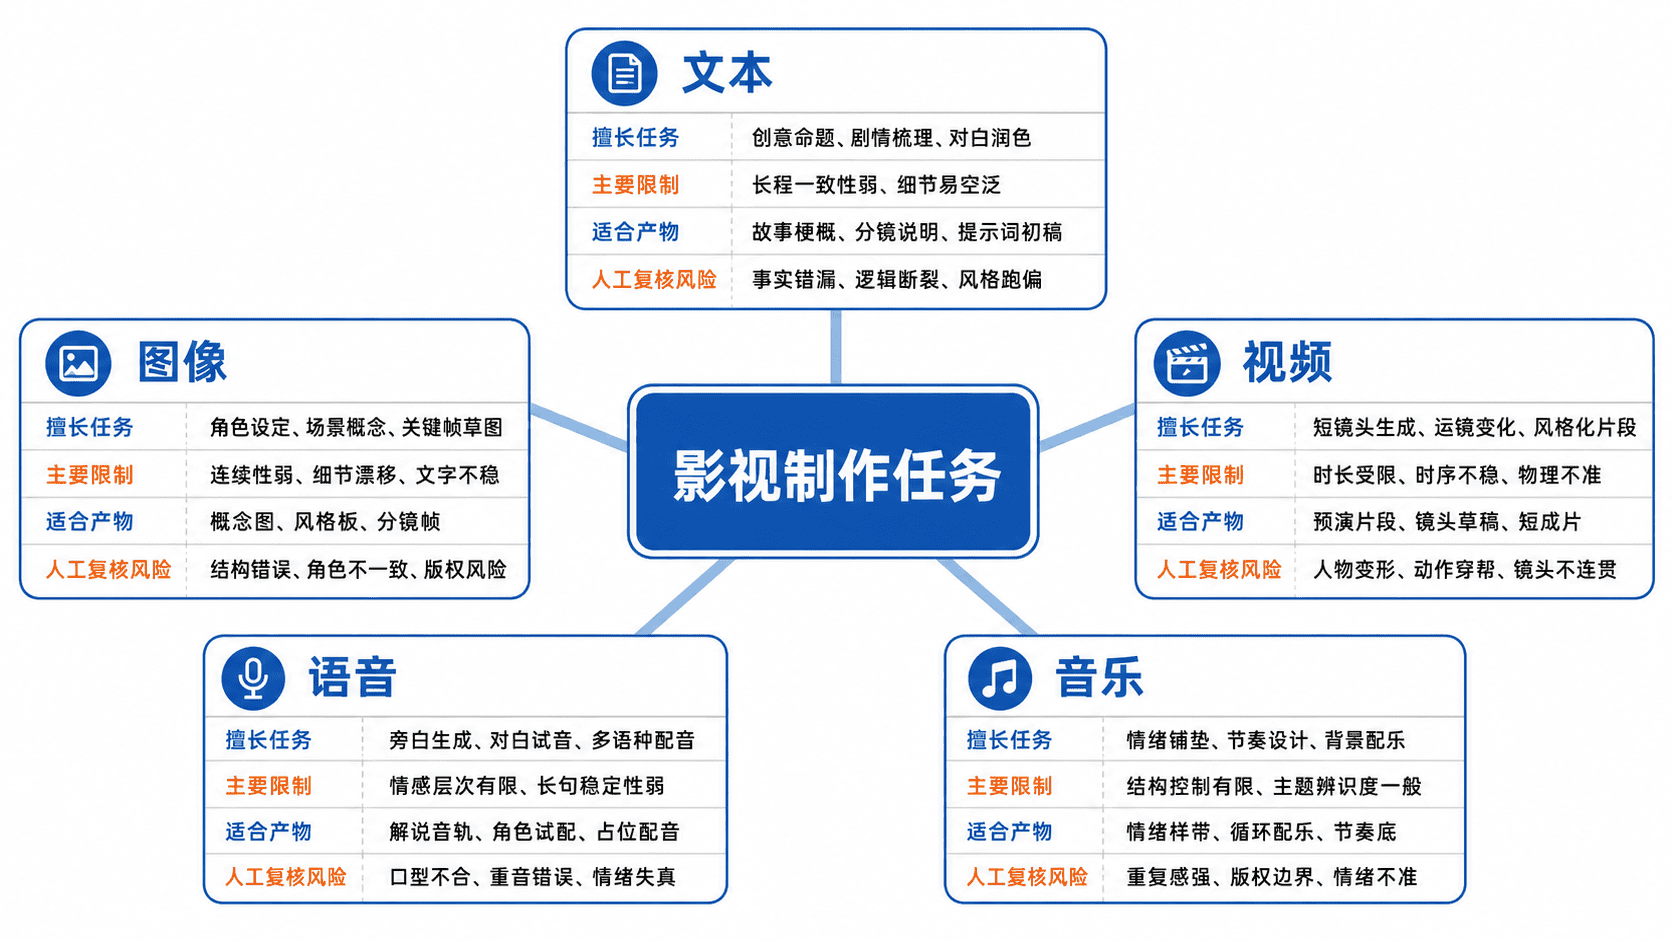
| 能力类型 | 适合解决的问题 | 主要边界 | 常见制作产物 |
|---|---|---|---|
| 文本生成 | 选题发散、剧本草案、角色小传、镜头描述、提示词改写 | 可能编造事实,缺少真实世界验证,长篇结构容易前后漂移 | 大纲、剧本初稿、镜头表、旁白稿 |
| 图像生成 | 角色造型、场景概念、道具设计、关键帧、海报 | 单帧强但连续性弱,文字与复杂空间关系可能失真 | 视觉设定、分镜图、参考图、封面 |
| 视频生成 | 动作、镜头运动、氛围变化、短镜头表现 | 长时一致性、精确动作、物体交互和连续叙事仍难稳定 | 叙事镜头、转场、氛围镜头、动态背景 |
| 语音生成 | 旁白、角色试音、多语言版本、临时配音 | 情绪细节、专有名词、口型同步和身份授权需要复核 | 旁白、对白、角色声音样片 |
| 音乐生成 | 情绪草案、节奏参考、短配乐与版本探索 | 长段结构、主题发展、版权来源和风格模仿风险需管理 | 配乐草案、片头音乐、环境音乐 |
判断“可生成”与“可交付”
模型能产生结果,只说明任务可以被尝试,不代表结果已经满足制作标准。可交付结果至少要同时通过四个维度:内容正确、风格一致、技术合格、权利清晰。
可以使用下面的判断顺序:
任务是否能用明确输入描述?
├── 否:先补充剧本、参考资产或验收标准
└── 是:模型能否稳定控制关键变量?
    ├── 否:拆成更短镜头或改为人工制作
    └── 是:结果能否通过连续性与技术质检?
        ├── 否:进入迭代、合成或后期修复
        └── 是:检查授权、版权与平台规范后交付
“关键变量”取决于任务。角色镜头的关键变量可能是脸部、服装和动作;产品镜头可能是结构、文字和材质;对白镜头还要增加口型、音色、语气和停顿。关键变量越多,单次生成越难稳定,越需要拆分或组合工作流。
单模型与组合工作流
简单任务可以由单一模型完成,例如生成一张场景概念图或一段无对白的氛围镜头。复杂任务通常需要组合:先用文本模型整理镜头描述,再用图像模型建立角色和场景参考,随后用视频模型生成运动,最后用语音、音乐和后期工具完成叙事。
组合工作流的价值不只是“多用几个工具”,而是让每一步只承担它最擅长的职责。例如,视频模型不适合在同一镜头中同时解决角色造型、复杂对白、精确手部动作和多次机位切换。更可靠的做法是先锁定角色视觉,再拆分动作,分别生成并在后期剪接。
例如角色把钥匙交给守卫时,一次生成同时要求脸部一致、交接正确、对白与口型精确,往往很难定位失败点。可将角色站位和服装用参考图固定,把钥匙交接做成单独插入镜头,再独立处理对白与合成。用同一镜头表进行少量多次小试,记录成功标准、可用样片数和返工成本。假设 5 次生成有 2 次同时通过手部、道具和朝向检查,记录为 2/5。样本规模只用于比较本次方案,不能外推到全部镜头。
- 缩短镜头时长,减少同一镜头内的动作数量。
- 固定参考资产,减少角色、服装、场景和光线同时变化。
- 把不可控部分交给后期,例如字幕、画面内文字、精确节奏和局部合成。
质量与风险边界
一致性
图像和视频生成最常见的问题是对象在时间或镜头之间变化。应建立角色设定表、场景参考和镜头连续性记录,并把一致性作为独立验收项,而不是只看单帧质量。
出现不稳定时,可缩短镜头、冻结参考素材,或将精确字幕、屏幕文字和局部合成交给后期。
真实性
涉及新闻、历史、科学、医疗、品牌或真实人物时,生成内容必须经过来源核验。文本模型可能给出流畅但错误的信息,图像和语音也可能制造具有误导性的“真实感”。
权利与授权
核查素材来源、真人肖像和声音许可、工具与素材的商用条款以及目标平台的披露要求。给每项素材保存出处、适用用途、期限和审核状态。风格模仿、商标、肖像及受保护素材可能涉及不同规则,应按实际用法和交付地区分别判断。内容凭据可帮助验证随文件附带的来源声明和绑定,事实与授权仍需独立复核。
技术规格
模型输出的分辨率、帧率、画幅、码率、响度和字幕格式未必符合最终平台要求。生成完成后仍需执行统一转码、画面检查、声音检查和成片质检。
选择能力的实用原则
- 先写验收标准,再选择模型;没有验收标准时,模型越多,试错越混乱。
- 把精确文字、片长计算、字幕格式和技术校验交给规则或确定性工具。让生成模型承担草案和可筛选的变体,高责任、高精度或高风险内容由人工复核。
- 对连续叙事优先设计资产复用和镜头拆分,不依赖一次生成完成整段表演。
- 对事实、身份、版权和敏感内容设置强制人工检查,不能只凭生成结果“看起来合理”。
- 评估工具时以可重复产出为准,不以单个最佳样片判断真实能力。
本课总结
- 文本、图像、视频、语音和音乐模型各自负责不同层级的制作任务。
- “能生成”不等于“可交付”,还必须通过一致性、技术规格、事实和权利检查。
- 复杂镜头应通过拆分任务和组合工作流降低控制难度。
下一课预告
下一阶段将进入实际制作准备,继续把创意目标转化为可执行的剧本、视觉参考和镜头任务,并建立统一的素材与版本管理方式。