
AI 内容创作 / 系统课时
视频生成模式选择
视频生成模式选择
视频生成模式不是“效果排行榜”,而是不同控制入口。选对模式,能够把已有资产转化为稳定约束,减少角色漂移、动作失控和无效重试;本课将建立一套从镜头需求反推生成模式的选择方法。
学习目标
- 区分文生视频、图生视频、首尾帧、参考视频和视频重绘的控制重点
- 根据已有素材、动作要求和连续性目标选择合适模式
- 用组合式工作流降低单次生成承担的任务数量
五种模式分别控制什么
下面按常见控制入口分类。不同工具与模型版本支持的输入、长度、首尾条件和遮罩能力并不一致;有些入口可以组合。项目记录实际模型版本、能用的参数、参考素材与输出规格,再用样片验证。
| 模式 | 主要输入 | 最适合解决的问题 | 主要风险 |
|---|---|---|---|
| 文生视频 | 文本描述 | 快速探索陌生场景、动作和镜头概念 | 角色外观、空间关系和细节容易漂移 |
| 图生视频 | 图像条件,可能是起始帧或视觉参考 | 尽量承接角色、服装和构图 | 有些模式不逐像素保留输入;大动作可能改动结构 |
| 首尾帧 | 前后图像条件 | 减少起点或落点的偏差 | 中间路径仍可能变形、绕行或突跳 |
| 参考视频 | 已批准的动作或相机参考 | 借用运动和时间关系 | 是否能分离人物动作与相机运动取决于工具 |
| 视频重绘 | 原视频及区域或外观条件 | 在源动作合格时处理外观和局部问题 | 可能改动运动、遮挡、阴影或遮罩外内容 |
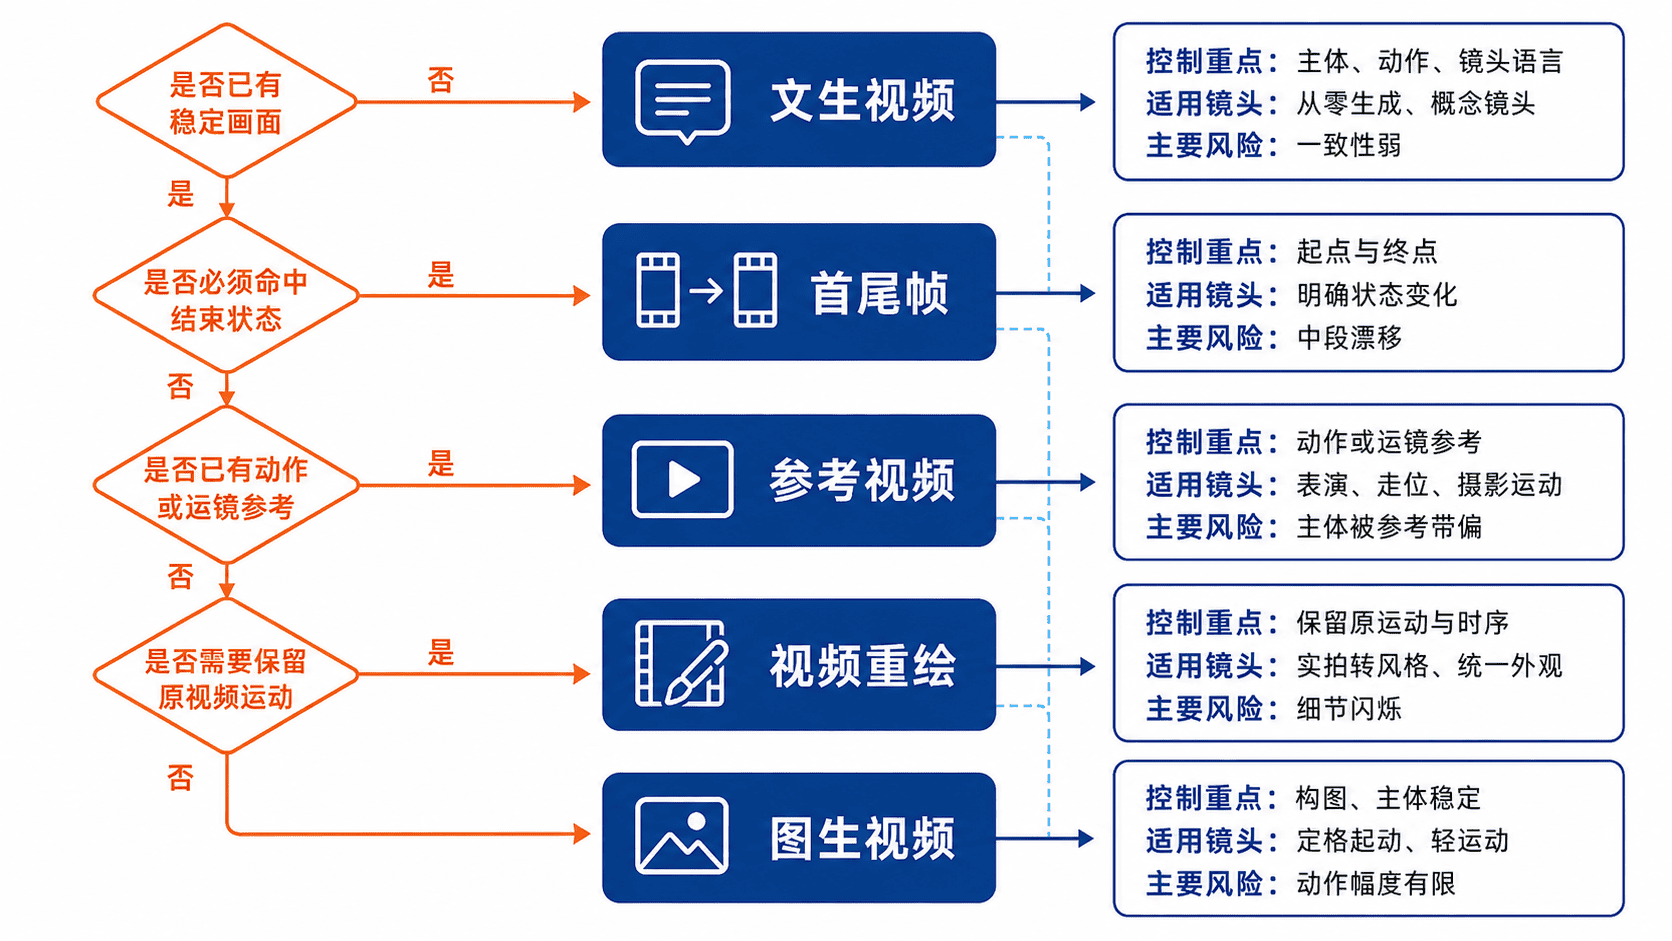
选择模式的判断顺序
先判断镜头中哪些内容不能变化,再决定把这些内容放进哪一种输入。可以按以下顺序收敛:
- 没有可复用画面,只需要探索概念时,从文生视频开始。
- 已有定稿角色、场景或构图时,优先使用图生视频,让静态资产成为视觉锚点。
- 起点和终点都必须准确时,使用首尾帧,并把动作设计压缩为一条清晰路径。
- 表演节奏、肢体动作或相机轨迹比外观更重要时,引入参考视频。
- 原视频运动已经合格,只需改变风格、服装、材质或局部对象时,选择视频重绘。
这个顺序的本质是“先复用最可信的资产”。不要让模型同时决定角色长相、环境结构、复杂动作、镜头运动和最终落点,否则任何一项漂移都会导致整条镜头返工。
一个镜头如何选择
以《最后一帧》b04(29–43 秒)为例。s03-sh002 恢复原声,s03-sh003 停顿并按下导出,s03-sh004 显示导出开始。分别评估输入,不把手部运动、屏幕文字与最终状态都交给生成模型。
| 镜头 | 推荐试法 | 失败后的处理 |
|---|---|---|
| s03-sh002 | 用已批准的手部、袖口和设备图做起始参考;固定机位测试接触 | 若手指与按钮持续穿插,换动作参考或单独制作手部动作 |
| s03-sh003 | 用上一课角色参考锁定机位与身份,检查按键前停顿 | 若终点漂移,可测试首尾条件;路径仍不合格则拆镜 |
| s03-sh004 | 稳定屏幕画面,后期跟踪合成界面状态 | 确认只显示导出开始,完成留到 b05 |
参考视频若含可识别人物、受限镜头或客户素材,先核对允许的使用和上传范围。生成后逐条检查人物、手、道具、落点和切点,再决定重做、修补或合成。重绘只在原有运动与时间关系已经可用时作为候选。
本课练习
- 为“城市天台上,角色从静止到转身离开”的镜头选择主模式。写出不可变化的信息、可接受变化的信息和一个备用模式,并说明切换条件。
- 将“角色奔跑、跳过障碍、落地后回头”的复杂镜头拆成两个或三个生成任务。为每个任务指定输入资产、主要控制目标和验收点。
本课总结
- 模式选择取决于已有约束,而不是单纯比较生成质量。
- 图像条件、首尾帧、参考视频和重绘提供不同约束,实际保留效果以输出验收为准。
- 复杂镜头应拆分任务,并用组合工作流逐步锁定外观、动作和结果。
下一课预告
下一课将学习“时长、帧率与分辨率”,把镜头功能转换为可执行的生成时长、运动密度、画幅与后期放大方案。
按自己的节奏,确认真正理解。