
交互与用户体验 / 系统课时
用热力图发现二维分类模式
用热力图发现二维分类模式
当订单量同时受到星期与时段影响时,单独使用柱状图很难看清高峰集中在哪些组合。本篇通过一组虚构门店订单数据,构建星期与时段的二维热力图,完成数值聚合、顺序色阶设计和缺失值标记,并判断哪些颜色差异能够支持业务结论。
学习目标
- 将日期与时段、产品与地区等两个分类维度整理成热力图矩阵。
- 使用统一的顺序色阶和独立的缺失值样式,准确表达数值大小。
- 从热区与冷区发现分类组合模式,避免把颜色深浅误读为数值比例或业务效率。
将两个分类维度整理成矩阵
热力图适合回答“哪些分类组合的指标较高或较低”。它通常使用行和列承载两个分类维度,用每个交叉单元格的颜色表达一个数值指标。
例如,一家门店希望找出每周订单高峰,可以固定以下统计口径:
- 统计范围:2026 年 9 月 7 日至 13 日,单家门店。
- 行维度:星期一至星期日,共 7 类。
- 列维度:08:00–11:00、11:00–14:00、14:00–17:00、17:00–20:00,共 4 类。
- 度量:每个时段内支付成功的订单数量,单位为单。
- 统计规则:按照支付成功时间归属时段,左闭右开,例如 11:00 的订单计入 11:00–14:00;排除未支付订单,同一订单只计数一次。
得到下面的虚构样例矩阵:
| 星期 | 08–11 | 11–14 | 14–17 | 17–20 |
|---|---|---|---|---|
| 周一 | 12 | 29 | 38 | 14 |
| 周二 | 9 | 22 | 33 | 17 |
| 周三 | 11 | 27 | 缺失 | 18 |
| 周四 | 13 | 30 | 44 | 21 |
| 周五 | 16 | 36 | 49 | 28 |
| 周六 | 21 | 42 | 54 | 37 |
| 周日 | 18 | 39 | 46 | 31 |
每一行是一个星期类别,每一列是一个时段类别,交叉位置的数字是订单数量。周三 14:00–17:00 因数据采集失败而缺失,并不代表没有订单。
制作前应先补齐完整的 7×4 分类组合,再将实际聚合值填入对应单元格。对于没有订单但确认数据完整的组合,填入 0;对于采集失败、未统计或不可用的组合,保留缺失状态。
如果分析对象改成产品与地区,也可以沿用相同结构:行是产品类别,列是地区,单元格是该产品在该地区的销售额。此时必须确认各单元格采用同一货币、统计周期与销售额口径。
设置能够正确比较数值的色阶
订单数是具有大小顺序的定量指标,因此采用由浅到深的单色顺序色阶,而不是用红、绿、蓝等无明显大小次序的颜色随机编码。
对于这组最大值为 54 的示例数据,可以设置六档色阶:
| 订单数区间 | 填充色 | 视觉含义 |
|---|---|---|
| 0–9 | #EFF5FA |
最浅,低值 |
| 10–19 | #D8E9F5 |
较浅 |
| 20–29 | #B2D3EB |
中低值 |
| 30–39 | #7DAFD6 |
中高值 |
| 40–49 | #3F82B7 |
较深 |
| 50–59 | #175784 |
最深,高值 |
将每个单元格按订单数量映射到对应颜色,并在格内保留原始数字。深色单元格使用白色数字,浅色单元格使用深色数字,同时检查文字与底色的对比度。
缺失值不进入上述六档色阶。建议使用带斜线纹理的中性灰色 #E4E7EB,格内标记“缺失”,并在图例中单独说明。真实的 0 则正常使用最浅一档颜色。
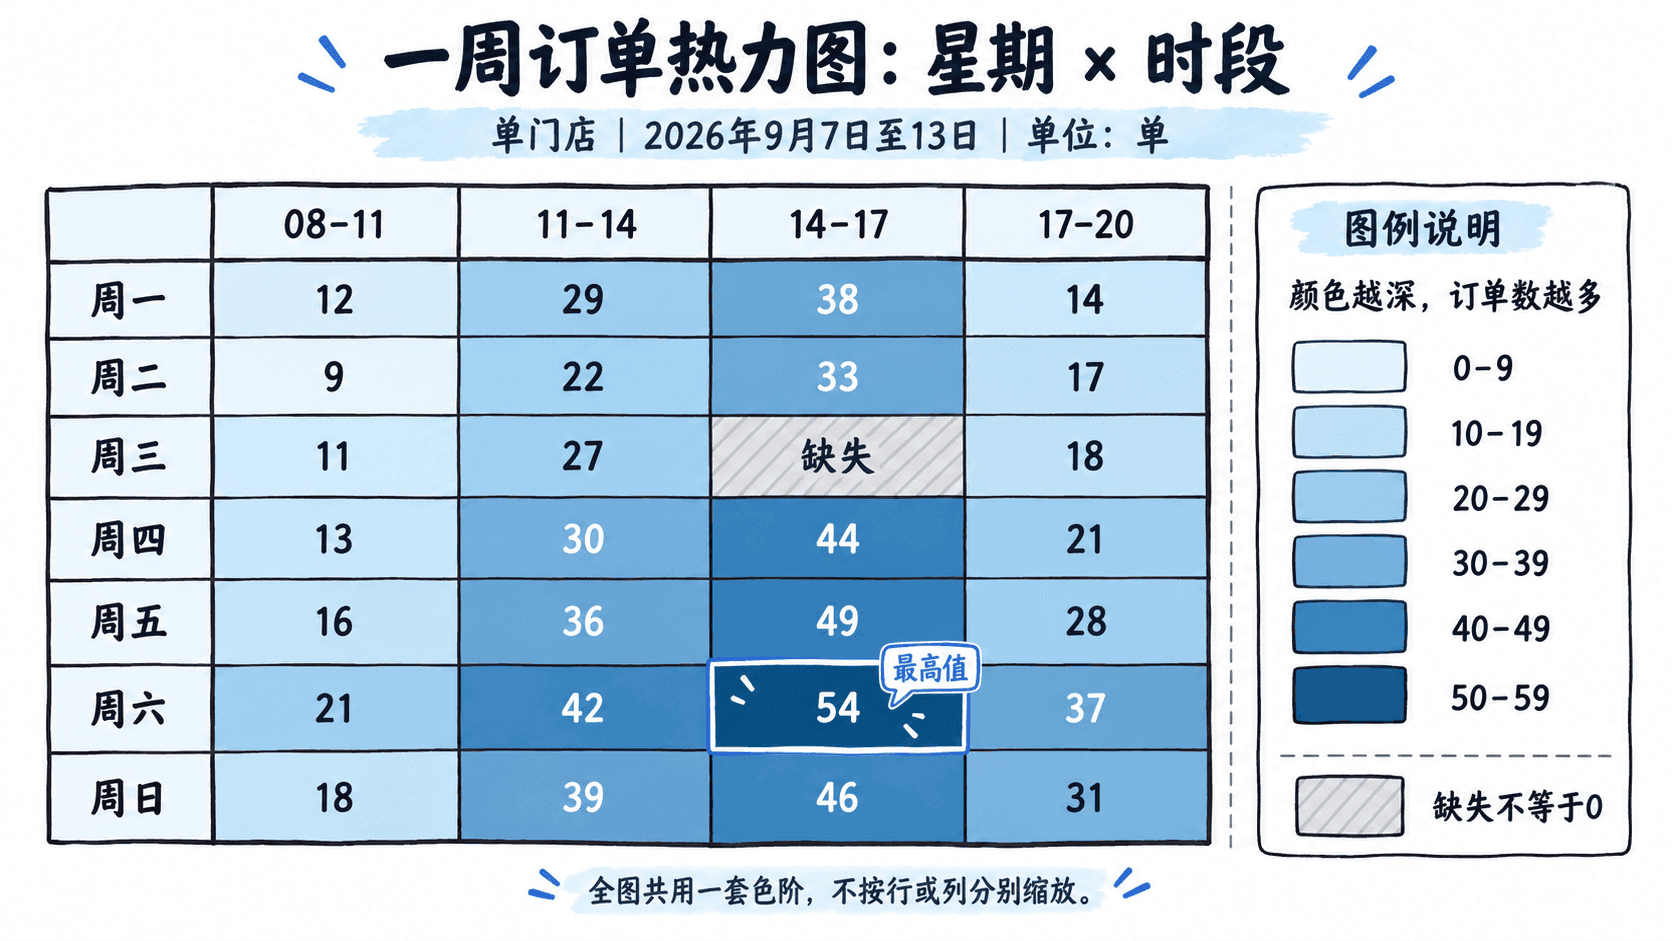
绘制时按固定阅读顺序安排内容:先读横纵轴分类,再观察色块分布,最后通过图例和单元格数字核实数值。通常不需要把 28 个单元格全部加粗或额外标注,只突出确有分析意义的极值和缺失位置。
从色块分布提取业务模式
绘制完成后,先寻找连续的深色区域,再检查孤立的高值或低值。不要只凭某一个最深色块就断言整个星期或时段的经营规律。
在示例中可以得到三个可核查的观察:
- 下午时段较集中。 周一至周日的 14:00–17:00 列出现多个深色单元格,其中周六为 54 单,是已知数据中的最高值。但周三该时段缺失,不能声称七天数据完整。
- 周末午后订单较多。 周六 14:00–17:00 为 54 单,周日为 46 单;与周一同一时段的 38 单相比,分别多 16 单与 8 单。
- 上午存在低值区域。 周二 08:00–11:00 只有 9 单,是已知单元格的最低值;周一至周四的上午订单量均低于 14 单。
这些观察可以支持进一步安排人员、分析促销或检查门店客流,但还不能直接证明高峰由星期或时段本身造成。天气、促销活动、营业安排和样本周期都可能影响订单量。
尤其需要区分“颜色更深”和“数值按比例增加”。例如周五 14:00–17:00 的 49 单与周六的 54 单落在不同色阶,但实际只相差 5 单,约增加 10.2%。反过来,同处 40–49 档的 40 单与 49 单会使用同一种颜色,却相差 9 单。
因此,分档热力图适合快速寻找相对高低和空间聚集模式;需要判断精确差额或百分比时,应查看单元格数字或原始数据。
检查缺失值、指标口径与可比性
热力图正式交付前,至少检查三类容易改变结论的问题。
首先检查数据完整性。周三下午的采集失败必须单独标记。如果直接填 0,图上就会出现一个虚假的极低值;如果自动使用前后日期插值,又会让读者把估算数据当成真实订单。除非有明确的数据补全规则,否则保持缺失并说明原因。
其次检查指标是否适合直接比较。订单数反映规模,不必然反映下单效率。假设周六 14:00–17:00 有 54 单、600 名访客,周四同一时段有 44 单、200 名访客,则:
- 周六每百访客订单数:54 ÷ 600 × 100 = 9 单。
- 周四每百访客订单数:44 ÷ 200 × 100 = 22 单。
周六在订单数热力图中颜色更深,但周四的每百访客订单数更高。若问题变成“哪个时段单位客流的订单产出更高”,就应使用统一定义的标准化指标重新绘图,而不是沿用原始订单数色阶。
最后检查展示规则:
- 行列保持自然顺序,星期一至星期日、上午至晚上,不按当前数值大小随意重排。
- 图例写明指标名称、单位、区间端点和缺失值含义。
- 同一张图只使用一套数值到颜色的映射规则,不对单独行列重新归一化。
- 所有单元格包含数字或能够准确读取数值的交互提示,避免完全依赖颜色辨认。
- 如果多张图需要横向比较,统一统计口径与色阶范围;如果每张图单独缩放,必须清楚标明不能直接按颜色跨图比较。
可以用两个问题完成验收:读者能否一眼找到订单高峰集中在哪些星期与时段?读者能否准确区分 0、缺失以及不同颜色对应的数值区间?两项都满足,热力图才能同时承担模式发现与准确沟通的任务。