
多人游戏与网络同步 / 系统课时
用指标判断补偿是否过头
用指标判断补偿是否过头
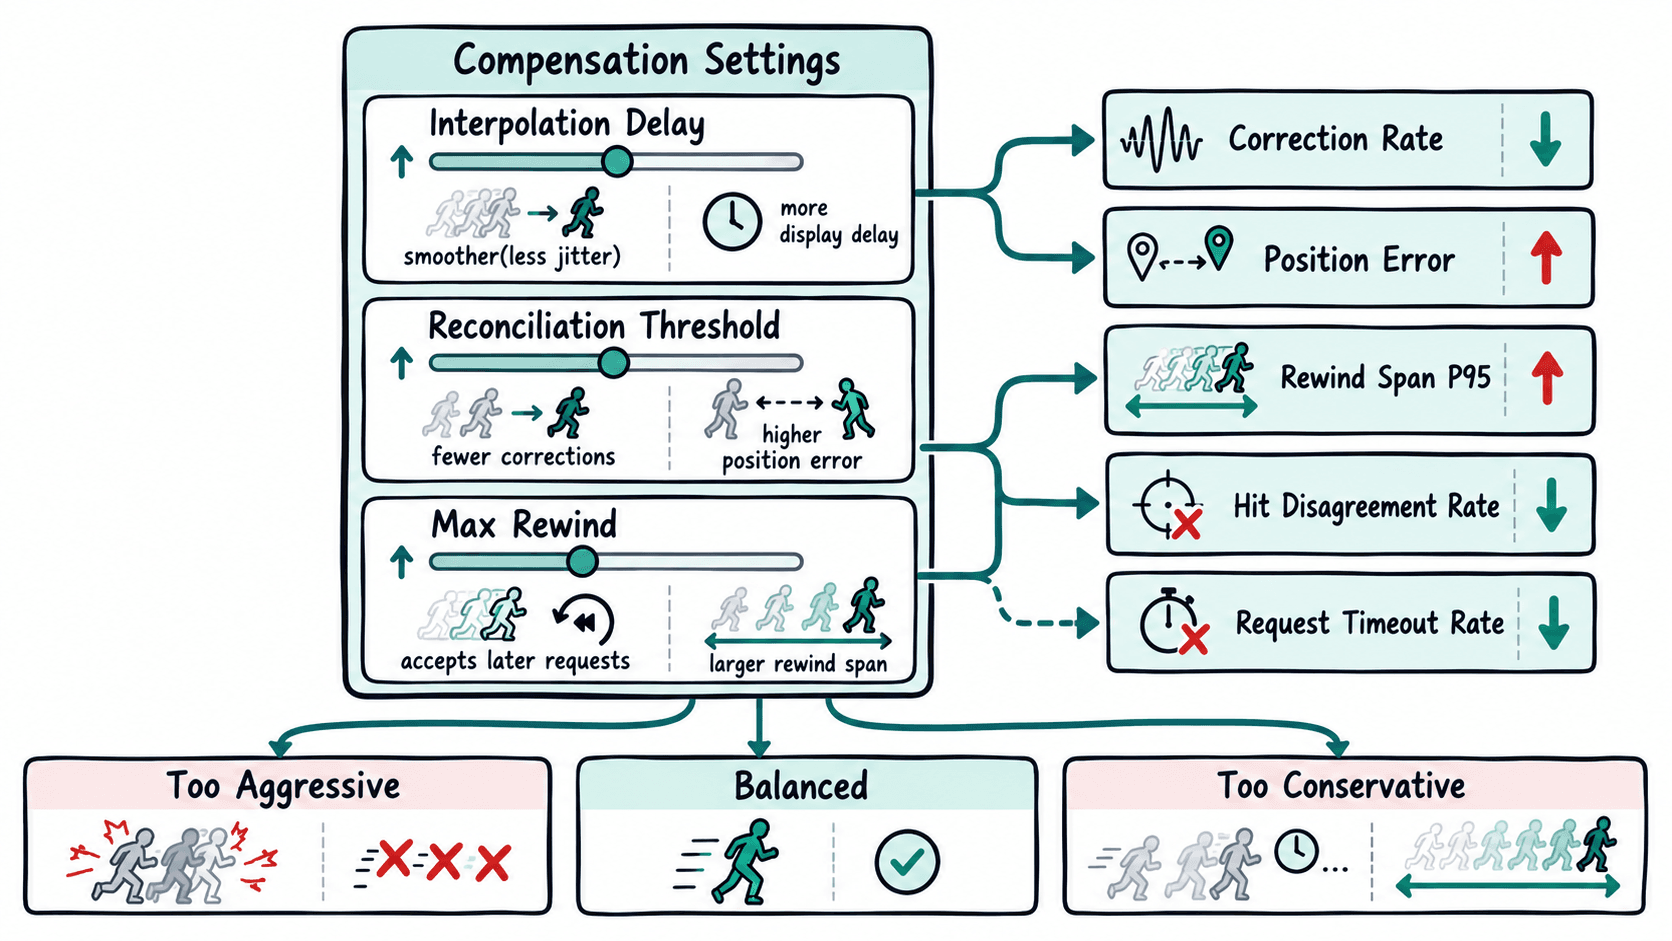
延迟补偿调得越激进,画面不一定越好:更大的插值窗口会增加显示延迟,更宽的纠正容差可能掩盖位置偏差,更长的回溯又可能让过旧请求获得命中。本课把这些现象变成可统计指标,用数据判断补偿是在稳定体验,还是已经超过合理范围。
学习目标
- 采集纠错、位置误差、回溯跨度、命中差异和超时五类核心指标
- 使用统一采样口径计算比率、均值和高分位值
- 根据指标组合识别插值、预测和回溯策略是否过度补偿
五类指标分别回答什么问题
纠错次数反映客户端预测多久被服务器权威状态推翻一次。纠错偶尔发生是正常的,但在网络条件不变时突然升高,通常意味着预测模型、输入确认或纠正阈值存在问题。
位置误差应记录纠正前客户端位置与服务器权威位置之间的距离。只看纠错次数不够:一天纠正十次但每次只有几厘米,与十次一米级瞬移完全不是同一个严重程度。
回溯跨度表示服务器为了验证历史射击而回到多早的状态。平均值能够反映常态,高分位值更容易发现偶发的大跨度请求。命中差异率则统计客户端预测命中与服务器最终判定不一致的比例。
最后是请求超时率。如果为了等待迟到数据而不断扩大窗口,画面可能稳定了,但请求生命周期会被拉长。超时率可以帮助发现这种隐藏代价。
建立统一的采样记录
指标必须来自同一批测试事件,否则无法互相解释。一次移动或射击采样至少应保留是否发生纠正、纠正前位置误差、实际回溯毫秒数、客户端命中结果、服务器命中结果和是否超时。
位置误差最好在纠正发生前采集;回溯跨度以服务器实际采用的历史时刻计算,而不是直接拿 RTT 代替。命中差异只比较同一个射击请求的客户端预测和服务器最终结果,避免把不同请求混在一起。
用脚本汇总一批测试数据
下面的完整 Python 示例演示如何从一次测试中的采样计算纠错率、平均位置误差、回溯跨度 P95、命中差异率和超时率。示例数据固定,因此可以直接运行并核对计算逻辑。
import math

samples = [
    {"corrected": 1, "position_error": 0.42, "rewind_ms": 95, "client_hit": 1, "server_hit": 1, "timeout": 0},
    {"corrected": 0, "position_error": 0.08, "rewind_ms": 70, "client_hit": 1, "server_hit": 1, "timeout": 0},
    {"corrected": 1, "position_error": 0.65, "rewind_ms": 140, "client_hit": 1, "server_hit": 0, "timeout": 0},
    {"corrected": 1, "position_error": 0.31, "rewind_ms": 110, "client_hit": 0, "server_hit": 0, "timeout": 0},
    {"corrected": 0, "position_error": 0.05, "rewind_ms": 60, "client_hit": 1, "server_hit": 1, "timeout": 1},
]

count = len(samples)
correction_rate = sum(item["corrected"] for item in samples) / count
mean_error = sum(item["position_error"] for item in samples) / count

rewinds = sorted(item["rewind_ms"] for item in samples)
p95_index = max(0, math.ceil(0.95 * count) - 1)
rewind_p95 = rewinds[p95_index]

hit_disagreement_rate = sum(
    item["client_hit"] != item["server_hit"] for item in samples
) / count
timeout_rate = sum(item["timeout"] for item in samples) / count

print(f"correction_rate={correction_rate:.1%}")
print(f"mean_position_error={mean_error:.3f}")
print(f"rewind_p95_ms={rewind_p95}")
print(f"hit_disagreement_rate={hit_disagreement_rate:.1%}")
print(f"timeout_rate={timeout_rate:.1%}")
预期输出:
correction_rate=60.0%
mean_position_error=0.302
rewind_p95_ms=140
hit_disagreement_rate=20.0%
timeout_rate=20.0%
真实项目中样本量应远大于 5 条,并按网络条件、角色状态、武器或地图场景打标签。只有这样,某个指标升高时才能继续定位是所有场景都恶化,还是只发生在特定路径。
看组合而不是追单个数字
没有一个通用阈值能够适用于所有游戏。角色移动速度、服务器 Tick 率、武器判定方式和允许的回溯窗口不同,合理范围也不同。因此更可靠的方法是先建立健康网络下的基线,再比较同一场景在压力网络和不同补偿参数下的变化。
| 指标变化 | 可能说明 |
|---|---|
| 纠错率下降,但位置误差升高 | 纠正阈值可能放得过宽 |
| 回溯 P95 持续增大 | 服务器正在接受越来越旧的请求 |
| 命中差异率升高 | 客户端预测与权威历史状态开始分离 |
| 超时率下降,但回溯跨度大幅上升 | 可能通过延长等待或回溯窗口掩盖迟到请求 |
| 位置误差和纠错率同时升高 | 预测或输入确认链路本身可能失稳 |
判断“补偿过头”的关键不是某个指标绝对值大,而是为了压低一个现象,另一个代价持续扩大。例如把最大回溯从 150 ms 调到 300 ms 后,命中差异率从 8% 降到 5%,但回溯 P95 升到 280 ms,就需要进一步判断这种旧状态命中是否符合游戏规则,而不能只宣布命中率改善。
调参时保持因果关系
一次实验只修改一个补偿参数,并保存网络条件、版本、样本量和核心指标。先跑基线,再跑压力场景,最后比较变化方向。若同时修改插值延迟、纠正阈值和最大回溯,即使结果变好,也无法知道真正有效的是哪一个参数。
调试的目标不是把纠错次数、误差和超时全部压到零,而是在可接受的视觉延迟、状态一致性和战斗公平性之间取得稳定平衡。只要指标能够持续回答“改善了什么、牺牲了什么”,补偿方案就从主观手感调试变成了可验证的工程系统。