
多人游戏与网络同步 / 系统课时
高 RTT 时先查网络还是逻辑
高 RTT 时先查网络还是逻辑
高 RTT 并不自动等于“网络坏了”。本课把一次输入到画面反馈拆成网络往返、服务器等待与处理、客户端应用与渲染三段,用同一条请求的时间证据判断先查哪一层,避免凭感觉调补偿参数。
学习目标
- 区分 RTT、服务器处理耗时和最终可见延迟
- 用同一次请求的时间戳判断延迟主要产生在哪一层
- 建立网络、服务器 Tick、客户端渲染的固定排查顺序
先拆开一次可见延迟
玩家感受到的是“按下输入后多久看到可信结果”,而 RTT 只覆盖请求发出到响应返回这一段。服务器可能在收到请求后等待下一个 Tick,也可能因逻辑、锁竞争或队列堆积延迟响应;响应到达客户端后,还可能等待快照处理、状态纠正和下一帧渲染。
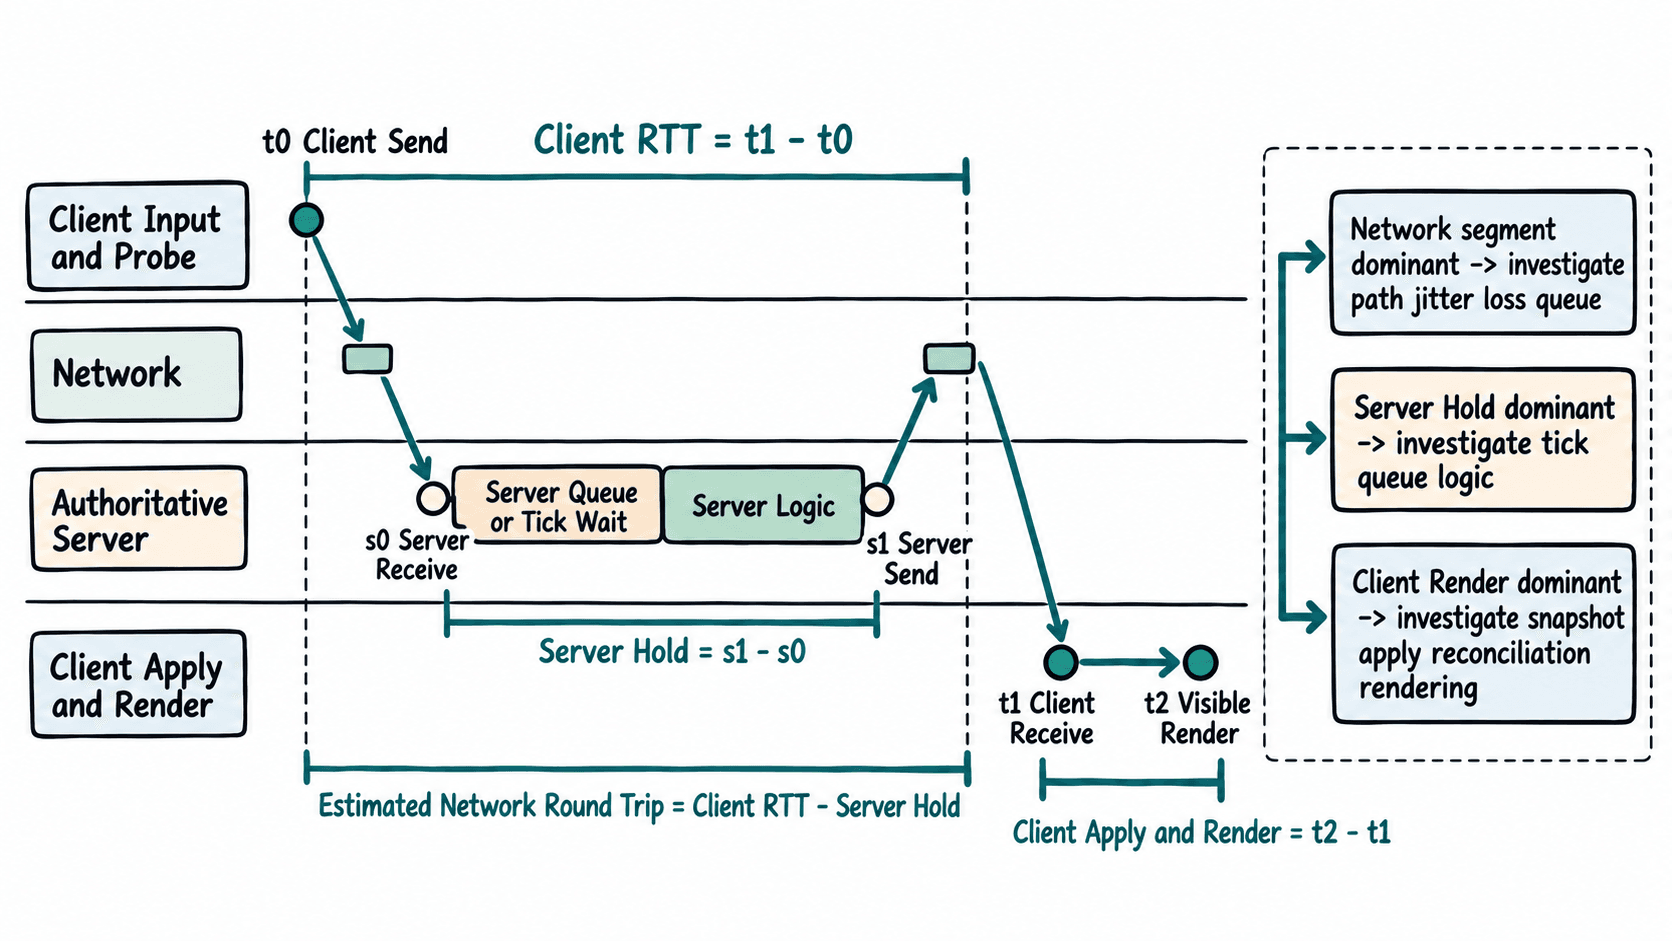
因此不要看到一个 150 ms 的数字就直接调整预测或插值。先确认这个 RTT 是纯探测包的往返时间,还是业务消息从发送到服务器处理完成再返回的时间;后者本身可能包含服务器逻辑耗时。
用同一请求采四段时间
最实用的记录包含客户端发送和接收时间,以及服务器收到和发出时间。客户端两个时间戳来自同一时钟,服务器两个时间戳也来自同一时钟,因此计算各自的时间差并不要求两台机器时钟完全同步。
下面用一组已经采集的毫秒数据判断主要耗时。示例假定服务器收到探测后完成本次处理便立即响应,因此可以从客户端 RTT 中扣除服务器停留时间,得到近似的网络往返耗时。
sample = {
    'client_rtt_ms': 132,
    'server_queue_ms': 3,
    'server_logic_ms': 5,
    'client_apply_render_ms': 14,
}

# 服务器停留时间包含排队或等待 Tick,以及真正的业务处理。
server_hold = sample['server_queue_ms'] + sample['server_logic_ms']
network_round_trip = max(0, sample['client_rtt_ms'] - server_hold)
visible_latency = sample['client_rtt_ms'] + sample['client_apply_render_ms']

# 阈值用于本次示例的快速归因,真实项目应由自身延迟预算定义。
if network_round_trip > 80:
    suspect = 'network path'
elif server_hold > 20:
    suspect = 'server tick or logic'
else:
    suspect = 'client apply or render'

print(f'client RTT: {sample["client_rtt_ms"]} ms')
print(f'server hold: {server_hold} ms')
print(f'estimated network round trip: {network_round_trip} ms')
print(f'client apply/render: {sample["client_apply_render_ms"]} ms')
print(f'visible input latency: {visible_latency} ms')
print(f'primary suspect: {suspect}')
预期输出
client RTT: 132 ms
server hold: 8 ms
estimated network round trip: 124 ms
client apply/render: 14 ms
visible input latency: 146 ms
primary suspect: network path
这里的结论不是“124 ms 一定由公网造成”,而是服务器只占 8 ms,继续优化服务器逻辑无法解释主要延迟。下一步应检查路径抖动、丢包、重传或排队,而不是先修改预测算法。
按证据决定先查哪一层
如果纯探测 RTT 和业务 RTT 都明显升高,同时服务器停留时间稳定,先查网络。重点比较 RTT 的中位数、高分位值、抖动和丢包,而不是只看一次峰值;若多个玩家在同一地域或同一路径同时恶化,网络证据更强。
如果纯探测 RTT 正常,但业务 RTT 随服务器负载上升,且 server_queue_ms 或 Tick 等待明显增加,应转向服务器。常见证据是 Tick 实际间隔超过目标间隔、单 Tick 工作量突增,或者消息已经到达服务器却长时间没有被模拟逻辑消费。
如果响应已经及时到达客户端,但玩家仍晚一两帧甚至更久才看到结果,就继续检查客户端。记录快照入队、状态应用、纠错完成和实际渲染时间,可以发现缓冲策略、主线程阻塞或渲染排队造成的附加延迟。
修复后做闭环验证
修复不能只看平均 RTT 是否下降。至少在同一测试条件下重新比较网络往返、服务器停留和客户端渲染三段,并确认玩家最终看到结果的总时间同步改善。若只降低其中一段而可见延迟没有变化,说明真正瓶颈仍在后面的链路。
排查高 RTT 最稳妥的原则是先分段,再归因:网络段占主导就查网络,服务器停留占主导就查 Tick 与逻辑,包已经到达却迟迟不上屏才查客户端。这样才能避免用插值、预测或服务器优化去掩盖另一层的问题。