
多人游戏与网络同步 / 系统课时
丢包后命中请求为什么会变旧
丢包后命中请求为什么会变旧
一次开火请求即使最终到达服务器,也不代表它仍然能进入延迟补偿。丢包、重传和乱序会拉长“开火发生”到“服务器收到”的间隔;当请求超过服务器保存的历史窗口时,再准确的命中检测也只能拒绝或降级处理。
学习目标
- 用消息序号和到达时间区分丢包、乱序与重传。
- 判断一条命中请求是否已经超出服务器的补偿窗口。
- 建立可复现的日志检查方法,避免只看最终到达顺序。
先看请求为什么会变旧
战斗请求至少应携带递增的输入或开火序号,例如 shotSeq,并在客户端记录开火时刻。服务器日志则记录接收时刻、当前服务器 Tick,以及该序号是否已经处理过。这样才能回答两个不同问题:请求有没有到,以及它到达时还来不来得及补偿。
假设连续发送 101、102、103。102 首次传输丢失,随后被可靠通道或应用层重发;103 反而先到。服务器看到的到达顺序可能变成 101、103、102。此时 102 不是“新请求”,只是晚到的旧请求。
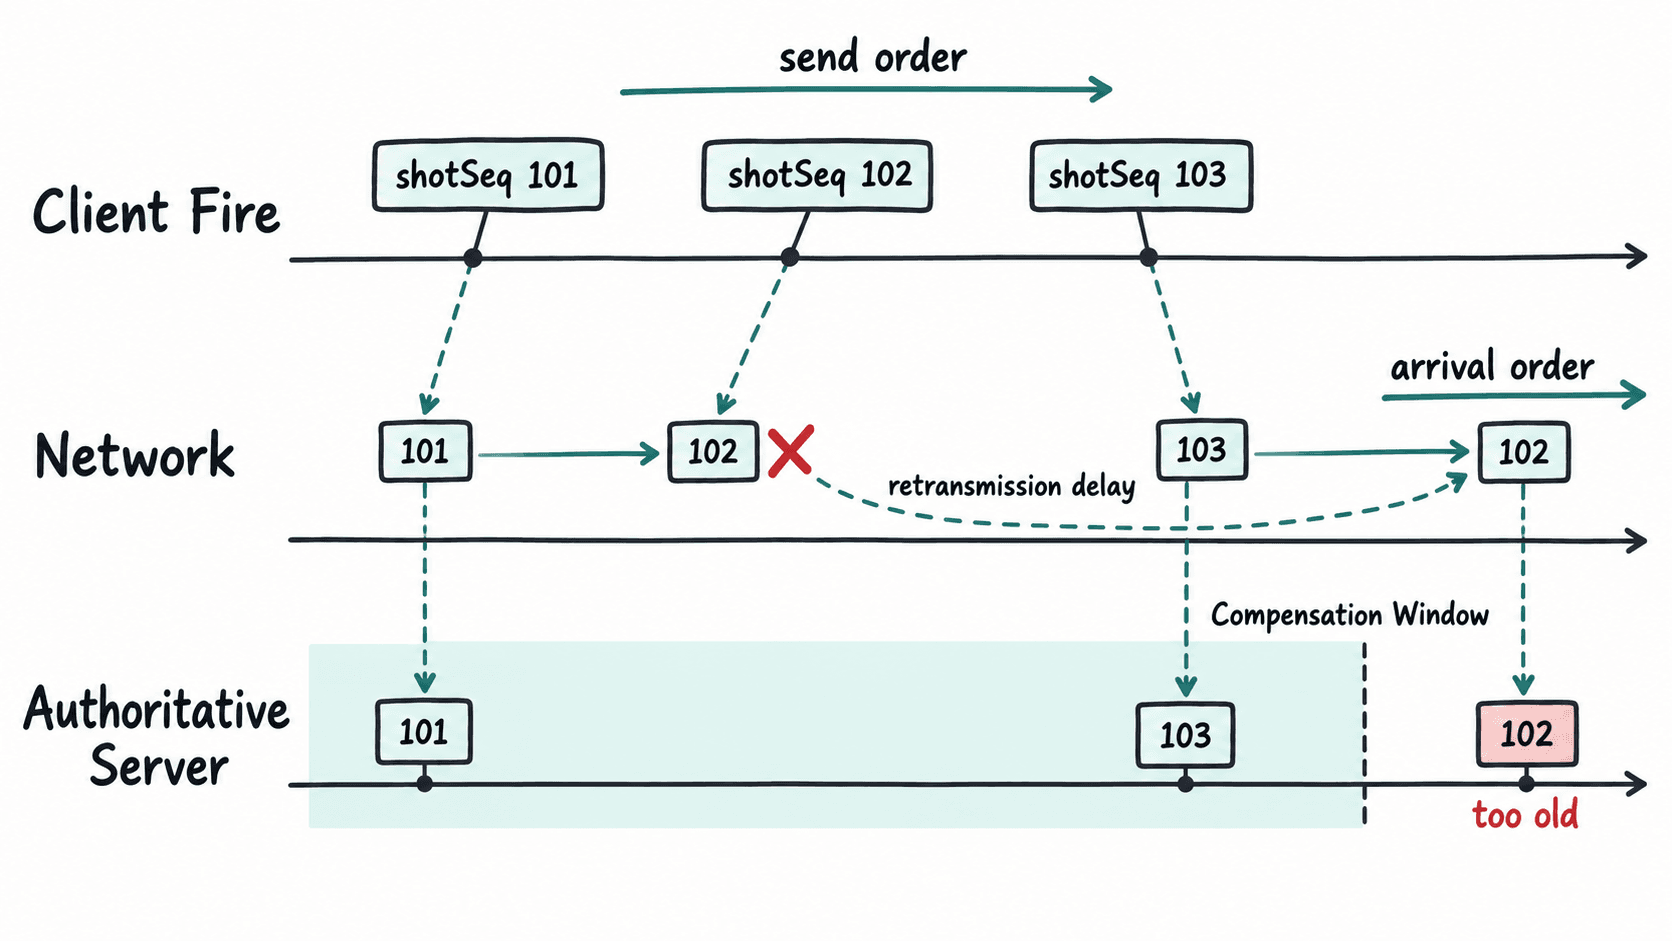
用序号和时间一起定位
只看 shotSeq 可以发现缺口和乱序,但不能判断请求是否“过期”;只看延迟又无法识别重复请求。因此日志最好同时保留这些字段:shotSeq、客户端开火时刻、服务器接收时刻、服务器当前 Tick、处理结果。
排查时按以下顺序对齐:
- 先按
shotSeq检查是否存在缺号、重复号或倒序到达。 - 再比较每条请求的发送时刻和接收时刻,找出异常长的单向等待。
- 最后将请求年龄与服务器允许的补偿窗口比较,确认是“网络晚到”还是“服务器拒绝补偿”。
用最小脚本复现过期请求
下面的脚本把发送和到达时间放在同一测试时钟中,模拟 102 丢包后重传。生产环境的客户端时钟与服务器时钟不能直接这样相减,时间基准问题需要单独处理。
events = [
    {"seq": 101, "sent_ms": 1000, "arrival_ms": 1080},
    {"seq": 102, "sent_ms": 1050, "arrival_ms": 1360},
    {"seq": 103, "sent_ms": 1100, "arrival_ms": 1180},
]

compensation_window_ms = 200

for event in sorted(events, key=lambda item: item["arrival_ms"]):
    age_ms = event["arrival_ms"] - event["sent_ms"]
    status = "eligible" if age_ms <= compensation_window_ms else "too_old"
    print(event["seq"], age_ms, status)
预期输出:
101 80 eligible
103 80 eligible
102 310 too_old输出同时暴露了两个事实:103 比 102 先到,说明发生了乱序;102 的请求年龄达到 310 ms,超过 200 ms 的补偿窗口,所以即使它没有重复处理,也不该再按原开火时刻做完整回溯。
服务器应该怎样处理晚到请求
服务器通常需要把“去重”和“是否可补偿”拆成两个判断。先用 shotSeq 或唯一请求 ID 拒绝已经处理过的重传,再检查请求对应的历史时刻是否仍在快照缓冲范围内。超窗请求可以明确拒绝、按当前状态判定,或采用游戏规则定义的降级策略,但不能悄悄套用最老的一帧历史状态。
真正可操作的定位证据不是“网络有丢包”这一句,而是能够指出:哪个序号首次缺失、何时重传、何时到达、到达时距原始开火已经多久,以及服务器的历史窗口从哪里开始。只要这条时间链能闭合,就能判断补偿失效究竟发生在传输层还是历史状态边界。