
多人游戏与网络同步 / 系统课时
怎样记录一次移动为什么异常
怎样记录一次移动为什么异常
多人移动出现回弹、停顿或突然加速时,只看最终位置通常无法判断原因。这一课建立一条可回放的调试记录:保存快照时间、渲染时间、位置误差和预测状态,让一次异常移动可以按时间线重新检查。
学习目标
- 设计能够解释一次异常移动的最小调试字段
- 在角色更新过程中记录服务器状态、客户端渲染和预测结果
- 根据单次记录区分延迟、预测偏差与权威纠正
记录什么才足够定位
一次异常至少需要同时保留四类信息:服务器快照是什么时候生成的,客户端准备渲染什么时刻,当前视觉位置与权威位置差多少,以及当时是否处于预测状态。
可以把一条记录理解成一个时间切片,而不是一堆散落日志。建议每条记录拥有 tick 或序号,并统一使用毫秒时间戳。这样后续回放时可以按照时间排序,而不是依赖日志到达顺序。
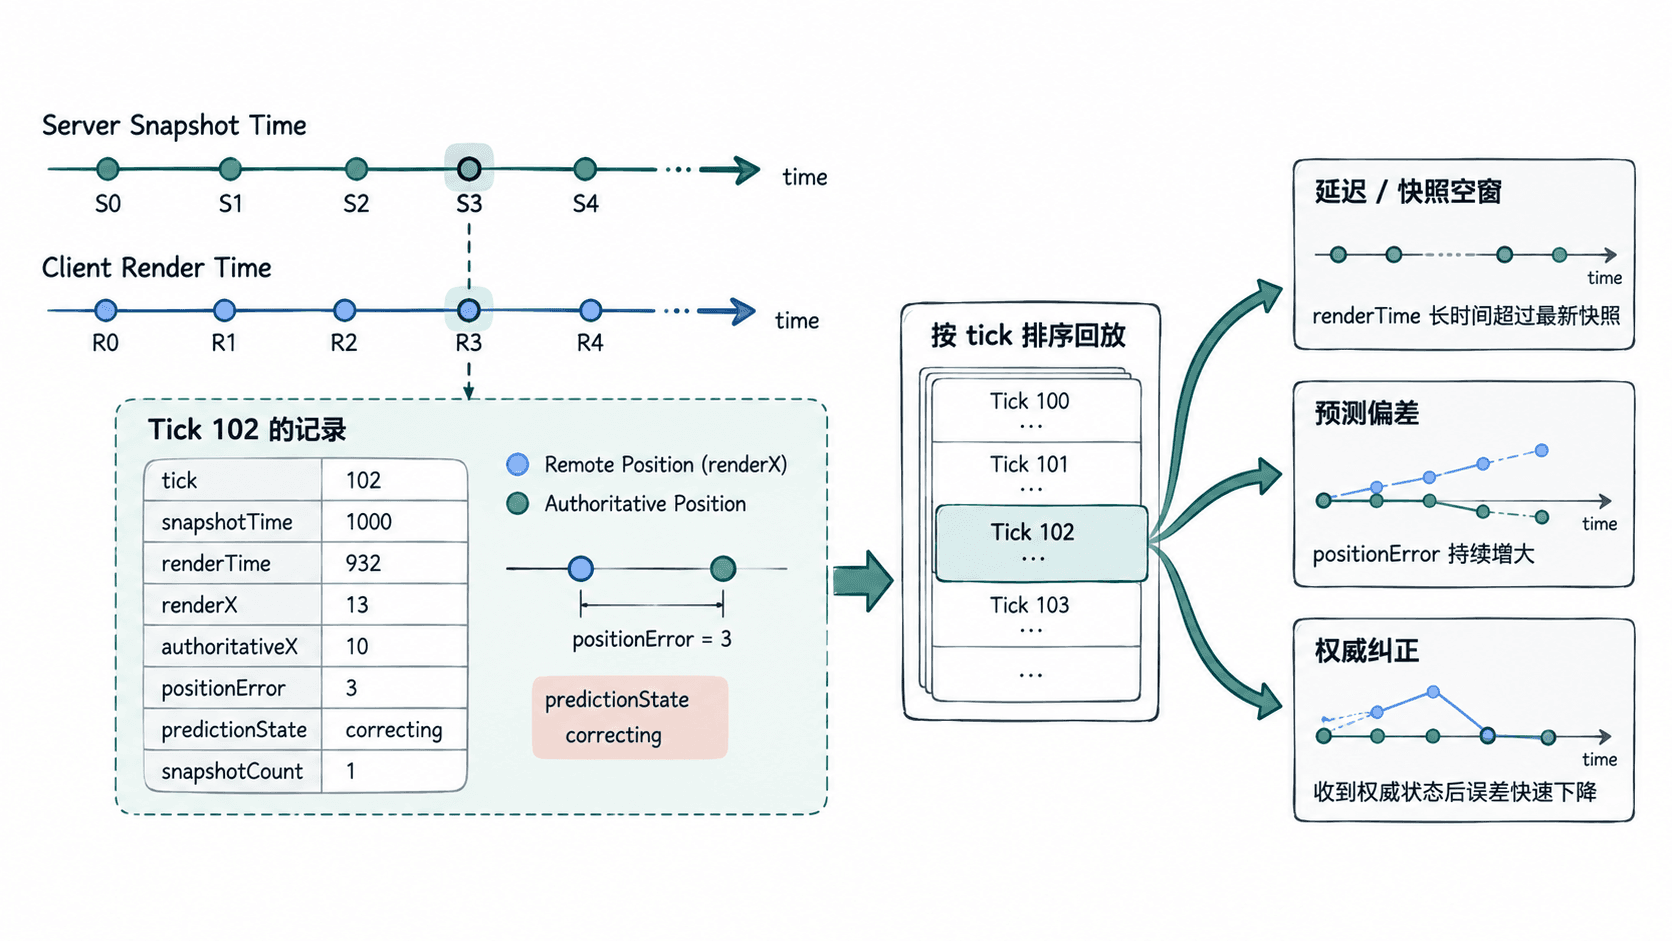
设计一条可回放记录
调试记录不必保存整个游戏世界。对移动链路而言,下面这些字段已经能解释大多数单次异常:
| 字段 | 作用 |
|---|---|
tick |
标识逻辑更新顺序,便于回放和对齐 |
snapshotTime |
最近权威快照携带的服务器时间 |
renderTime |
当前客户端实际采样的目标时间 |
renderX |
本帧准备显示的位置 |
authoritativeX |
当前可得到的权威位置 |
positionError |
renderX 与 authoritativeX 的距离 |
predictionState |
例如 idle、predicting、correcting |
snapshotCount |
当前缓存中可用快照数量 |
其中 positionError 最好直接记录计算后的结果,而不是只记录两个原始位置。排查时可以立刻按误差阈值过滤异常样本。
用代码记录一次异常
下面是一个可独立运行的 Node.js 示例。它模拟几个移动采样点,把异常时刻写入内存数组,然后筛出位置误差较大的记录。
const debugLog = [];

function recordMovement(data) {
  const entry = {
    tick: data.tick,
    snapshotTime: data.snapshotTime,
    renderTime: data.renderTime,
    renderX: data.renderX,
    authoritativeX: data.authoritativeX,
    positionError: Math.abs(data.renderX - data.authoritativeX),
    predictionState: data.predictionState,
    snapshotCount: data.snapshotCount,
  };

  debugLog.push(entry);
  return entry;
}

recordMovement({
  tick: 100,
  snapshotTime: 1000,
  renderTime: 900,
  renderX: 9,
  authoritativeX: 10,
  predictionState: "predicting",
  snapshotCount: 3,
});

recordMovement({
  tick: 101,
  snapshotTime: 1000,
  renderTime: 916,
  renderX: 10,
  authoritativeX: 10,
  predictionState: "idle",
  snapshotCount: 3,
});

recordMovement({
  tick: 102,
  snapshotTime: 1000,
  renderTime: 932,
  renderX: 13,
  authoritativeX: 10,
  predictionState: "correcting",
  snapshotCount: 1,
});

const anomalies = debugLog.filter((entry) => entry.positionError >= 2);

console.log(JSON.stringify(anomalies, null, 2));
预期输出
[
  {
    "tick": 102,
    "snapshotTime": 1000,
    "renderTime": 932,
    "renderX": 13,
    "authoritativeX": 10,
    "positionError": 3,
    "predictionState": "correcting",
    "snapshotCount": 1
  }
]
这里故意让异常记录同时出现较大的 positionError、correcting 状态和只有一份缓存快照。它并不能单独证明根因,但已经提供了下一步调查所需的时间关系。
从单条记录还原异常
回放时先按 tick 或逻辑时间排序,再同时观察 snapshotTime 和 renderTime。若 renderTime 长时间逼近甚至超过最新快照,优先检查网络抖动、快照频率和插值延迟;若快照连续但 positionError 持续增大,则更值得检查客户端预测模型。
当异常发生后快速下降到接近零,且状态进入 correcting,通常说明权威状态已经到达并触发纠正。此时应继续比较纠正前后的速度、碰撞状态和输入,而不是只盯着最终位置。
控制日志成本
开发阶段可以记录完整采样,线上环境则应限制频率和保留周期。更实用的方式是保留固定长度环形缓冲,并在检测到大误差、状态切换或快照数量异常时导出这一小段上下文。
最终的目标不是“日志越多越好”,而是从一条异常记录中回答三个问题:客户端当时在渲染哪个时间点,手里有哪些权威数据,以及预测结果与权威结果偏离了多少。只要这三件事能被稳定还原,移动同步问题就从肉眼观察变成了可复现、可比较的时间序列问题。