
多人游戏与网络同步 / 系统课时
外推多久开始明显不可信
外推多久开始明显不可信
外推并没有一个对所有游戏都适用的固定安全时长。真正需要确定的是:在给定网络延迟和运动变化强度下,预测多长时间后位置误差开始达到玩家能感知或玩法不能接受的范围。本篇用小型实验建立“预测时长—误差”的关系,并据此确定窗口。
先把外推窗口定义清楚
设最新可靠快照的时间为 ,客户端预测到 。其中 就是外推窗口。窗口越短,预测承担的风险越小;窗口越长,客户端越不容易出现停顿,但模型错误会有更多时间积累。
网络延迟决定了客户端需要填补多大的空窗,运动变化决定了这个空窗有多难预测。同一个 100 ms 延迟,在直线匀速移动中可能几乎没有问题,在高速转向或频繁碰撞的对象上却可能迅速失真。
用实验寻找可接受窗口
不要先拍脑袋规定“最多外推 200 ms”,而是固定一种运动模型,再逐步改变预测时长和运动变化幅度。下面的示例用一个简化模型计算:延迟越大,客户端需要预测得越远;转向变化越强,预测误差增长越快。
import math

speed = 6.0
latencies = (0.05, 0.10, 0.20)
turn_rates = (0.0, 1.0, 2.0)  # rad/s,数值越大表示转向越剧烈
horizons = (0.05, 0.10, 0.15, 0.20, 0.30)


def error_for(horizon: float, latency: float, turn_rate: float) -> float:
    # 简化实验:把转向造成的轨迹偏差近似为二阶增长项。
    effective = max(horizon, latency)
    return speed * turn_rate * effective * effective / 2

print("latency  turn_rate  horizon  error(m)")
for latency in latencies:
    for turn_rate in turn_rates:
        for horizon in horizons:
            error = error_for(horizon, latency, turn_rate)
            print(f"{latency:7.2f}  {turn_rate:9.1f}  {horizon:7.2f}  {error:7.2f}")
预期输出
latency  turn_rate  horizon  error(m)
   0.05        0.0     0.05     0.00
   0.05        0.0     0.10     0.00
   0.05        1.0     0.10     0.03
   0.05        1.0     0.20     0.12
   0.05        2.0     0.30     0.54
   0.10        1.0     0.20     0.12
   0.10        2.0     0.30     0.54
   0.20        1.0     0.10     0.12
   0.20        2.0     0.30     0.54
实际运行时会输出完整组合,数值取决于这个简化模型;这里重点观察的是单调趋势,而不是把公式当成真实游戏物理。正式项目应直接从回放或在线采样数据计算真实位置误差。
找到“开始明显不可信”的拐点
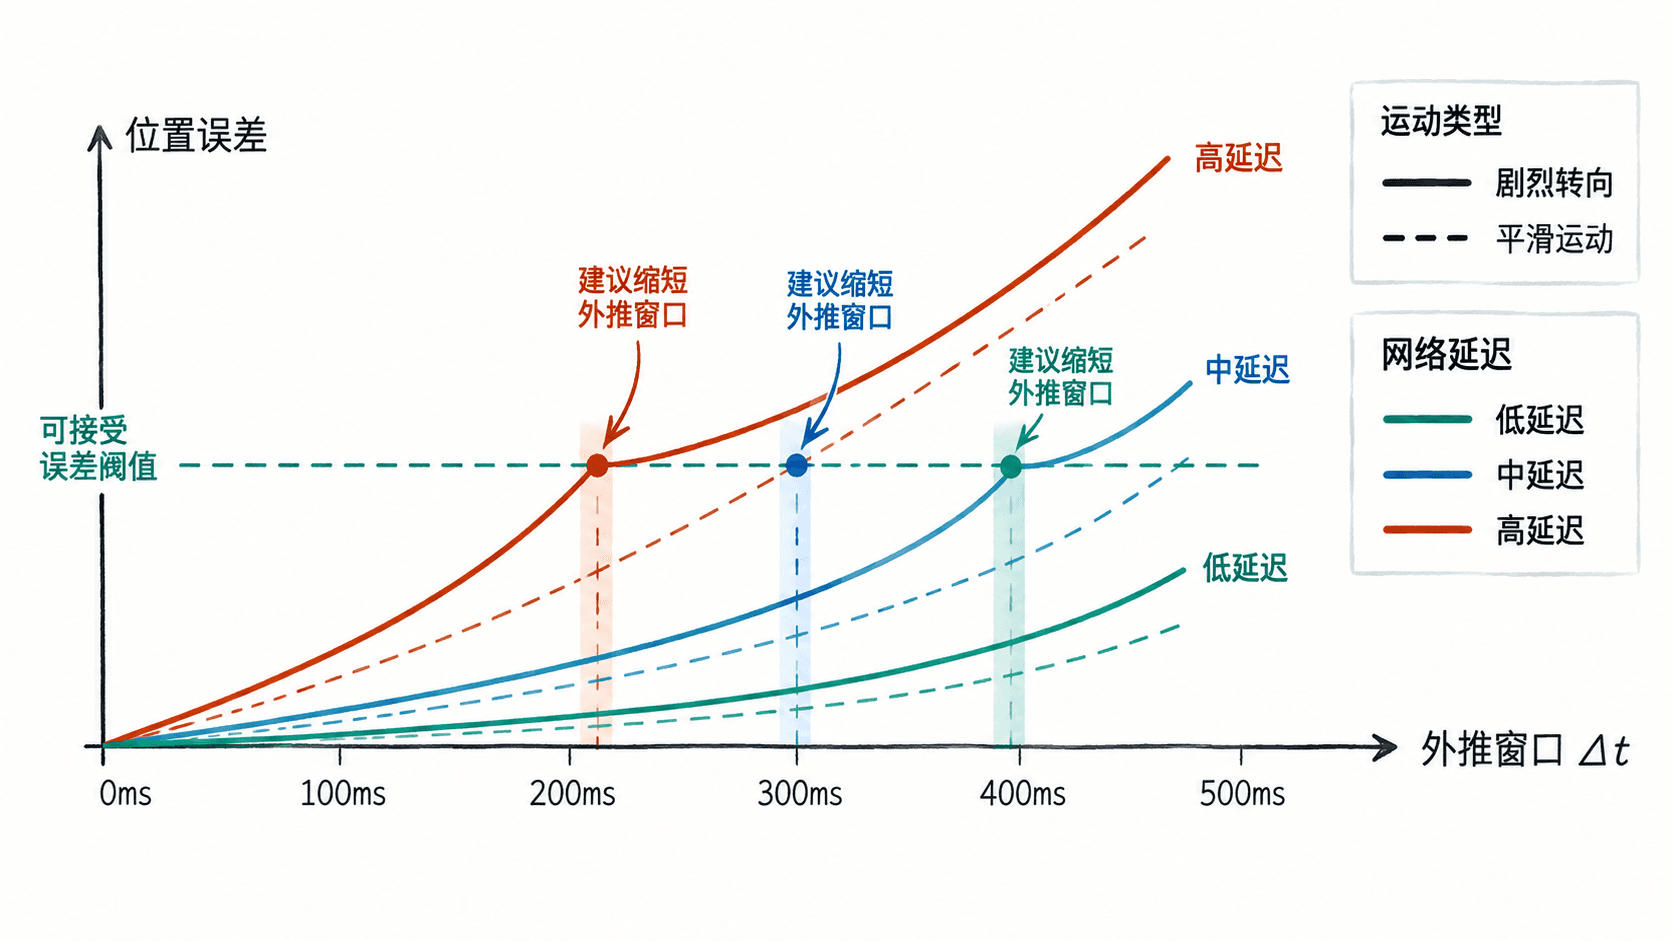
实际测试时,可以先定义一个业务阈值,例如角色允许的平均位置误差为 0.25 m,再从短窗口开始逐步增加预测时间。一旦误差稳定超过阈值,就把该区间视为“不适合继续外推”的区域。
更可靠的方法是同时记录网络延迟、对象速度、转向幅度和真实服务端位置。将客户端预测位置与随后到达的权威位置对齐,计算每个窗口的误差,然后按运动类型分别统计。这样得到的不是一个抽象的“200 ms”,而是“当前地图和对象类型下,在某种网络条件下通常可安全预测多久”。
把测试结果变成运行策略
窗口确定后,不一定要用一个固定常数覆盖所有对象。对于高速、急转向对象,可以使用更短的外推预算;对于低速、近似匀速对象,可以允许更长的窗口。网络条件明显变差时,也可以进入降级策略,让新的快照到达后更快重新校正。
一个实用的判断思路是:预测收益来自减少停顿,预测代价来自位置误差。 当误差曲线已经超过玩法容忍度,继续外推通常只是在积累更严重的纠正跳变。此时宁可缩短窗口或退回等待,也不要为了“看起来持续移动”而无限延长预测。
最终的窗口应通过真实回放数据验证,而不是只由理论公式决定。测试至少覆盖低延迟、高延迟、平滑移动、连续转向和碰撞恢复几类场景;把误差阈值、最大外推时长和降级条件写成可调参数,才能在上线后根据真实网络环境继续校准。