
多人游戏与网络同步 / 系统课时
预测失败后如何回到服务器状态
预测失败后如何回到服务器状态
外推只能暂时填补最新快照尚未到达的空窗。一旦服务器状态重新到达,客户端必须明确结束预测、接管权威状态,并把显示位置平滑拉回正确轨迹,否则就会持续漂移或突然跳变。
学习目标
- 理解外推结束时为什么必须由服务器状态重新接管
- 设计预测结束、误差计算和平滑回归的状态边界
- 用最小代码验证不同误差下的接管结果
外推结束的边界
客户端在没有更新快照时,可以按照最近速度继续计算预测位置,例如当前位置为 ,速度为 ,经过 后得到 。这个位置只是临时结果,不具备权威性。
新的服务器快照到达后,权威位置变为 。此时最重要的动作不是继续沿用旧预测,而是把预测阶段结束标记出来,并计算误差 。从这一刻开始,服务器状态重新成为后续运动的基准。
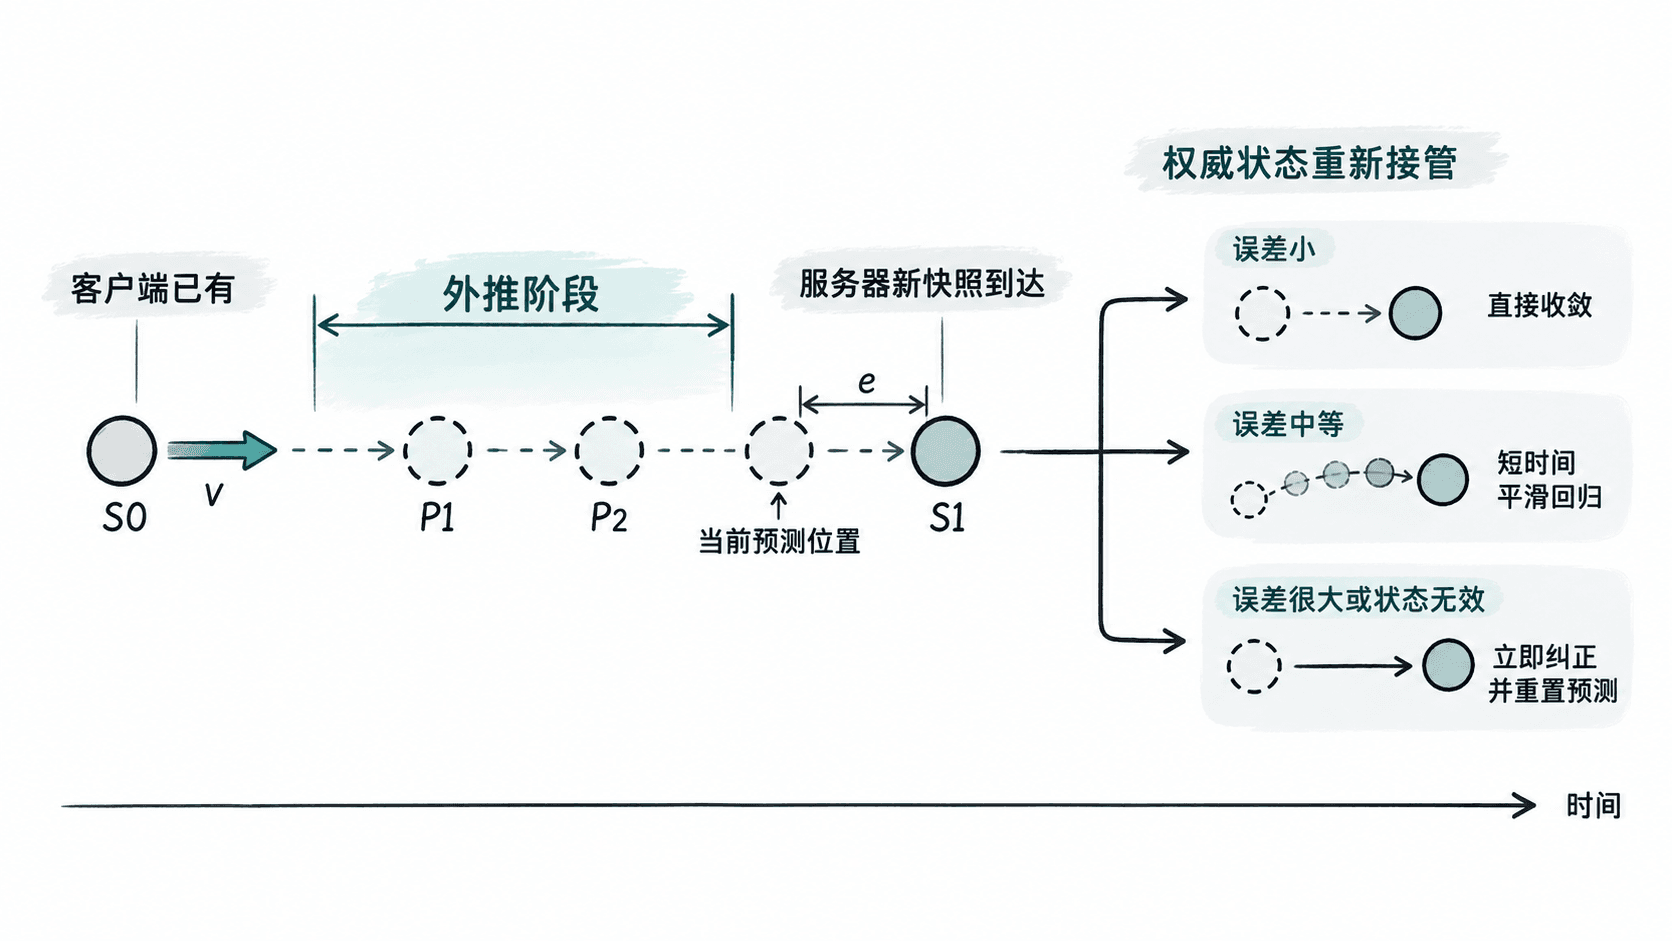
先接管,再修正显示位置
推荐把逻辑状态和渲染状态分开。逻辑状态在新快照到达后立即切换到服务器值;渲染状态则根据误差大小决定如何接近这个新目标。这样可以保证后续输入、碰撞和继续外推都基于权威状态,而不会把已经失效的预测继续传下去。
一个实用的规则是设置误差阈值。小误差通常来自浮点计算或轻微时序差异,可以在若干帧内平滑消化;较大误差可能意味着碰撞、急停、转向或丢失多个快照,此时继续慢慢拉回会制造明显的位置滞后,应直接纠正并重新开始预测。
用最小模型验证接管策略
下面的 Python 示例模拟一次“预测位置”和“服务器位置”重新对齐的过程。示例把误差分成三档:小于 0.25 直接收敛,0.25 到 2 之间在限定帧数内平滑回归,大于 2 立即重置。
from dataclasses import dataclass


@dataclass
class ReconcileResult:
    mode: str
    positions: list[float]


def reconcile(predicted: float, authoritative: float) -> ReconcileResult:
    error = authoritative - predicted

    if abs(error) < 0.25:
        return ReconcileResult("snap-to-authority", [authoritative])

    if abs(error) <= 2.0:
        frames = 4
        step = error / frames
        positions = [round(predicted + step * i, 2) for i in range(1, frames + 1)]
        return ReconcileResult("smooth-reconcile", positions)

    return ReconcileResult("hard-correct", [authoritative])


def main() -> None:
    cases = [
        (10.10, 10.20),
        (10.00, 11.00),
        (10.00, 13.00),
    ]

    for predicted, authoritative in cases:
        result = reconcile(predicted, authoritative)
        print(result.mode, result.positions)


if __name__ == "__main__":
    main()
预期输出:
snap-to-authority [10.2]
smooth-reconcile [10.25, 10.5, 10.75, 11.0]
hard-correct [13.0]
这个模型的重点不是阈值一定取 0.25 和 2,而是明确“谁拥有状态解释权”。阈值、回归帧数和插值曲线应根据移动速度、网络延迟和游戏玩法实测调整,不能让显示层的平滑策略反过来修改权威逻辑状态。
接管后不要继续沿用旧预测
收到服务器快照后,应同时更新位置基准、速度基准以及预测起点。尤其不能只修正屏幕上的坐标,却继续使用旧速度和旧时间戳外推;下一帧可能立刻再次产生一个方向错误的预测位置,形成连续抖动。
在实现上,可以把流程固定成“收到快照 → 更新权威状态 → 计算预测误差 → 选择修正模式 → 清空旧预测窗口 → 从新状态重新外推”。这样每次权威更新都会形成清晰的接管边界,后续的误差修正也更容易独立调试。