
游戏客户端架构 / 系统课时
怎样发现事件正在越积越多
怎样发现事件正在越积越多
事件系统没有抛出异常,也可能因为消息生产速度持续超过处理速度,让队列越积越长,最终造成输入延迟或游戏卡顿。本课通过四类运行指标和一段可执行的 C# 代码,识别持续堆积、容量丢弃和重复事件,并建立可验证的告警条件。
学习目标
- 理解队列长度、处理耗时、丢弃次数和重复次数的统计口径。
- 使用有界事件队列模拟消息积压并输出逐帧指标。
- 根据连续帧趋势判断异常,选择限流、合并或优化处理器。
从四个指标识别消息堆积
事件队列是生产者和消费者之间的缓冲区。生产者可以是网络回调、战斗逻辑或异步加载任务,消费者通常在游戏主线程按帧处理消息。短时间队列增长并不一定异常,关键是它能否在后续帧恢复。
| 指标 | 采集位置 | 需要关注的现象 |
|---|---|---|
| 队列长度 depth | 每帧处理结束后 | 连续增长或长期接近容量上限 |
| 处理耗时 costMs | 事件处理器执行前后 | 持续侵占主线程帧预算 |
| 丢弃总数 dropTotal | 队列拒绝消息时 | 相邻采样之间不断增加 |
| 重复总数 dupTotal | 根据事件唯一 ID 判重时 | 异常重投或生产者重复提交 |
队列深度属于瞬时值,丢弃和重复次数属于累计值。观察后两者时应计算相邻采样的增量,而不是只看启动以来的总数。
处理耗时也要区分两个概念:处理器执行耗时反映消费成本,事件从入队到开始处理的等待时间反映消息延迟。正式监控最好同时记录两者,并统计处理耗时的 P95,而不仅是平均值。
运行一个可复现的拥塞场景
下面使用 .NET 8 控制台程序模拟容量为 5 的有界队列。每帧最多处理一条事件,通过固定的消息输入制造重复、堆积和丢弃。使用 dotnet new console -n QueueProbe -f net8.0 创建项目,将以下代码完整替换到 Program.cs,进入项目目录执行 dotnet run。
using System;
using System.Collections.Generic;
using System.Diagnostics;
using System.Threading;

var queue = new Queue<int>();
var seenIds = new HashSet<int>();
const int capacity = 5;
int dropped = 0;
int duplicates = 0;
int highFrames = 0;

void Offer(int id)
{
    // 以事件 ID 判重,避免同一消息重复进入队列。
    if (seenIds.Contains(id))
    {
        duplicates++;
        return;
    }
    if (queue.Count >= capacity)
    {
        dropped++;
        return;
    }
    seenIds.Add(id);
    queue.Enqueue(id);
}

void Tick(int frame, params int[] incoming)
{
    foreach (int id in incoming) Offer(id);

    int handled = 0;
    double costMs = 0;
    if (queue.Count > 0)
    {
        // 每帧只消费一条,模拟固定处理预算。
        queue.Dequeue();
        var timer = Stopwatch.StartNew();
        Thread.Sleep(2); // 仅模拟慢回调,正式游戏不要这样阻塞主线程。
        timer.Stop();
        costMs = timer.Elapsed.TotalMilliseconds;
        handled = 1;
    }

    highFrames = queue.Count >= 4 ? highFrames + 1 : 0;
    Console.WriteLine(
        $"frame={frame} depth={queue.Count} handled={handled} " +
        $"costMs={costMs:F2} dropTotal={dropped} dupTotal={duplicates}");

    // 连续两帧处于高水位才触发示例告警。
    if (highFrames >= 2)
        Console.WriteLine("ALERT sustained backlog");
}

Tick(1, 1, 2, 3, 3);
Tick(2, 4, 5, 6);
Tick(3, 7, 8, 9);
Tick(4);预期输出(costMs 是实测毫秒数,下面使用 <TIME> 表示可能变化的数值):
frame=1 depth=2 handled=1 costMs=<TIME> dropTotal=0 dupTotal=1
frame=2 depth=4 handled=1 costMs=<TIME> dropTotal=0 dupTotal=1
frame=3 depth=4 handled=1 costMs=<TIME> dropTotal=2 dupTotal=1
ALERT sustained backlog
frame=4 depth=3 handled=1 costMs=<TIME> dropTotal=2 dupTotal=1
第一帧提交四次消息,其中 ID 为 3 的事件重复出现,因此只接受三条,处理一条后还剩两条。第二帧新增三条,处理后仍有四条。第三帧队列接近容量上限,只有 ID 为 7 的事件成功入队,另外两条被拒绝。
根据连续帧判断是否需要告警
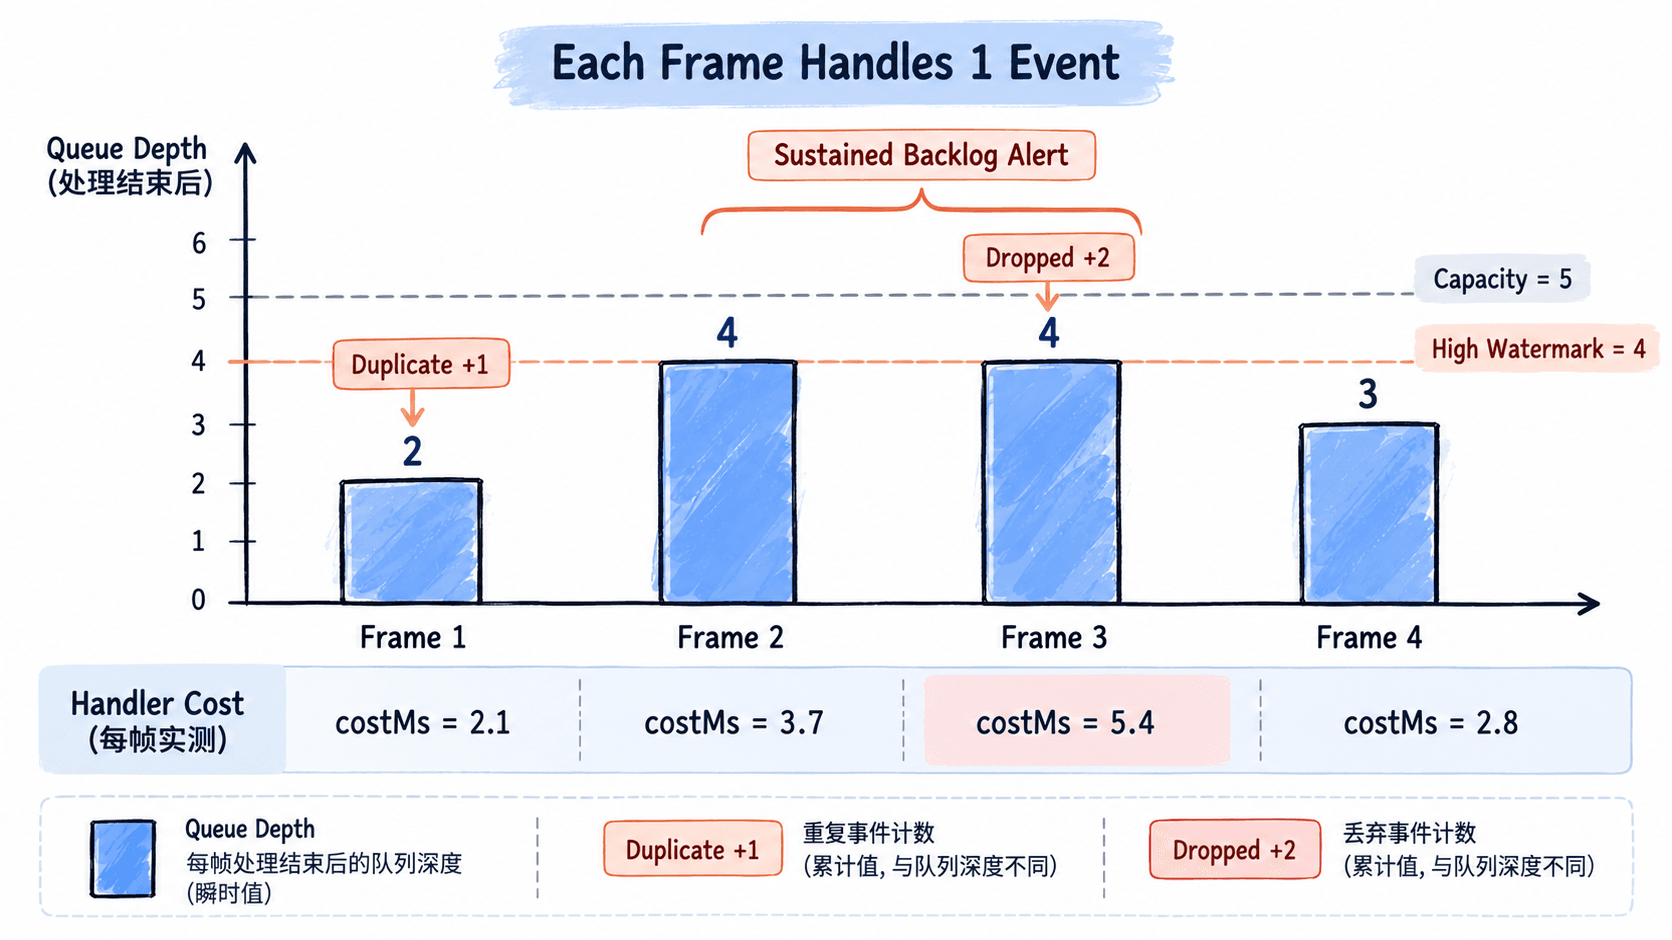
示例采用连续两帧队列长度达到 4 作为告警条件。这只是便于演示的阈值,实际项目应结合队列容量、消息优先级和每帧处理预算设置,不应直接照搬。
排查时按以下顺序判断:
- 先看队列深度是否连续上升,以及高水位持续了多少帧。
- 再看每帧成功入队量与处理量,确认生产速度是否长期超过消费速度。
- 检查处理器耗时是否突然增大,定位昂贵的回调。
- 最后查看丢弃和重复计数的增量,判断是否存在过量生产、重试风暴或容量不足。
队列长但没有丢弃,说明缓冲区仍有余量,并不代表消息延迟可以忽略。队列不长但丢弃量很大,也可能是容量限制掩盖了真实生产压力。
把监控接入真实游戏循环
实际接入时,在生产者提交消息的位置记录入队成功、重复和拒绝次数,在消费者处理前后记录耗时,并在每帧消费结束后采样队列深度。不要让统计和日志输出本身变成高频分配或阻塞来源,可以按固定间隔聚合上报。
示例中的 HashSet 为了演示保留了全部已接受的事件 ID。长期运行时必须改成有过期时间或容量上限的去重缓存,否则监控堆积的代码反而会造成内存增长。只有具有稳定唯一 ID 的事件才适合采用这种判重方式。
处理积压时要根据事件语义选择策略:位置同步可以保留最新值,界面刷新可以按帧去重,关键交易或战斗结算事件则不能随意丢弃。缩短处理器耗时、限制生产速率和增加合理的队列容量,应分别针对实际瓶颈使用。
可靠的积压告警不是某个计数超过阈值,而是队列深度、处理能力、等待时间与丢弃趋势共同证明消息无法及时消化。