
游戏客户端架构 / 系统课时
一个订阅者报错会不会拖死全局
一个订阅者报错会不会拖死全局
游戏事件通常会同时通知界面、音效、任务和日志等模块。如果其中一个订阅者抛出异常,未经保护的事件分发可能立即中断,导致后续模块收不到通知。本课将异常隔离放在每个订阅者的调用边界,通过可运行的 C# 示例验证单个处理器失败后,其他订阅者仍能继续执行。
学习目标
- 解释同步事件分发中,异常如何沿调用栈传播并中断后续处理器。
- 实现逐订阅者异常捕获、错误日志和分发结果统计。
- 区分可以隔离的处理器故障与需要业务回滚、重试或主动中止的关键错误。
为什么一次异常可能中断整个事件分发
假设角色受到伤害时,客户端发布 PlayerDamaged 事件。该事件有三个订阅者:
HealthHUD更新血量显示。Audio播放受击音效。CombatLog记录战斗事件。
如果事件总线按注册顺序同步调用订阅者,而 Audio 因音效资源缺失抛出 InvalidOperationException,那么异常会从 Audio 回调返回事件总线,并沿调用栈继续向外传播。
在没有隔离保护的情况下,当前分发循环会被打断,排在后面的 CombatLog 无法执行。如果发布事件的位置也没有处理异常,错误还可能继续传递到游戏更新逻辑,影响本帧剩余操作。
问题不在于事件系统天然不可靠,而在于普通的同步回调调用遵循语言本身的异常传播规则。事件总线是否隔离异常,取决于分发循环把异常处理边界放在哪里。
如果只在整个循环外层设置一次异常捕获,虽然能够阻止异常继续向更外层传播,但捕获时循环已经退出,并不会自动恢复执行后面的订阅者。
把异常隔离放在单个处理器周围
更合适的策略是让每次订阅者调用拥有独立的异常处理边界。
对每个订阅者依次执行以下动作:
- 从当前事件的订阅列表中取出一个处理器。
- 在独立的
try块中调用处理器。 - 成功时记录成功结果。
- 失败时在对应
catch块中记录事件编号、订阅者名称和异常信息。 - 无论当前处理器是否失败,都继续尝试执行后续订阅者。
- 全部处理结束后,向发布者返回成功数和失败数。
这里的隔离重点是捕获后继续分发,同时保留失败信息,而不是简单忽略所有异常。
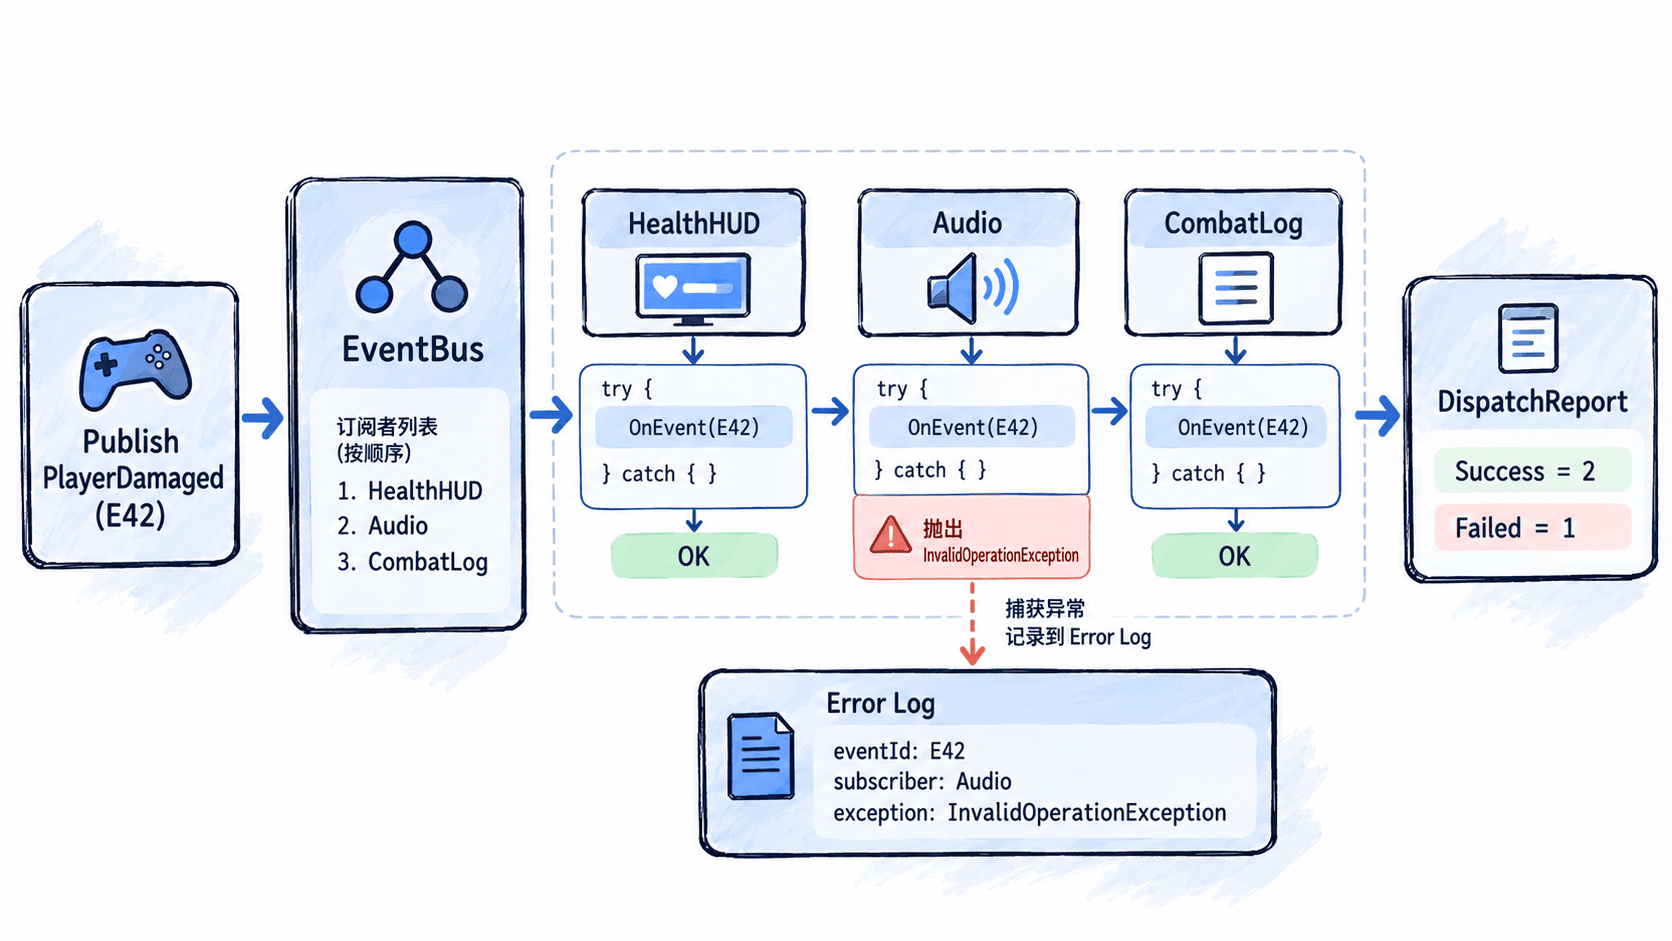
对于已经注册的订阅列表,可以先创建快照,再开始分发。这样即使某个回调在执行期间新增订阅者,也不会让本次遍历集合发生变化。新增的订阅关系从后续发布开始参与分发。
用 C# 实现隔离分发与结果报告
下面实现一个简化的同步事件总线,使用事件名称组织订阅者,并为每个订阅者独立捕获异常。
示例中的 Audio 故意抛出异常,用于验证排在它后面的 CombatLog 是否仍然执行。代码可以完整放入 .NET 8 控制台项目的 Program.cs。
using System;
using System.Collections.Generic;

var bus = new SafeEventBus();

bus.Subscribe("PlayerDamaged", "HealthHUD", e =>
{
    Console.WriteLine($"HealthHUD delta=-{e.Damage}");
});

// 模拟音效资源缺失导致的处理器异常
bus.Subscribe("PlayerDamaged", "Audio", e =>
{
    throw new InvalidOperationException("clip missing");
});

bus.Subscribe("PlayerDamaged", "CombatLog", e =>
{
    Console.WriteLine($"CombatLog event={e.Id}");
});

var report = bus.Publish(
    new GameEvent("E42", "PlayerDamaged", "Combat", 12));

Console.WriteLine(
    $"RESULT success={report.Success} failed={report.Failed}");

record GameEvent(
    string Id,
    string Name,
    string Publisher,
    int Damage);

record DispatchReport(int Success, int Failed);

sealed class SafeEventBus
{
    private readonly Dictionary<string,
        List<(string Subscriber, Action<GameEvent> Handler)>>
        _handlers = new();

    public void Subscribe(
        string eventName,
        string subscriber,
        Action<GameEvent> handler)
    {
        if (!_handlers.TryGetValue(eventName, out var list))
        {
            list = new();
            _handlers[eventName] = list;
        }

        list.Add((subscriber, handler));
    }

    public DispatchReport Publish(GameEvent e)
    {
        if (!_handlers.TryGetValue(e.Name, out var list))
            return new DispatchReport(0, 0);

        int success = 0;
        int failed = 0;

        // 固定本次执行集合,避免新增订阅改变当前遍历
        foreach (var (name, handler) in list.ToArray())
        {
            try
            {
                handler(e);
                success++;
                Console.WriteLine(
                    $"OK event={e.Id} subscriber={name}");
            }
            catch (Exception ex)
            {
                failed++;

                // 记录失败的事件和处理器,不中断其他订阅者
                Console.WriteLine(
                    $"ERROR event={e.Id} subscriber={name} " +
                    $"{ex.GetType().Name}: {ex.Message}");
            }
        }

        return new DispatchReport(success, failed);
    }
}
在项目目录运行 dotnet run。
预期输出:
HealthHUD delta=-12
OK event=E42 subscriber=HealthHUD
ERROR event=E42 subscriber=Audio InvalidOperationException: clip missing
CombatLog event=E42
OK event=E42 subscriber=CombatLog
RESULT success=2 failed=1
可以从输出中检查三个关键事实。
首先,HealthHUD 正常执行,说明事件发布和订阅关系有效。其次,Audio 抛出异常后,事件总线记录了 E42 和失败订阅者的名称。最后,CombatLog 仍然执行,并且分发报告正确统计两个成功处理器和一个失败处理器。
如果把 try/catch 移到整个循环外面,Audio 抛错后循环就会退出,CombatLog 不再执行。这正是两种异常处理边界的核心区别。
隔离异常不等于自动恢复业务状态
单个处理器异常被捕获,并不代表这个处理器已经完成自己的工作,也不意味着它之前执行的操作会自动回滚。
例如,某个订阅者先扣除了金币,随后在写入背包数据时抛出异常。事件总线虽然可以继续通知其他模块,但金币扣减可能已经发生,背包更新却没有完成。
因此需要根据业务性质选择策略。
| 事件类型 | 推荐处理策略 |
|---|---|
| 音效、特效等非关键通知 | 记录异常,继续其他订阅者 |
| UI 刷新、战斗日志 | 隔离异常,保留失败信息,并允许后续修复或重新刷新 |
| 金币扣减、物品发放等关键状态操作 | 使用有明确成功或失败语义的业务流程,必要时通过事务或补偿保证一致性 |
| 必须全部成功的协同操作 | 不应仅依赖尽力而为的广播,需明确失败传播和整体处理规则 |
对于返回 Task 的异步订阅者,应使用异步分发接口,并逐个正确等待和捕获任务异常。对于队列消费者,应在消费端设置隔离边界。不能认为同步 try/catch 会自动覆盖所有异步工作。
如何验证异常隔离策略足够可靠
除了运行一次人为抛错的示例,还应验证异常发生在不同订阅位置时的行为。
- 首个处理器失败:后面的订阅者仍能执行。
- 中间处理器失败:前面成功的操作保留,后面继续执行。
- 最后一个处理器失败:发布者仍能获得完整的失败报告。
- 多个处理器失败:每个失败都独立记录,不因为首次失败而停止统计。
- 没有订阅者:发布应安全返回,成功数和失败数均为 0。
生产环境中,异常日志还应包含事件名称、事件编号、发布者、订阅者和必要的异常堆栈信息。可以通过失败次数、失败率和异常类型进行聚合告警,但要限制高频重复日志,防止错误日志反过来拖慢游戏主线程。
另外,示例直接使用 Console.WriteLine 展示日志,不代表生产日志系统永远可靠。实际实现需要防止日志组件自身抛错、递归发布错误事件或执行昂贵的同步 I/O。分发报告应优先采用结构化数据,必要时由上层统一处理。
最终应把事件总线的责任限定清楚:它负责按既定规则通知订阅者、隔离允许隔离的异常并提供可诊断结果;关键业务的一致性、失败重试和补偿则由相应业务模块负责。这样既能避免一个非关键处理器拖垮整条通知链,也不会把真正重要的业务失败悄悄隐藏起来。