
游戏客户端架构 / 系统课时
任务积压时该跳过还是补跑
任务积压时该跳过还是补跑
程序暂停、长卡顿或持续低帧率后,多个周期任务可能同时过期。恢复时若全部补跑,会制造尖峰;若全部跳过,又可能丢失必须执行的逻辑。本节把积压处理拆成可判断的策略,并给出一个可运行的调度示例。
学习目标
- 识别周期任务恢复时产生积压的原因
- 根据业务语义选择跳过、补跑或限量补跑
- 为补跑次数设置上限,避免恢复瞬间形成新的卡顿
积压本质是多个目标时间已过期
假设任务每 1 秒执行一次,下一目标最初是 1 秒。程序直到 5.4 秒才重新获得执行机会,那么 1、2、3、4、5 秒这五个目标都已经过期。调度器面对的不是“晚了一次”,而是“五次计划执行现在都需要决策”。
如果直接循环到追平当前时间,恢复帧可能连续执行五次甚至更多;如果只执行一次却仍把下一目标设为 2 秒,下一帧又会继续追赶,等于把尖峰拆成多帧持续卡顿。策略必须同时决定“本次执行几次”和“下一目标推进到哪里”。
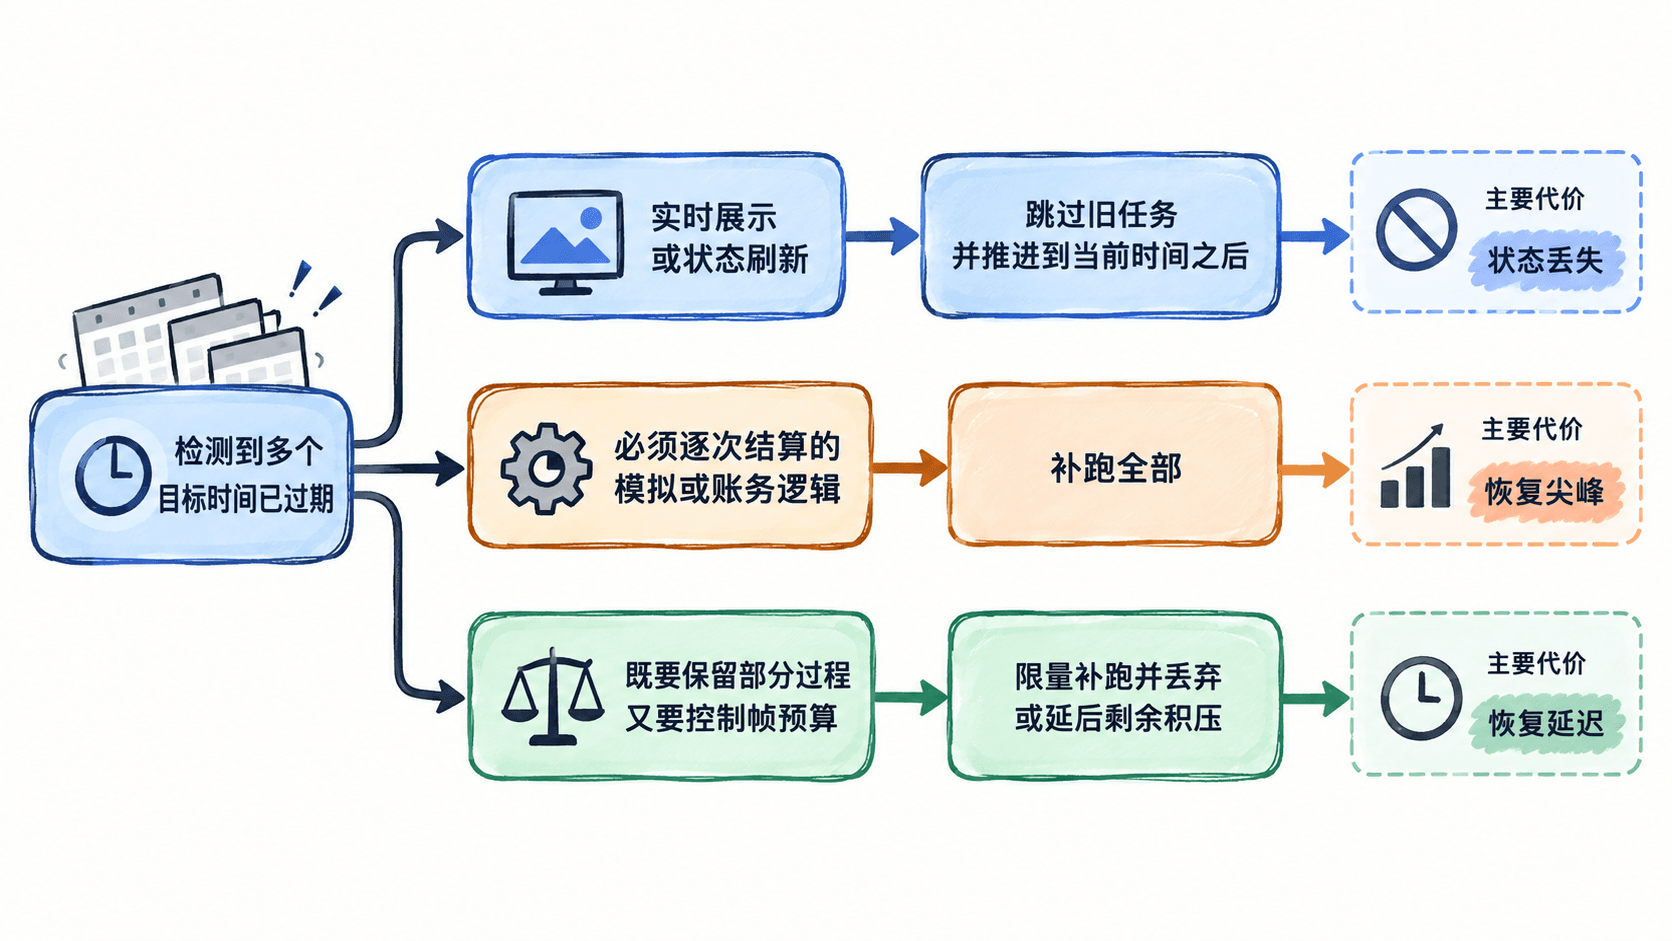
三种策略对应三种业务语义
跳过旧任务适合只关心最新状态的工作,例如刷新 UI、广播当前位置、重算缓存快照。恢复后执行一次当前任务,然后把下一目标推进到当前时间之后,避免继续追赶历史节拍。
补跑全部适合每次周期都代表不可省略的离散事件,例如严格的离线结算步骤或确定性模拟步。它保留完整过程,但积压越多,恢复成本越高,因此还需要防止积压无界增长。
限量补跑是实时程序常用折中:每帧最多执行固定次数,多余积压按业务规则丢弃、合并或延后。它不能同时保证“绝不丢事件”和“立即恢复实时性”,但能把最坏单帧工作量控制在已知范围内。
用代码验证恢复行为
下面的示例假设周期为 1 秒,调度器在 5.4 秒恢复。due_count 表示已经到期的目标次数;三种策略分别返回本次执行次数以及下一目标时间。
import math

period = 1.0
next_due = 1.0
now = 5.4

due_count = math.floor((now - next_due) / period) + 1

def skip_old(due: int) -> tuple[int, float]:
    # 只执行一次,并直接跳到当前时间之后的第一个目标点。
    new_next_due = next_due + due * period
    return 1, new_next_due

def catch_up_all(due: int) -> tuple[int, float]:
    # 每个已过期目标都补跑。
    new_next_due = next_due + due * period
    return due, new_next_due

def catch_up_capped(due: int, cap: int) -> tuple[int, float, int]:
    # 限制本次补跑次数,其余积压明确丢弃。
    runs = min(due, cap)
    dropped = due - runs
    new_next_due = next_due + due * period
    return runs, new_next_due, dropped

print("到期次数:", due_count)
print("跳过旧任务:", skip_old(due_count))
print("补跑全部:", catch_up_all(due_count))
print("最多补跑 2 次:", catch_up_capped(due_count, 2))
预期输出
到期次数: 5
跳过旧任务: (1, 6.0)
补跑全部: (5, 6.0)
最多补跑 2 次: (2, 6.0, 3)
这里三种策略都把下一目标推进到 6 秒,因此恢复后不会继续围绕旧目标忙等。区别只在于 1~5 秒之间的历史工作如何处理。实际时间值可能不同,但“推进到未来目标点”的原则应保持一致。
先按任务语义做选择
选择策略时先回答两个问题:漏掉某次执行会不会破坏业务正确性,以及一次性补跑很多次会不会超过当前帧或线程的预算。只要第一项允许丢弃,就优先考虑跳过或合并;只有每次执行都承载不可省略状态变化时,才需要完整补跑。
对于游戏主线程,还应给补跑设置硬上限并记录积压指标。若积压经常触发,问题通常不再是调度策略本身,而是任务周期过短、单次工作过重,或暂停恢复路径没有专门处理。调度器负责把异常成本限制住,但不能替代对任务负载的治理。