
游戏客户端架构 / 系统课时
卡顿后为什么会连续跑多步
卡顿后为什么会连续跑多步
固定步长循环不会因为一帧卡了就自动跳过模拟时间。长帧把更多真实时间一次性塞进累加器,循环便会连续执行多次固定更新来追赶进度;如果这些补跑本身又很昂贵,就可能把一次卡顿放大成持续积压。
学习目标
- 解释长帧后连续执行多个固定更新的原因。
- 识别 catch-up 更新如何演变为性能恶性循环。
- 使用单帧更新上限控制最坏成本,并理解这种保护的代价。
长帧如何触发 catch-up
固定步长循环通常维护一个时间累加器。每帧先把真实经过时间加入累加器,只要累积时间仍大于固定步长,就继续执行一次模拟并扣掉一个步长,最后再进行渲染。
假设固定步长为 20 ms。正常帧只过去约 16 ms,累加器可能暂时不足以执行更新;如果某一帧因为资源加载、GC 或系统调度耗时 120 ms,累加器会突然增加 120 ms,于是当前帧需要连续执行大约 6 次固定更新才能追上模拟时间。
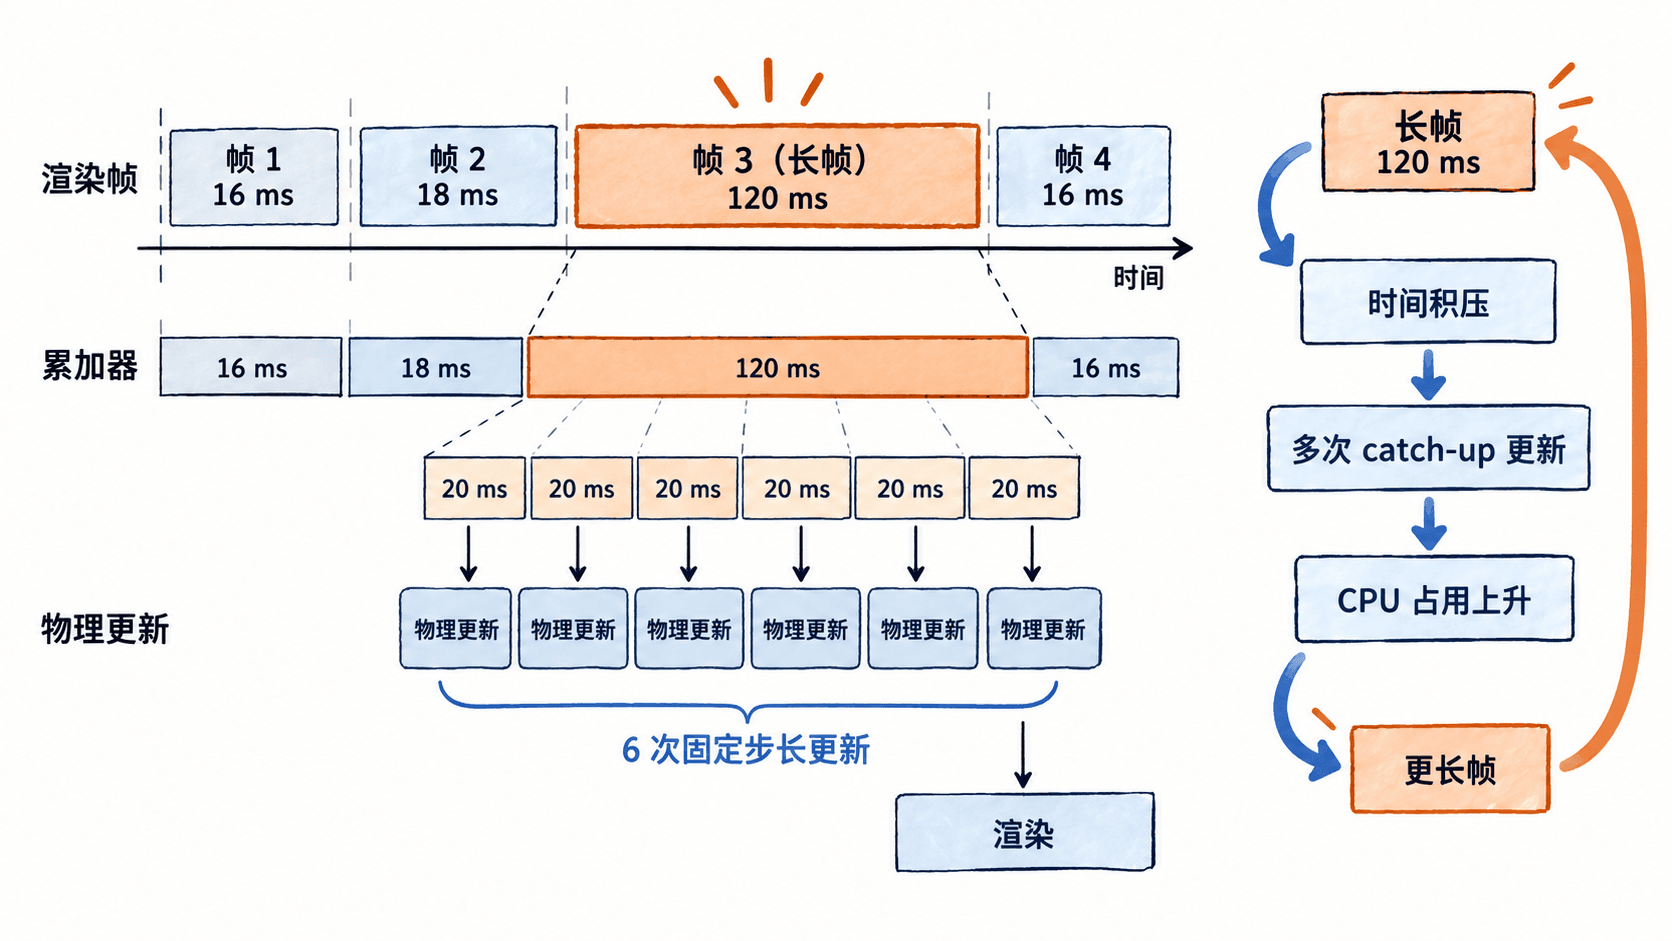
下面的可运行示例用一组预设帧耗时模拟这种行为,并比较不限次数与每帧最多 4 次更新的结果。
FIXED_DT = 0.020
FRAME_TIMES = [0.016, 0.018, 0.120, 0.016]

def simulate(max_steps: int) -> None:
    accumulator = 0.0
    print(f"max_steps={max_steps}")

    for frame_index, frame_dt in enumerate(FRAME_TIMES, start=1):
        accumulator += frame_dt
        updates = 0

        # 先执行允许的 catch-up 更新。
        while accumulator >= FIXED_DT and updates < max_steps:
            accumulator -= FIXED_DT
            updates += 1

        # 超出单帧预算的完整步长被丢弃,仅保留不足一步的余量。
        dropped = 0
        while accumulator >= FIXED_DT:
            accumulator -= FIXED_DT
            dropped += 1

        print(
            f"frame {frame_index}: updates={updates}, "
            f"dropped={dropped}, remainder={accumulator:.3f}s"
        )

simulate(999)
simulate(4)
预期输出
max_steps=999
frame 1: updates=0, dropped=0, remainder=0.016s
frame 2: updates=1, dropped=0, remainder=0.014s
frame 3: updates=6, dropped=0, remainder=0.014s
frame 4: updates=1, dropped=0, remainder=0.010s
max_steps=4
frame 1: updates=0, dropped=0, remainder=0.016s
frame 2: updates=1, dropped=0, remainder=0.014s
frame 3: updates=4, dropped=2, remainder=0.014s
frame 4: updates=1, dropped=0, remainder=0.010s
第三帧最关键:120 ms 的长帧让不限次数的版本连续执行 6 次更新,而有上限的版本只执行 4 次,并明确丢弃了 2 个完整步长。
多步更新为什么可能越追越慢
catch-up 的目标是让模拟时间追上真实时间,但它默认一个重要前提:补跑几次更新的总成本仍然小于当前机器剩余的时间预算。如果一次固定更新本来就很重,长帧之后连续执行 6 次更新会进一步拉长当前帧。
最危险的情况是积压增长速度超过处理速度。上一帧没追完的时间进入下一帧,下一帧又因为多次更新变慢,于是产生“长帧 → 更多更新 → 更长帧 → 更多积压”的 spiral of death。此时问题已经不只是偶发掉帧,而是循环持续自我放大。
给追赶设置硬上限
工程上通常要限制单个渲染帧最多执行多少次固定更新,例如 4 次或 5 次。这样即使真实帧耗时突然变大,也能给渲染、输入和其他系统保留处理机会,避免当前帧被物理更新完全占满。
但“达到上限后怎么办”必须明确。可以丢弃超出的模拟时间,让游戏时间短暂落后或跳过;也可以限制可累积的最大帧时间,让极端长帧只贡献一部分时间。需要确定性回放、锁步同步或精确服务器模拟时,直接丢步可能破坏结果,此时更适合让模拟与显示解耦,或在服务器侧保证足够算力。
验证 catch-up 是否安全
调试时不要只看平均帧率,而要记录每帧固定更新次数、累加器剩余时间和单次更新耗时。正常运行时多数帧应只执行 0~1 次固定更新;偶尔出现 2~3 次可以接受,但如果高次数持续出现,就说明模拟成本、固定步长或最坏场景预算之间已经失衡。
最有效的验证方式是主动制造长帧,再观察系统能否在少量帧内恢复。只要 catch-up 有明确上限、恢复路径可预测,并且不会持续扩大积压,一次卡顿就不会轻易演变成连续卡顿。