
技术英语 / 系统课时
建立高效查词与验证流程
建立高效查词与验证流程
技术英语里的陌生词不能只靠“中译英”判断。更稳妥的方法是先看它在句子里扮演什么角色,再用词典、官方文档、代码上下文和例句逐层验证,直到得到能解释当前语境的含义。
学习目标
- 区分通用词义与具体技术语境中的专门含义
- 建立“词典 → 文档 → 代码上下文 → 例句验证”的查证顺序
- 用搭配、对象和上下文判断一个解释是否真的适用于当前句子
先确定词在句子里做什么
遇到陌生词时,第一步不是复制整句去翻译,而是先看词性、主语、宾语和附近的固定搭配。技术语义往往由“这个词作用在什么对象上”决定。
以 resolve 为例,resolve a hostname 常指“把主机名解析为地址”,resolve dependencies 是“解析并确定依赖关系”,而 Promise resolves 则表示 Promise 进入 fulfilled 方向的完成状态。三个场景都能翻成“解决”或“解析”,但真正可用的解释取决于对象。
如果一个中文释义无法解释句子的输入、输出或状态变化,就先把它视为候选,而不是答案。
用四层证据完成查证
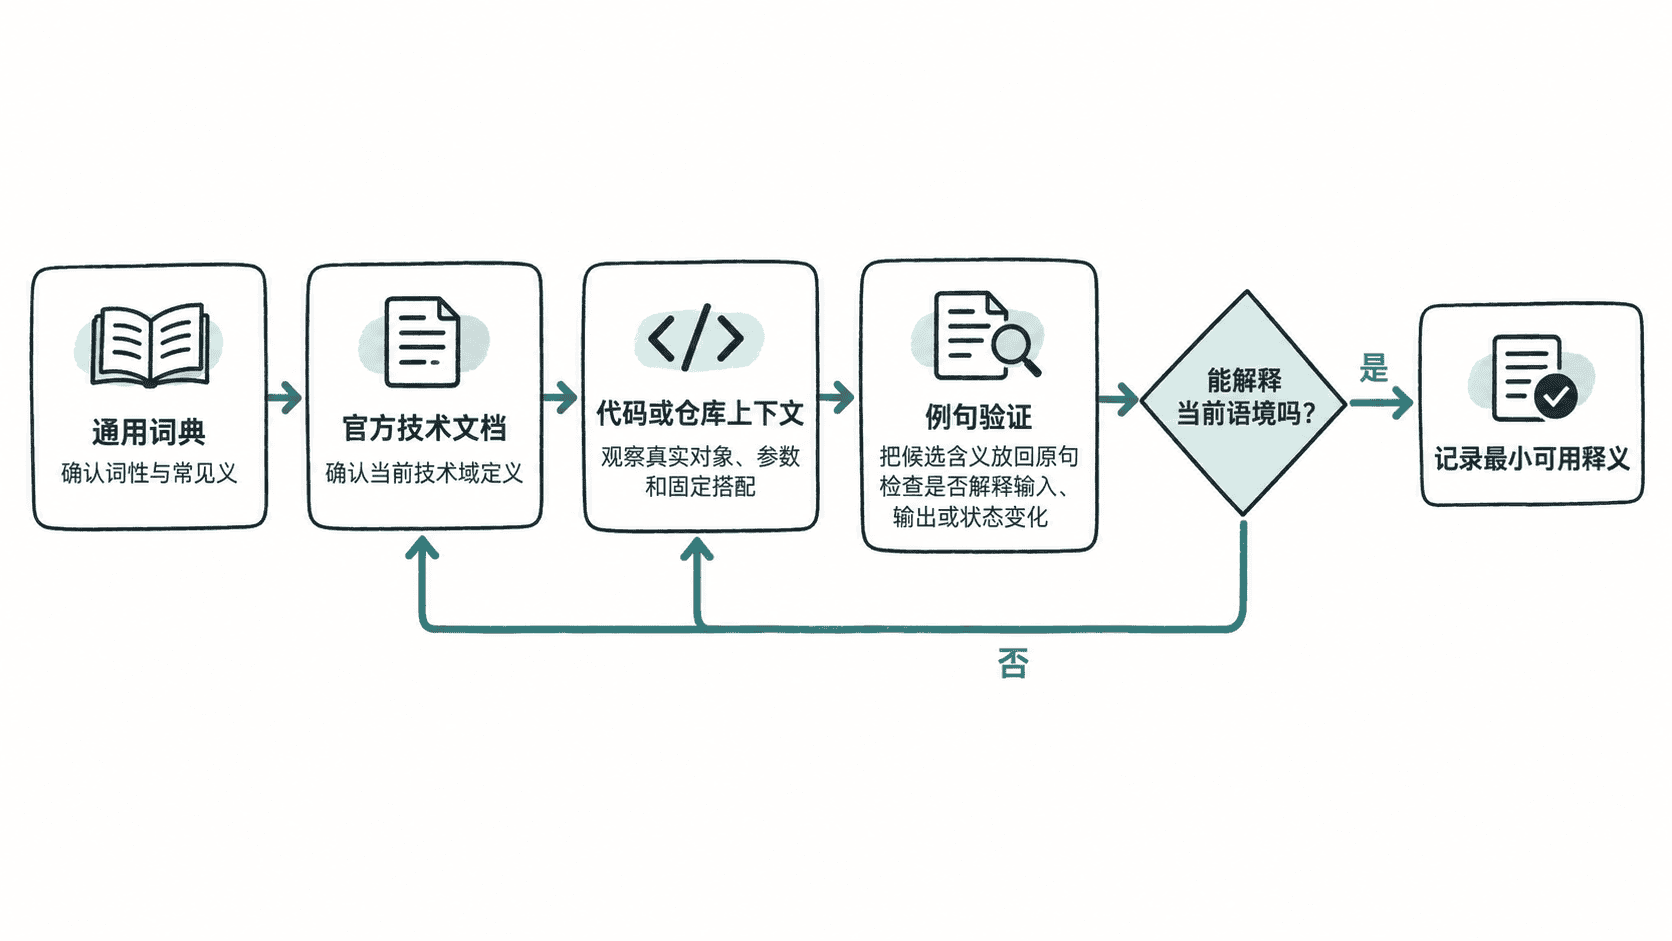
四层证据的职责不同:通用词典帮你确定基本词性和常见义;官方文档负责给出当前技术域中的正式定义;代码搜索告诉你这个词实际上和哪些对象、参数或动作一起出现;例句验证则检查你的解释能否回到原句中成立。
顺序也很重要。先用词典建立候选义,再用更接近当前技术栈的资料缩小范围,比一开始就让机器翻译整段文本更容易发现歧义。
用代码上下文验证候选含义
下面用一个最小 Python 程序模拟“代码搜索后的上下文检查”。它不是为了记住 resolve 的中文翻译,而是观察同一个词附近出现的对象。
sentences = [
    "DNS resolver resolves api.example.com to an IP address.",
    "The package manager resolves transitive dependencies before installation.",
    "The Promise resolves with the parsed response.",
]

keyword = "resolve"

for index, sentence in enumerate(sentences, 1):
    if keyword in sentence.lower():
        print(f"{index}: {sentence}")
预期输出
1: DNS resolver resolves api.example.com to an IP address.
2: The package manager resolves transitive dependencies before installation.
3: The Promise resolves with the parsed response.
观察输出时,不要只盯着关键词本身。第一句的对象是域名和 IP,第二句是依赖关系,第三句是 Promise 状态;真正帮助你判断词义的是这些邻近信息。实际在仓库中搜索时,也应优先阅读关键词前后几行,而不是只看命中的那一个词。
判断什么时候可以停止查词
查词不是资料越多越好。满足三个条件时通常就可以停止:你能用一句简单中文解释它在当前句子的作用;这个解释与官方文档或真实代码用法一致;把解释放回原句后,条件、对象和结果都没有冲突。
如果不同来源给出不同中文译法,也不必强行选唯一答案。技术阅读的目标是理解行为。例如你知道 deprecated 表示“仍可能存在,但不建议继续使用并可能在未来移除”,就比只记“弃用”两个字更有用。
避免把机器翻译当成最终证据
机器翻译适合快速获得整句大意,但不适合作为技术词义的最后裁决。它可能把一个领域术语翻成日常含义,也可能为了让中文通顺而隐去条件、时态或状态变化。
更稳妥的习惯是:机器翻译只能生成候选解释,官方文档和真实用例负责验证。长期记录时也不要只保存“英文 = 中文”,而应保存“英文词 + 常见对象或搭配 + 一条真实技术句”。这样下次再遇到同一个词,你记住的是使用条件,而不是一个脱离上下文的翻译。