
AI 内容创作 / 系统课时
刻画目标读者
刻画目标读者
同一主题面对不同读者,需要完全不同的术语、证据、篇幅和行动指令。本课将把“面向所有人”这类空泛描述,拆成知识水平、现实需求、主要顾虑、阅读场景和期望收获五个可执行维度。
学习目标
- 用五个维度建立与当前任务相关的目标读者画像。
- 将读者画像转化为语气、结构、解释深度和证据选择。
- 区分已知事实与未经验证的假设,避免凭空编造读者特征。
读者画像不是人口标签
有效的读者画像服务于写作决策,不追求描述一个完整的人。年龄、职业或地区只有在确实影响理解和行动时才有价值。相比“25 至 35 岁上班族”,写明“首次接触该工具、只有十分钟阅读时间、担心配置失败”更能指导内容生成。
| 画像维度 | 需要回答的问题 | 对正文的直接影响 |
|---|---|---|
| 知识水平 | 已经知道什么,哪些术语陌生? | 决定定义数量、术语解释和示例起点 |
| 现实需求 | 当前要解决什么具体问题? | 决定内容范围和信息优先级 |
| 主要顾虑 | 为什么可能不相信或不行动? | 决定证据、风险说明和反对意见处理 |
| 阅读场景 | 在什么时间、设备和压力下阅读? | 决定篇幅、段落长度和信息密度 |
| 期望收获 | 读完后希望得到什么结果? | 决定结尾、清单和行动指令 |
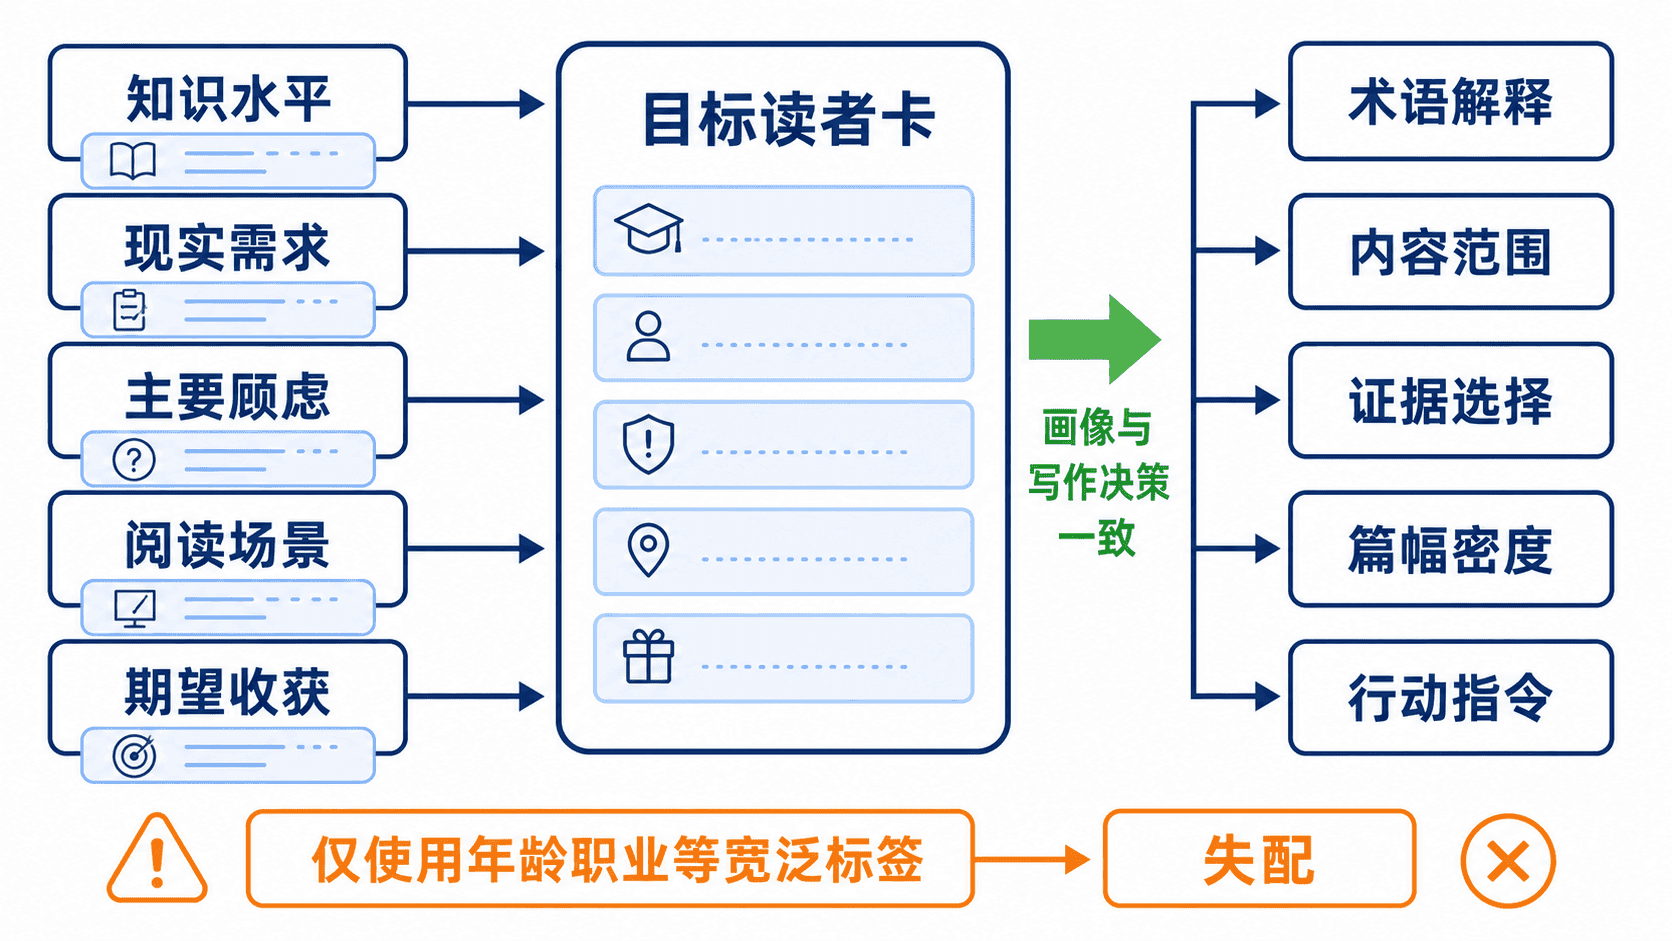
建立可写入提示词的读者卡
读者卡应短到能够直接放入提示词,同时具体到足以影响生成结果。建议按固定顺序记录:已有知识、当前任务、主要顾虑、阅读环境和预期结果。每项只保留与本次内容直接相关的信息。
目标读者:第一次负责团队周报的新任项目负责人。读者知道项目基本进度,但不熟悉管理层关注的风险和决策信息。其主要顾虑是周报过长、重点不清;通常在手机上快速阅读示例,希望最终获得一套可直接套用的周报结构。
这张读者卡比“面向职场新人,语气专业”更可执行。它明确了术语起点、阅读时长、信息重点和最终交付,因此能够直接约束段落长度、标题层级、示例内容和结尾形式。
把画像转化为写作决策
画像必须继续向下转换,不能停留在描述层。知识水平决定是否解释概念;现实需求决定先写什么;主要顾虑决定需要哪些证据;阅读场景决定文本密度;期望收获决定结尾给出说明、模板还是行动步骤。
以“解释数据备份”为例,面向普通用户时,应先说明丢失风险,再给出少术语的操作步骤和恢复验证;面向运维人员时,可以直接说明备份范围、恢复点目标、保留策略和演练结果。主题相同,但读者约束会改变信息顺序和验收标准。
提示词中可以直接写成:“面向首次接触该主题、在手机上快速阅读的用户;避免未解释的专业术语;先回答最紧迫的问题;用一个具体例子消除主要顾虑;结尾给出三步可执行清单。”
识别假设与证据缺口
没有调研数据时,不要把推测写成事实。可以将信息分为“已知”“待确认”和“暂定假设”。例如,已知读者通过移动端进入页面;待确认其是否使用过同类产品;暂定假设其最关心迁移成本。生成正文时,应避免围绕暂定假设投入过多篇幅。
当读者群内部差异很大,应选择主要读者,并为次要读者提供最小兼容方案。例如,正文按初学者组织,同时用简短提示补充专业术语,而不是在每一段同时维护两个解释层级。这样可以保持主线清晰,又不完全排除其他读者。
本课总结
- 有效读者画像应直接影响内容决策,而不是堆积人口标签。
- 五个核心维度是知识水平、现实需求、主要顾虑、阅读场景和期望收获。
- 未经验证的信息必须标记为假设;读者差异过大时应先确定主要读者。
下一课预告
下一阶段将把写作目的与目标读者合并为完整任务说明,并继续补充内容范围、表达边界和验收标准,使提示词能够稳定地产出符合发布要求的文本。