
AI 内容创作 / 系统课时
改写复杂内容
改写复杂内容
复杂内容改写不是单纯删字,而是在不改变事实、结论和边界的前提下,降低读者的理解成本。本课将建立一套从读者定位、信息分层、术语解释到保真检查的改写方法,使复杂材料变得清楚、可信且可继续使用。
学习目标
- 根据读者水平确定解释深度、术语密度和示例类型。
- 区分必须保留的信息与可以简化的表达形式。
- 使用类比、拆句和回查方法完成准确改写。
先确定读者与改写目标
同一段内容面对不同读者,需要保留的细节并不相同。给管理者改写时,应突出结论、影响和决策条件;给初学者改写时,应解释术语、补足因果关系并降低句子密度;给专业同行改写时,则不能为了易懂而删除关键参数和限定条件。
开始前先回答三个问题:读者已经知道什么、读完后要完成什么、哪些误解会造成实际后果。目标越明确,越容易判断哪些内容应保留,哪些内容可以换一种说法。
用信息分层保持准确
复杂材料可以分为三层。第一层是不能改变的事实层,包括数据、结论、条件、因果关系和风险;第二层是可以重组的解释层,包括句子顺序、术语说明和例子;第三层是可以删除的负担层,包括重复背景、装饰性表达和与当前目标无关的细节。
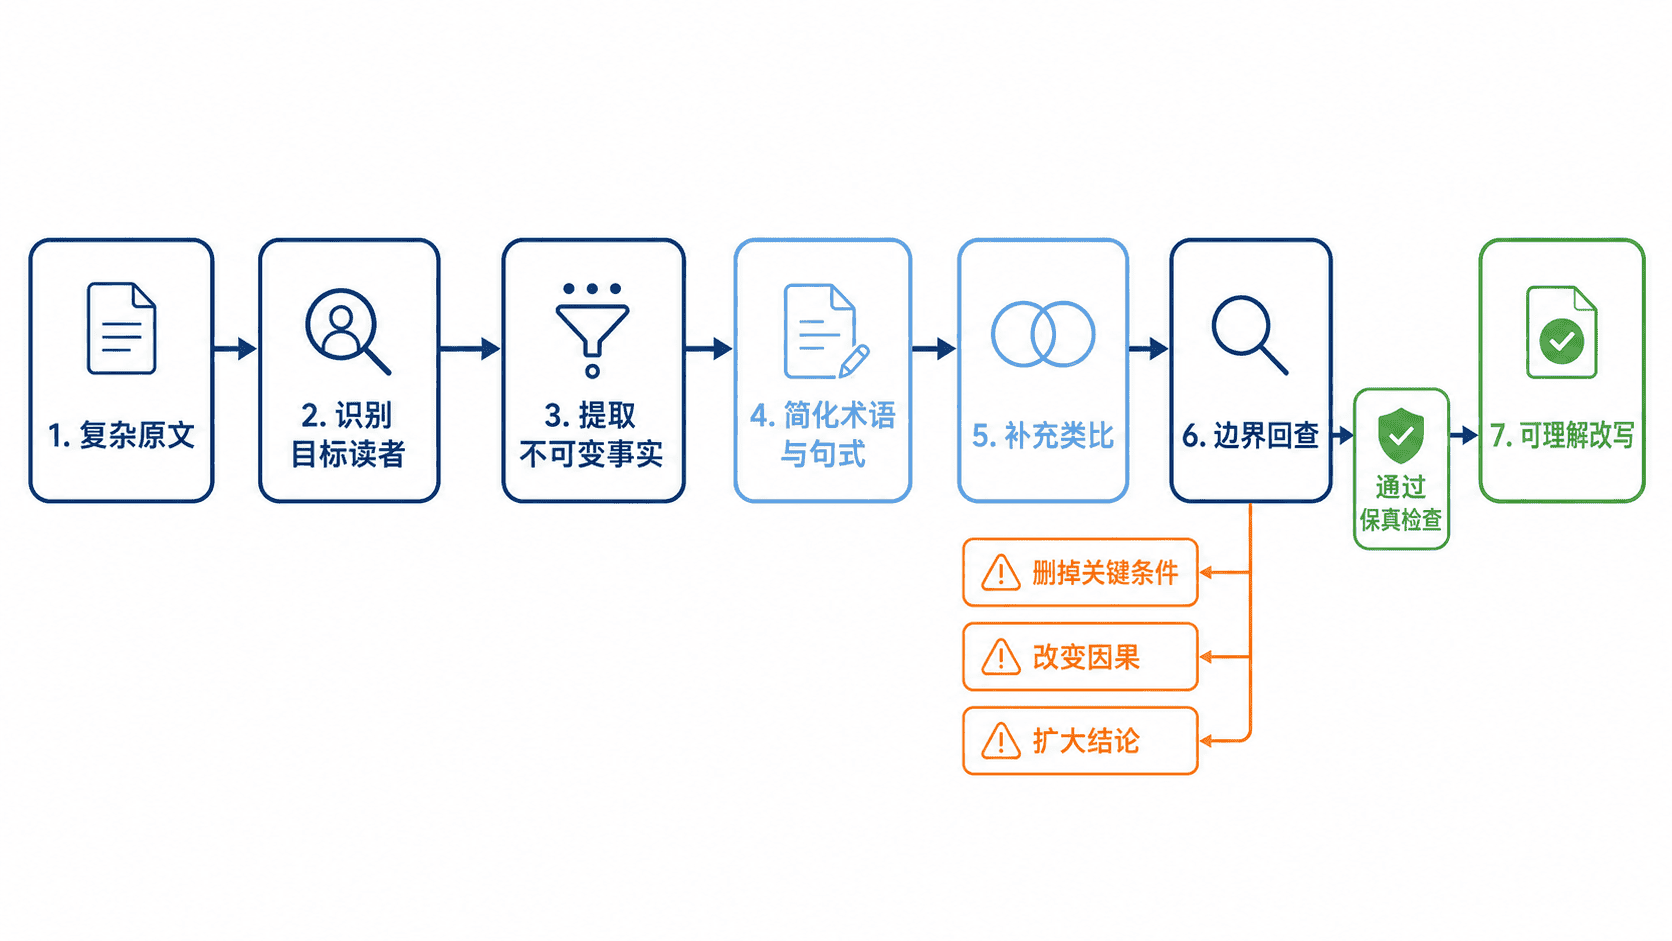
改写时应先锁定第一层,再处理第二层,最后清理第三层。这样可以避免从句子表面直接删减,导致原文仍然顺口,却已经改变了原意。
把术语改成可理解表达
解释术语时,可以采用“直白定义、机制类比、边界提醒、恢复术语”的顺序。类比只负责建立直觉,不能替代准确解释;当类比无法覆盖例外情况时,应明确指出它的适用范围。
原表达:
缓存通过保存高频访问结果,减少重复计算或远程读取,但缓存更新管理不当会返回过期数据。
面向非技术读者的改写:
缓存像把常用资料放在手边,之后可以直接取用,不必每次重新查找。它能加快处理速度,但如果资料没有及时更新,也可能让系统继续使用旧信息。技术上把这类临时保存机制称为“缓存”。
这段改写保留了作用、工作方式和风险,没有把“更快”误写成“永远正确”,也没有让类比覆盖真实边界。
用回查问题验证保真度
完成改写后,不要只检查是否通顺,还要逐句与原文对照。可使用以下问题进行回查:
| 检查项 | 回查问题 |
|---|---|
| 事实 | 数据、对象和时间范围是否一致? |
| 因果 | 原文只是相关关系,是否被改成因果关系? |
| 强度 | “可能”“通常”“在特定条件下”是否被错误强化? |
| 边界 | 适用条件、例外和风险是否仍然存在? |
| 读者 | 新增解释是否真正解决目标读者的困难? |
当无法确认某项事实时,应保留原文的谨慎程度,或明确标记待确认信息,而不是用更肯定的表达填补空白。
本课练习
- 将一段包含 5 个以上专业术语的说明改写给零基础读者。保留核心结论、适用条件和风险,首次出现的术语需要给出直白解释,并至少使用一个有边界说明的类比。验收时逐句对照原文,确认没有新增事实。
- 为同一段材料分别写面向管理者和面向执行人员的两个版本。前者控制在 120 字以内并突出决策影响,后者控制在 220 字以内并保留操作条件。两个版本的结论必须一致,但信息排序应体现读者差异。
本课总结
- 复杂内容改写的核心是降低理解成本,而不是削弱事实精度。
- 先锁定事实、结论、条件和风险,再调整术语、句式与示例。
- 类比必须服务于机制理解,并通过原文回查防止结论被扩大。
下一课预告
下一课将学习“提炼摘要与要点”,把长材料压缩为不同长度和用途的摘要,同时保持信息优先级与原文忠实度。