
AI 内容创作 / 系统课时
建立提示词测试习惯
建立提示词测试习惯
一条提示词偶尔产出好结果,并不代表它已经稳定。真正可复用的模板需要在正常输入、边界输入和含糊输入下反复验证。本课将建立小样本基线、单变量改写、评分记录和版本晋级流程,让优化结论可以被复现。
学习目标
- 为提示词选择具有代表性的最小测试样本。
- 使用单变量原则比较不同提示词版本。
- 根据评分记录判断版本是否稳定并决定是否替换基线。
先定义要验证的问题
测试前必须把“这条提示词好不好”改写成可以观察的问题,例如“是否始终输出规定字段”“遇到缺失事实时是否拒绝编造”“三种受众输入下语气是否一致”。每轮只验证一到两个问题,否则无法判断结果变化来自哪项修改。
优先选择失败后代价较高的指标。面向发布的写作任务通常先检查事实准确性和结构完整性,再检查语气与风格;若格式都不稳定,过早微调措辞不会带来可靠收益。
用最小样本建立基线
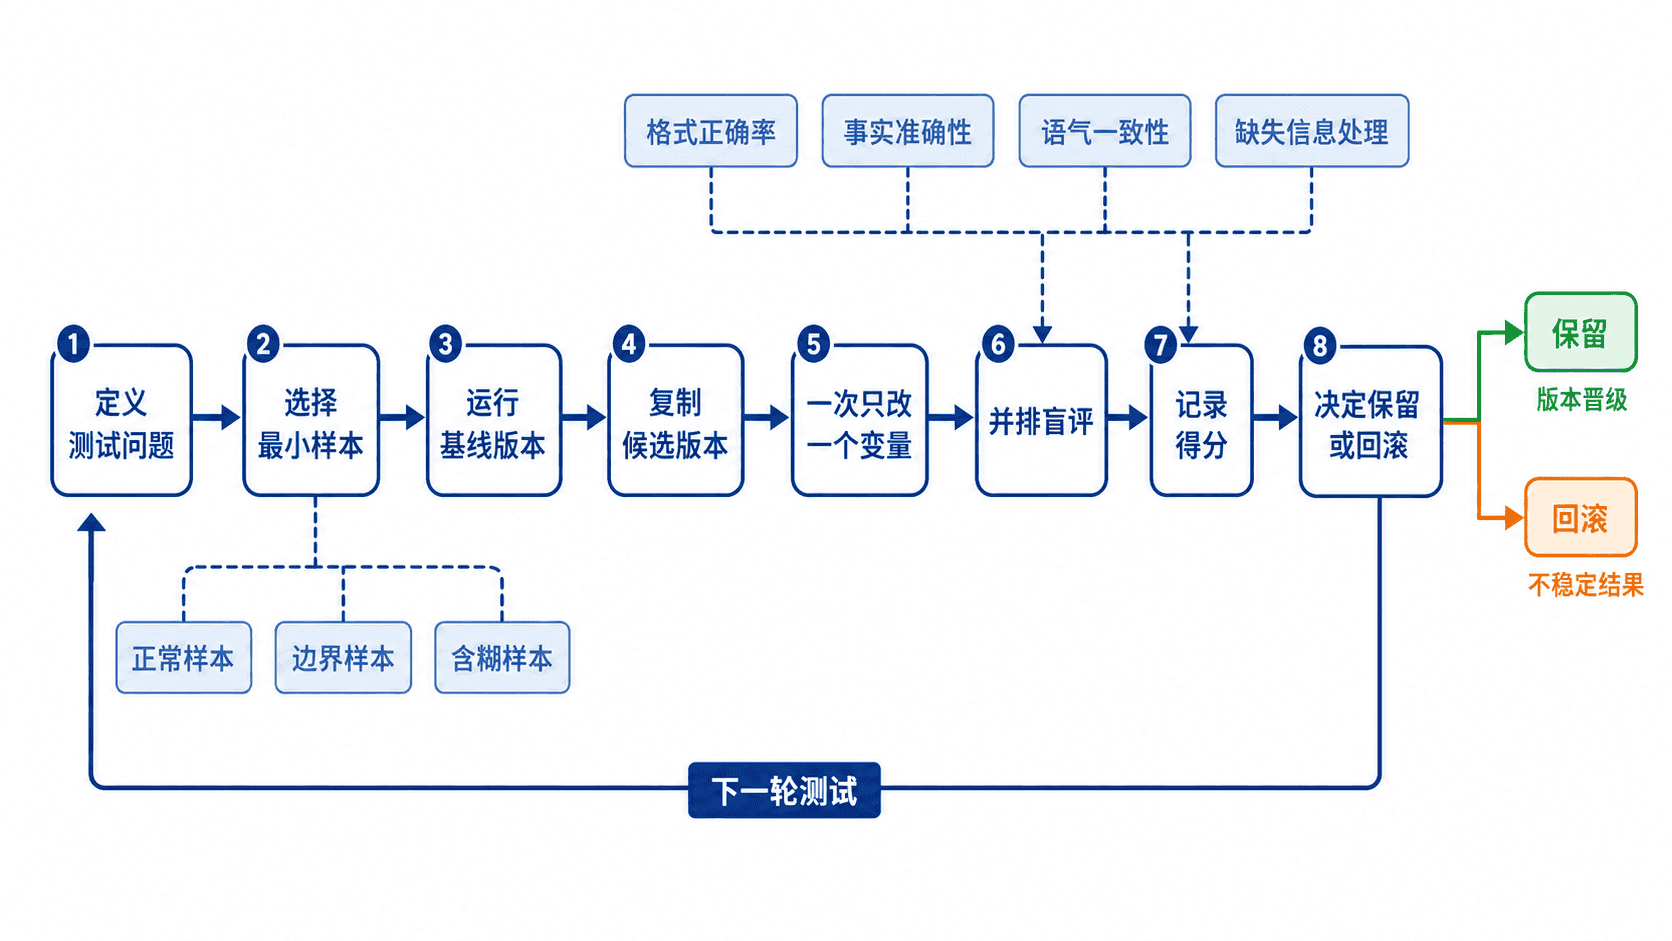
最小测试集不追求覆盖所有场景,而要覆盖最容易暴露问题的三类输入。正常样本代表日常任务,边界样本包含长度上限、字段缺失或冲突要求,含糊样本故意保留一个关键空缺,用于观察模型是否主动说明限制。
| 样本类型 | 示例输入 | 主要观察点 |
|---|---|---|
| 正常样本 | 信息完整的产品更新说明 | 内容、结构和语气是否达标 |
| 边界样本 | 要求 100 字内包含四项信息 | 是否遗漏要点或突破长度 |
| 含糊样本 | 未提供发布时间却要求写公告 | 是否编造日期或标记待确认 |
同一轮测试应固定模型、参数、样本和评分标准,只替换提示词版本。这样得到的差异才具有解释价值。
一次只改一个变量
先把当前可用提示词记为基线版本,再复制出候选版本。每个候选版本只改变一个变量,例如补充缺失信息处理规则、调整输出字段顺序或收紧长度范围。不要同时改角色、语气和格式,否则即使结果改善,也无法知道哪项修改有效。
下面的 YAML 用于记录一次测试。它不是模型配置文件,而是团队可以共同维护的测试记录格式。
testId: prompt-email-003
question: 缺少发布日期时是否停止编造
samples:
  - normal-complete
  - boundary-short
  - ambiguous-missing-date
baselineVersion: v1.2
candidateVersion: v1.3
changedVariable: 新增缺失事实处理规则
metrics:
  formatAccuracy: 0-2
  factualSafety: 0-2
  toneConsistency: 0-2
decisionRule: 候选版本总分更高且任一样本不低于基线
预期结果
完成测试后,记录应能直接说明候选版本为何晋级或回滚,而不是只写“感觉更好”。
正常样本:基线 6 分,候选 6 分
边界样本:基线 5 分,候选 5 分
含糊样本:基线 2 分,候选 6 分
结论:候选版本解决日期编造问题,其他样本未退化,晋级为新基线
记录结果并判断稳定性
评分时先隐藏版本名称,再按同一标准逐项打分,能够减少“新版本应该更好”的心理偏差。每个样本都要保留输入、输出、分数、失败原因和最终决定,不能只保存平均分。
平均分上升但边界样本明显退化时,不应直接晋级。更稳妥的规则是:候选版本总体不低于基线,关键指标必须提高,且任一高风险样本不得下降。对随机性较强的任务,可对同一样本重复运行三次,记录最低分和波动范围。
形成可重复的测试循环
一个完整循环包括定义问题、选样本、固定基线、创建单变量候选、并排评审、记录结果和决定晋级。版本晋级后要更新基线编号,并保留回滚所需的旧版本与测试记录。
测试集也需要维护。真实使用中出现的新失败案例,应先加入测试集,再修改提示词;这样可以证明修复确实覆盖了问题,同时避免旧能力在下一次优化中被意外破坏。
本课总结
- 提示词测试必须先定义可观察问题,再选择正常、边界和含糊样本。
- 候选版本一次只修改一个变量,并在固定条件下与基线并排比较。
- 版本晋级不仅看平均分,还要检查关键指标、最差样本和结果波动。
下一课预告
下一阶段将把模板设计与测试记录结合起来,形成可维护的提示词资产,并继续学习如何针对具体写作任务扩展字段、版本和验收规则。