
AI 内容创作 / 系统课时
补充背景信息
补充背景信息
背景信息决定模型依据什么事实写、哪些结论已经确定,以及哪些素材可以引用。高质量提示词不会把所有资料无差别堆入上下文,而会筛选与任务直接相关的信息,标明来源、时效、优先级和冲突处理规则。
学习目标
- 识别完成写作任务所需的上下文、事实、素材来源和前置结论。
- 掌握背景信息的筛选、分组、排序和冲突标注方法。
- 能编写既充分又不过载的背景输入,减少模型猜测和事实漂移。
背景信息为何决定结果
角色设定告诉模型“如何判断”,背景信息则告诉模型“依据什么判断”。缺少背景时,模型只能依赖通用知识补全空白;背景混乱时,模型又可能把过期信息、推测和正式结论混在一起。写作任务越具体,越需要明确事实边界。
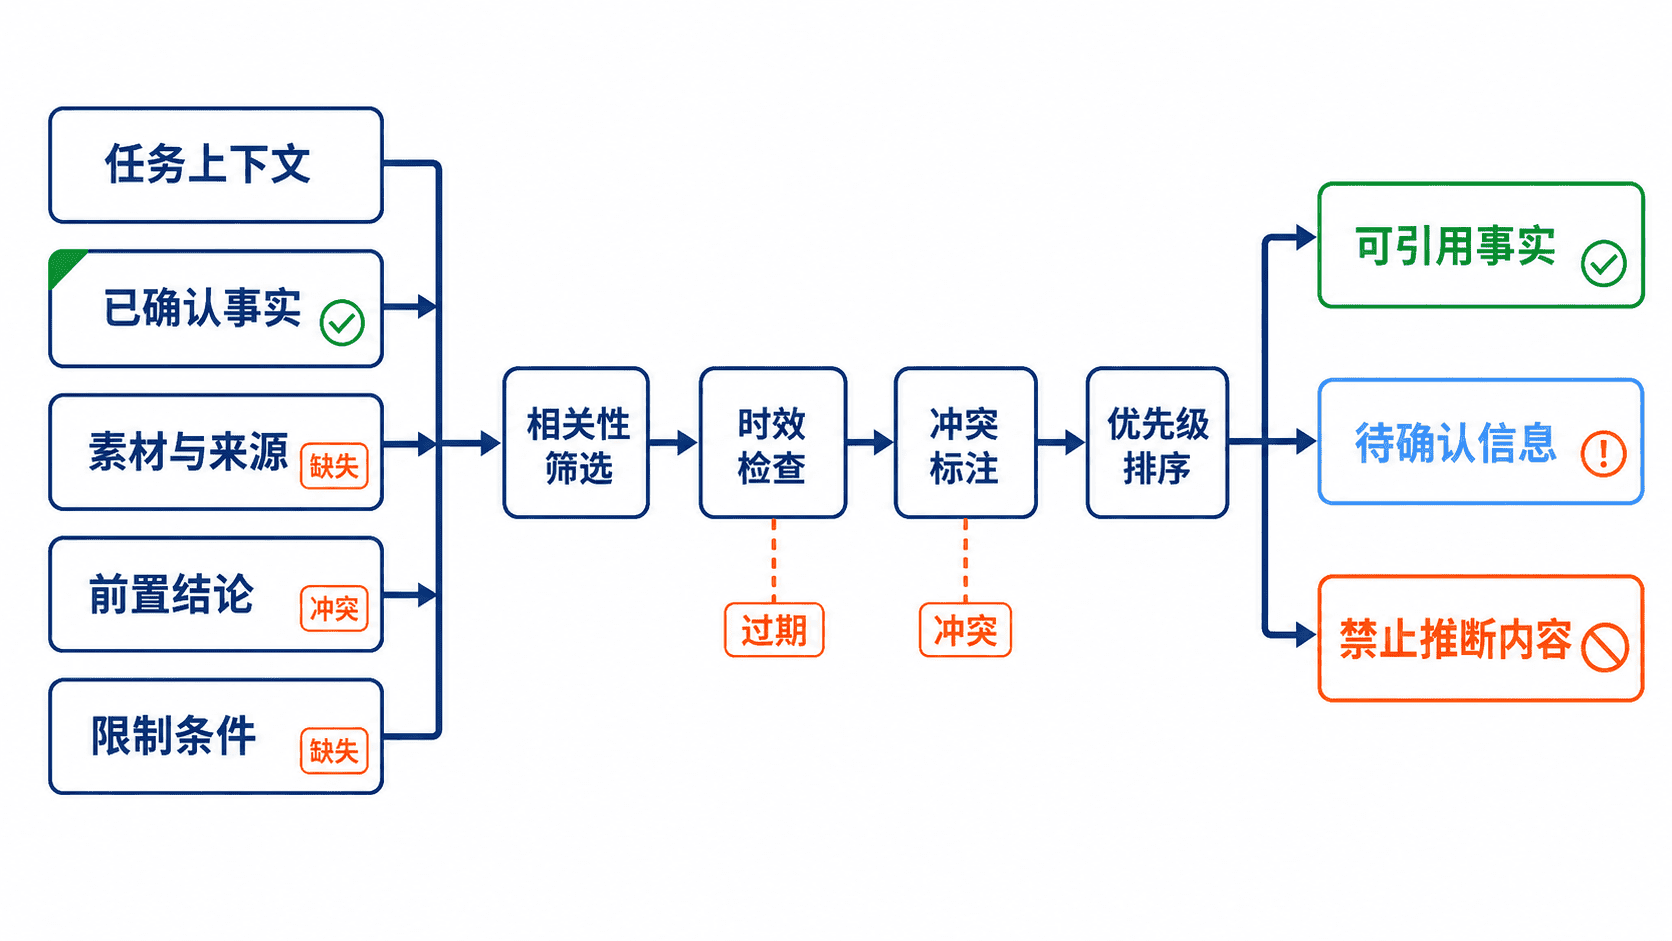
背景信息不是篇幅越长越好。它的目标是让模型区分“已经确认”“可作为参考”“尚待确认”和“禁止推断”四种状态,从而把注意力集中在真正影响交付物的材料上。
四类核心信息
| 信息类型 | 主要内容 | 写入方式 |
|---|---|---|
| 任务上下文 | 发布位置、读者状态、使用情境、已有流程 | 用两到四句话说明任务发生在哪里 |
| 已确认事实 | 数据、产品能力、时间、人物关系、既定规则 | 单独列出,并避免混入推测 |
| 素材与来源 | 访谈、文档、表格、研究结果、原始文案 | 标明名称、日期和可引用范围 |
| 前置结论 | 已批准的定位、主张、方案、禁用表达 | 明确写成不可随意改变的约束 |
限制条件也应放入背景区域,例如字数、发布日期、保密范围或必须保留的术语。它们虽然不是事实本身,却直接决定模型能否正确使用事实。
筛选与排序方法
先判断每条信息是否会改变内容选择、论证、语气或行动指令。不会影响结果的资料应删除,避免模型把注意力分散到无关细节。保留的信息再按“必须遵守、重要参考、补充材料”三个层级排序。
同一主题出现冲突时,不要让模型自行选择。应指出冲突项、指定优先来源,并说明未解决前如何处理。例如,新版产品说明与旧版帮助文档不一致时,可以规定“以 2026 年 8 月发布说明为准,旧文档仅用于理解术语”。
来源不确定的信息必须显式标注。把“用户似乎更喜欢简短内容”改成“内部访谈记录显示,6 名受访者中有 4 名希望首屏内容更短”,模型才能区分观察、推测和证据。
完整提示词示例
下面的背景模块用于编写一次产品功能更新公告。信息按状态分组,模型可以直接判断哪些内容可写、哪些内容不能推断。
任务上下文:
- 发布位置:产品内更新中心。
- 目标读者:已经使用过批量导入功能的管理员。
- 发布目的:说明新校验机制,并引导管理员在下次导入前检查文件。

已确认事实:
- 新机制将在 2026 年 8 月 12 日启用。
- 系统会检查必填字段、重复编号和无效日期。
- 检查失败时不会写入任何新记录。
- 管理员可以下载错误报告。

素材与来源:
- 《批量导入校验规则 v2》,更新日期为 2026 年 8 月 1 日,作为功能事实的唯一来源。
- 客服工单汇总,只用于说明常见问题,不用于推断功能能力。

前置结论:
- 公告必须先说明启用日期,再说明用户需要采取的动作。
- 不使用“零错误”“完全避免失败”等绝对化表达。

待确认信息:
- 错误报告的文件格式尚未确认,因此不得写具体扩展名。
基于这组背景,合格结果会保留启用日期、校验范围和失败行为,并把文件格式从正文中排除。下面是与输入一致的简短产出片段。
自 2026 年 8 月 12 日起,批量导入将在写入前检查必填字段、重复编号和无效日期。若检查未通过,本次导入不会写入新记录,管理员可下载错误报告定位问题。请在下次导入前确认文件中的必填信息完整且编号不重复。常见问题与检查清单
最常见的问题是把要求、事实和示例混在同一段中。模型可能把示例数字当成正式数据,或把建议当成已批准结论。应使用清晰的小标题或标签分组,并对每组写明用途。
背景材料过多时,可检查以下问题:
- 这条信息是否会改变正文内容或结构?
- 它是已确认事实、参考材料,还是尚待确认的推测?
- 是否提供了日期、版本或来源名称?
- 与其他材料冲突时,是否指定了优先级?
- 模型是否被明确禁止补全关键缺口?
如果五个问题中有任何一项无法回答,就应先整理背景,再开始生成正文。
本课总结
- 背景信息应区分任务上下文、已确认事实、素材来源和前置结论。
- 有效背景需要经过相关性筛选、时效检查、冲突标注和优先级排序。
- 对未确认信息明确标注“不得推断”,比增加大量模糊资料更可靠。
下一课预告
下一阶段将把角色设定与背景信息组合成完整提示词骨架,并继续补充任务指令、输出格式和验收标准,使提示词能够稳定复用。