
游戏美术与资产 / 系统课时
为什么面数下降了性能却没改善
为什么面数下降了性能却没改善
把模型从十万三角形减到三万,不代表帧率一定会上升。LOD 只是降低运行时成本的一种手段,真正瓶颈还可能在材质槽、绘制调用、着色器、纹理、透明过绘或蒙皮。本篇用“先测瓶颈,再减成本”的方法判断优化是否真的有效。
学习目标
- 能解释为什么三角形下降不一定带来可见性能提升
- 能把模型成本拆成几何、Draw Call、材质、纹理和着色器等部分
- 能设计一组前后可比的测试,确认 LOD 优化是否命中瓶颈
三角形只是 GPU 成本的一部分
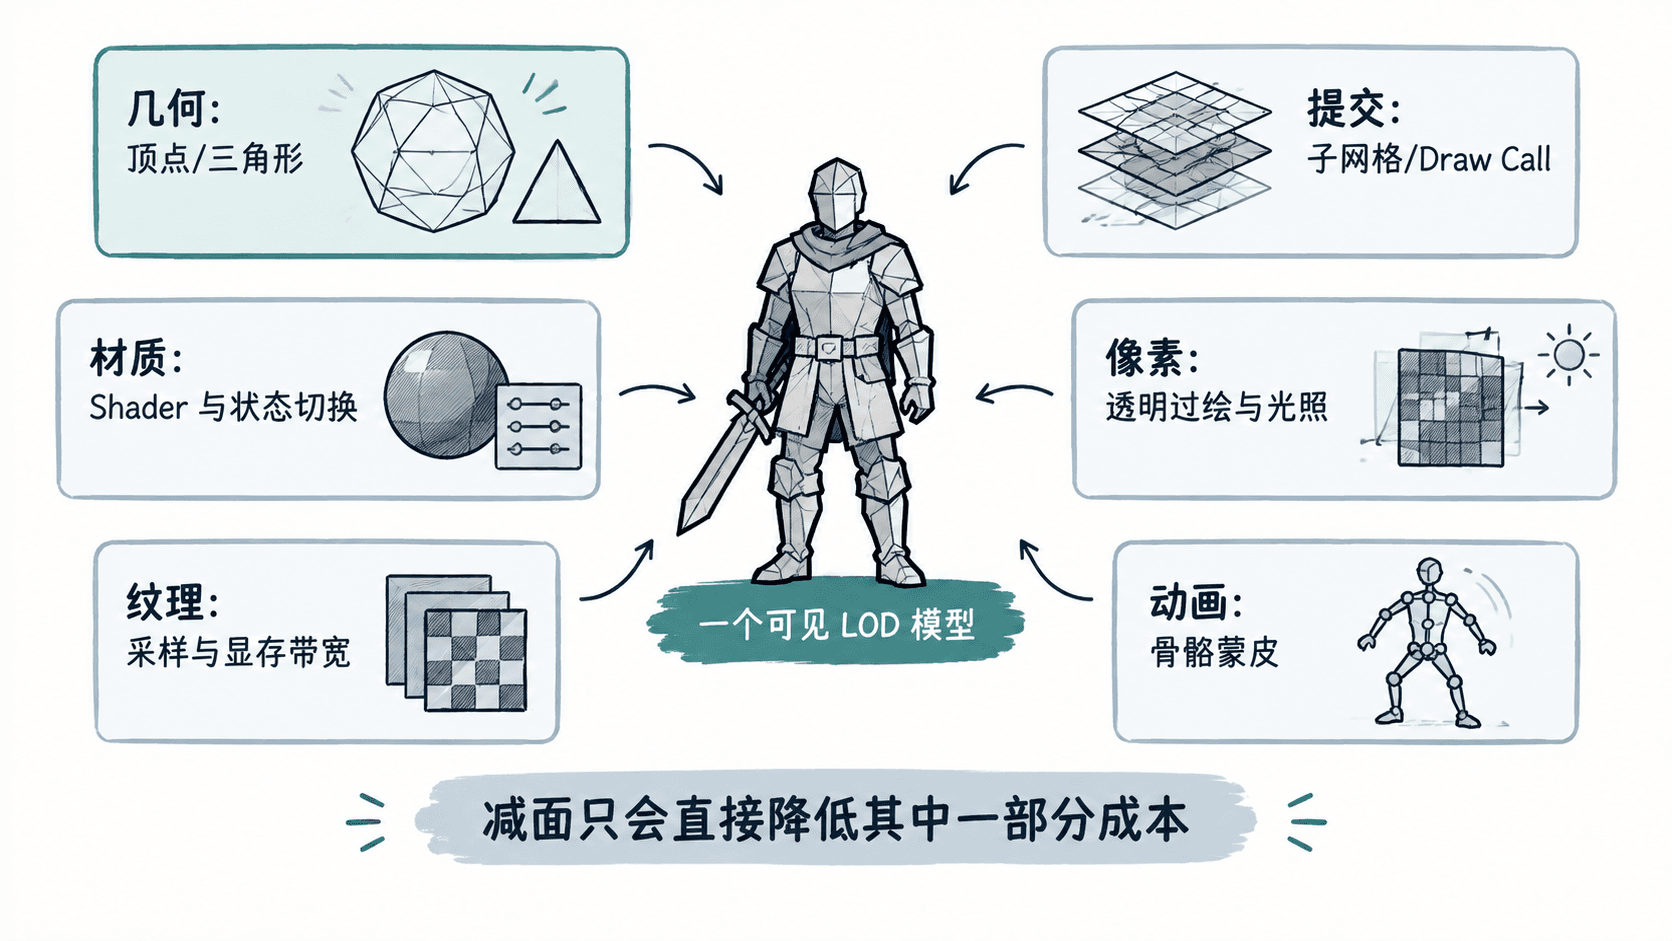
三角形数量主要影响顶点处理、光栅化前后的几何工作量,但一帧画面还要处理材质切换、像素着色、纹理采样、透明混合、阴影、骨骼变形和 CPU 提交。只降低面数,其他成本不变时,总帧时间可能几乎不动。
例如一个模型有 6 个材质槽,即使把三角形减少 70%,引擎仍可能需要按多个子网格提交多次绘制。若画面真正受 Draw Call 或复杂像素着色器限制,几何优化就不会成为主要收益来源。
先确认瓶颈在哪一侧
优化前要先看帧时间,而不是只看 FPS。帧率会把变化压缩成一个整数感受,而 CPU Frame Time 和 GPU Frame Time 更容易判断当前受哪一侧限制。若 GPU 已经很轻而 CPU 提交很重,继续减三角形往往不会解决问题。
同样要保持测试条件一致:同一场景、同一相机、同一分辨率、相同可见对象数量和相同光照。不要拿“远处启用 LOD 后”的结果和“近处满屏模型”的结果直接比较,否则距离带来的像素覆盖变化会干扰判断。
Draw Call 和材质槽经常比面数更顽固
在许多引擎中,一个模型含多个材质槽时会被拆成多个子网格分别绘制。LOD1 如果只是把几何减半,却保留与 LOD0 相同的 5 个材质槽,CPU 提交和状态切换成本可能几乎没变。
远距离层级通常可以更激进地合并材质区域。例如把金属、塑料和橡胶在低 LOD 中合到一张纹理或一个材质实例里,减少子网格数量。这样做是否值得,要看项目的批处理策略、图集规则和美术管线,不能为了减少 Draw Call 随意破坏纹理清晰度或材质表现。
检查时把“每个 LOD 的三角形数”和“每个 LOD 的材质槽数量”并排记录。若三角形下降明显而材质槽完全不变,至少要意识到你只优化了几何这一条成本线。
像素和纹理成本可能完全盖过几何收益
大面积透明材质、复杂 PBR、昂贵的程序节点、实时阴影或高采样纹理会把瓶颈推到像素阶段。一个只有几千三角形的树冠,如果使用大量透明卡片并产生严重过绘,GPU 成本也可能高于一个更高面数的不透明硬表面模型。
低 LOD 可以考虑减少透明层叠、关闭远距离不必要的细节法线、降低着色器分支复杂度,或使用更适合远景的材质版本。纹理分辨率也应配合实际屏幕占用,不要让已经只占几十像素的远处对象仍然强制驻留最高分辨率资源。
但材质简化必须和视觉目标一起验证。错误的做法是为了“性能数字”让远景突然失去颜色、反射或阴影,结果虽然更快,却制造了新的 LOD 跳变。
用一组可比测试确认优化有没有命中
最有效的验证方法是一次只改一类变量。先保留材质和纹理不变,仅替换几何 LOD,观察 CPU/GPU 帧时间;再在同一几何下尝试合并材质槽或简化 Shader,比较第二组结果。这样才能知道收益来自哪里。
建议至少记录三组指标:每个 LOD 的三角形或顶点规模、材质槽或 Draw Call 数量,以及 CPU/GPU 帧时间。若项目有大量骨骼角色,再额外记录骨骼数和蒙皮开销;若是植被或特效资产,则重点关注透明过绘和阴影。
当面数已经明显下降、GPU 顶点阶段也变轻,但总帧时间仍不变,这并不说明 LOD“没有用”,而是说明当前瓶颈在别处。真正有效的优化不是把某个数字压到最低,而是让占比最高的运行时成本随 LOD 距离一起下降。