
游戏美术与资产 / 系统课时
用Blender Python批量生成LOD
用Blender Python批量生成LOD
手工为几十个模型逐一复制、减面、改名和保存,很容易漏掉某一级 LOD 或覆盖原对象。本节用 Blender Python 把这些重复操作收敛成一个可重复执行的脚本:源模型统一放入 SOURCE 集合,脚本生成 LOD0~LOD2,整理到独立集合并保存新的 .blend 文件。
学习目标
- 用
bpy遍历指定集合中的网格对象并安全复制数据。 - 为不同 LOD 设置减面比例,统一命名并避免修改源模型。
- 将生成结果集中保存到新的 Blender 文件,并通过控制台输出核对数量。
把批处理边界固定下来
批处理最怕“脚本不知道哪些对象是输入”。与其扫描整个场景并靠名称猜测,不如先约定一个 SOURCE 集合,只把需要生成 LOD 的原始网格放进去。脚本产生的对象进入 LOD_GENERATED 集合,这样重复执行时可以先清空旧结果,不会把上一轮生成物再次当成源模型。
LOD 比例也应该集中配置。下面示例使用 LOD0=100%、LOD1=50%、LOD2=25%。这些比例只是演示值,真正项目中应根据轮廓、屏幕占比和引擎切换距离重新验证,而不是把固定比例当成质量标准。
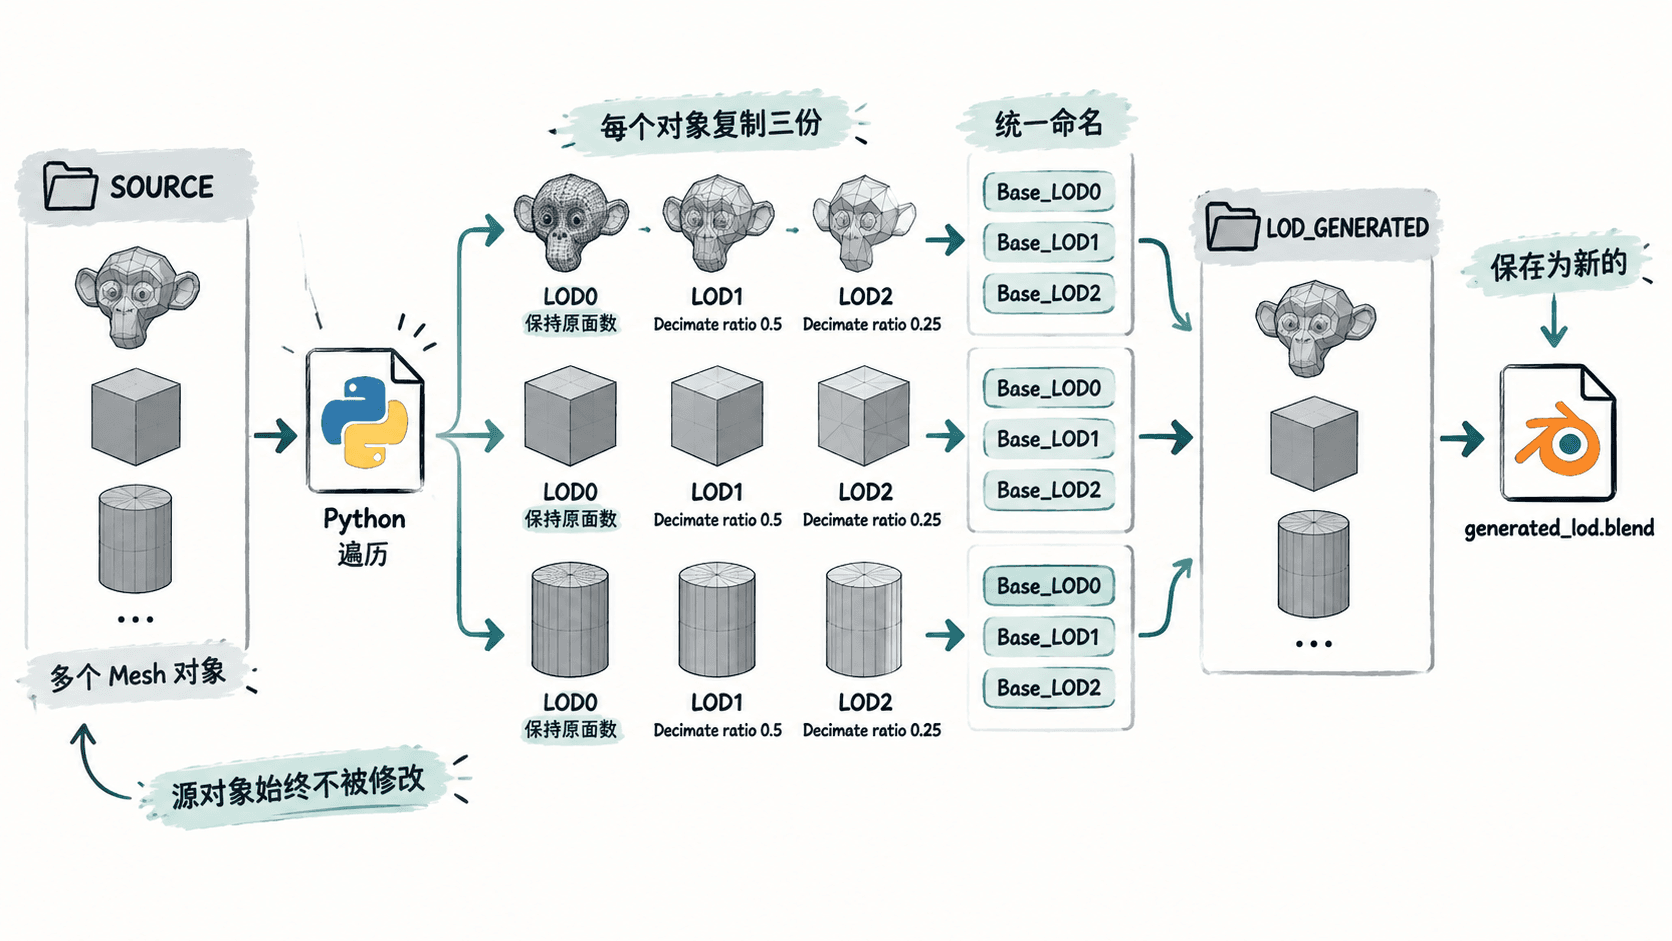
用脚本复制、减面并命名
下面脚本可直接在 Blender 的 Scripting 工作区运行。它要求场景中已经存在名为 SOURCE 的集合;每个源对象都会复制独立 Mesh 数据,因此对副本应用 Decimate 修改器不会影响原模型。
import bpy
from pathlib import Path

SOURCE_COLLECTION = "SOURCE"
OUTPUT_COLLECTION = "LOD_GENERATED"
LOD_RATIOS = {
    0: 1.0,
    1: 0.5,
    2: 0.25,
}

source = bpy.data.collections.get(SOURCE_COLLECTION)
if source is None:
    raise RuntimeError(f"Missing collection: {SOURCE_COLLECTION}")

generated = bpy.data.collections.get(OUTPUT_COLLECTION)
if generated is None:
    generated = bpy.data.collections.new(OUTPUT_COLLECTION)
    bpy.context.scene.collection.children.link(generated)
else:
    # 只清理上一轮生成物,避免改动 SOURCE 中的原始对象。
    for obj in list(generated.objects):
        bpy.data.objects.remove(obj, do_unlink=True)

source_objects = [obj for obj in source.objects if obj.type == "MESH"]

for src in source_objects:
    for level, ratio in LOD_RATIOS.items():
        dst = src.copy()
        dst.data = src.data.copy()
        dst.name = f"{src.name}_LOD{level}"
        generated.objects.link(dst)

        if ratio < 1.0:
            modifier = dst.modifiers.new(name="LOD_Decimate", type="DECIMATE")
            modifier.ratio = ratio

            bpy.ops.object.select_all(action="DESELECT")
            dst.select_set(True)
            bpy.context.view_layer.objects.active = dst
            bpy.ops.object.modifier_apply(modifier=modifier.name)

output_dir = Path(bpy.path.abspath("//exports/lod"))
output_dir.mkdir(parents=True, exist_ok=True)
output_file = output_dir / "generated_lod.blend"
bpy.ops.wm.save_as_mainfile(filepath=str(output_file))

print(f"SOURCE={len(source_objects)}, GENERATED={len(generated.objects)}")
print(f"SAVED={output_file}")
预期输出。假设 SOURCE 中有 2 个网格对象,文件系统中的实际路径会因工程位置不同而变化:
SOURCE=2, GENERATED=6
SAVED=<PATH>/exports/lod/generated_lod.blend
为什么先复制 Mesh 数据
Object.copy() 只复制对象本身,复制后的对象仍可能与源对象共享同一份 Mesh 数据。如果后续修改网格数据,源模型可能一起变化。示例紧接着执行 dst.data = src.data.copy(),让每个 LOD 拥有独立 Mesh,再应用 Decimate,这个顺序比“复制后直接减面”更安全。
Decimate 修改器通过操作符应用时依赖 Blender 当前上下文,所以脚本显式取消选择、选中目标副本并把它设为 Active Object。批处理脚本如果省略这些上下文准备,最常见的结果不是参数错误,而是 bpy.ops.object.modifier_apply 因上下文不满足而失败。
让脚本可以重复执行
批处理脚本不应只能成功一次。这里每次运行都会清空 LOD_GENERATED 中旧对象,再按 SOURCE 重新生成,因此修改源模型后可以直接重跑。保存位置使用 // 相对当前 .blend 文件展开,便于整个项目目录迁移。
当脚本稳定后,再把比例配置、命名规则和导出步骤做成项目参数即可。最重要的是先保证输入集合明确、源对象不被修改、结果可以重复生成,这三点决定了批量 LOD 是否真正可维护。