
游戏美术与资产 / 系统课时
批量导出前怎样避免文件混乱
批量导出前怎样避免文件混乱
LOD 做完以后,真正容易出问题的往往不是导出按钮,而是“哪个文件对应哪个资产、哪一级 LOD”。本节把导出前的整理过程固定为可检查的命名、目录和清单规则,并用一个 Blender Python 预检脚本在导出前发现缺级、重名和非法命名。
学习目标
- 为资产名、LOD 等级和导出目录建立一一对应的规则。
- 在批量导出前自动检查缺少 LOD0、重复等级和命名错误。
- 生成可追踪的清单文件,让后续导出、提交和回查有统一依据。
先固定命名与目录规则
一个稳妥的规则是让“对象名、文件名、目录名”共享同一个资产基名。例如 Rock_A_LOD0 与 Rock_A_LOD1 必须属于同一资产 Rock_A,导出时进入同一目录。不要在文件名里混入“final”“new”“fix2”这类无法机器判断的状态词。
| 对象名 | 资产基名 | LOD 等级 | 建议导出文件 |
|---|---|---|---|
Rock_A_LOD0 |
Rock_A |
0 | Rock_A/Rock_A_LOD0.fbx |
Rock_A_LOD1 |
Rock_A |
1 | Rock_A/Rock_A_LOD1.fbx |
Crate_LOD0 |
Crate |
0 | Crate/Crate_LOD0.fbx |
导出目录只承担组织职责,不表达“是否完成”。完成状态应交给版本控制、资产管理系统或清单字段记录,否则目录越维护越容易出现 final/final2/latest 这类无法自动化处理的分支。
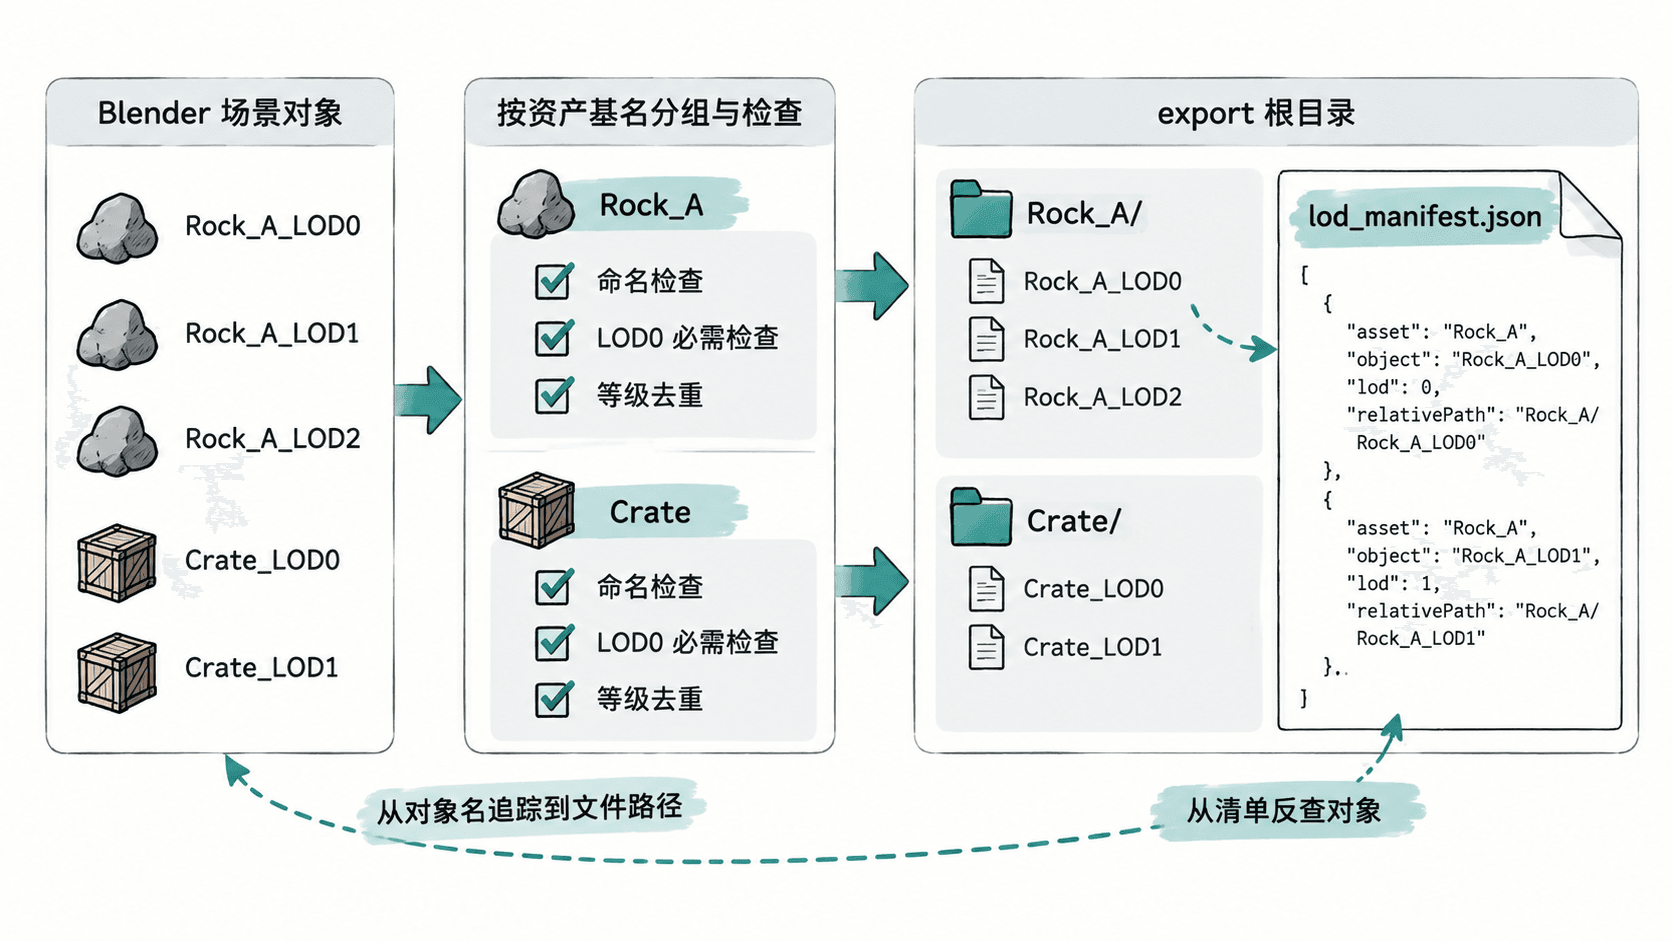
用预检脚本建立资产清单
下面脚本扫描当前场景中的 Mesh 对象,只接受 <资产名>_LOD<数字> 形式。它不会执行导出,而是在批量导出前生成 lod_manifest.json,并把不合规对象一次性列出来。这样可以先修正资产关系,再让真正的导出脚本消费清单。
import bpy
import json
import re
from pathlib import Path

NAME_PATTERN = re.compile(
    r"^(?P<base>[A-Za-z0-9][A-Za-z0-9_-]*)_LOD(?P<level>\d+)$"
)

groups = {}
errors = []

for obj in bpy.context.scene.objects:
    if obj.type != "MESH":
        continue

    match = NAME_PATTERN.fullmatch(obj.name)
    if not match:
        errors.append(f"invalid name: {obj.name}")
        continue

    base = match.group("base")
    level = int(match.group("level"))
    levels = groups.setdefault(base, {})

    if level in levels:
        errors.append(
            f"duplicate level: {base} LOD{level} -> "
            f"{levels[level]} / {obj.name}"
        )
    else:
        levels[level] = obj.name

for base, levels in groups.items():
    if 0 not in levels:
        errors.append(f"missing LOD0: {base}")

if errors:
    print("PRECHECK FAILED")
    for item in errors:
        print(item)
    raise RuntimeError("Fix asset naming before export")

export_root = Path(bpy.path.abspath("//exports/game"))
export_root.mkdir(parents=True, exist_ok=True)

manifest = []
for base in sorted(groups):
    for level in sorted(groups[base]):
        object_name = groups[base][level]
        relative_path = f"{base}/{object_name}.fbx"
        manifest.append({
            "asset": base,
            "object": object_name,
            "lod": level,
            "relativePath": relative_path,
        })

manifest_file = export_root / "lod_manifest.json"
manifest_file.write_text(
    json.dumps(manifest, indent=2, ensure_ascii=False),
    encoding="utf-8",
)

print(f"PRECHECK OK: assets={len(groups)}, entries={len(manifest)}")
print(f"MANIFEST={manifest_file}")
预期输出。假设场景包含 Rock_A_LOD0、Rock_A_LOD1、Crate_LOD0 三个合法网格对象:
PRECHECK OK: assets=2, entries=3
MANIFEST=<PATH>/exports/game/lod_manifest.json
生成的清单会把对象名与目标相对路径固定下来,例如:
[
  {
    "asset": "Crate",
    "object": "Crate_LOD0",
    "lod": 0,
    "relativePath": "Crate/Crate_LOD0.fbx"
  },
  {
    "asset": "Rock_A",
    "object": "Rock_A_LOD0",
    "lod": 0,
    "relativePath": "Rock_A/Rock_A_LOD0.fbx"
  },
  {
    "asset": "Rock_A",
    "object": "Rock_A_LOD1",
    "lod": 1,
    "relativePath": "Rock_A/Rock_A_LOD1.fbx"
  }
]
这里的 JSON 是数据结构示例,不要求有控制台输出。验证方法是打开生成的 lod_manifest.json,确认每个 Mesh 都有唯一 asset + lod 组合,且 relativePath 能唯一映射到计划导出的文件。
导出前按固定顺序做检查
先修命名,再导出,比“导出后整理文件”可靠得多。实际批处理前建议按以下顺序执行:
- 确认每个资产至少有一个 LOD0,并检查是否存在重复的 LOD 等级。
- 确认对象名与文件名使用同一资产基名,大小写和下划线规则保持一致。
- 运行预检脚本生成清单;只有出现
PRECHECK OK才进入导出步骤。 - 导出器按照清单逐项写文件,不再临时拼接另一套命名规则。
- 导出结束后对比“清单条数”和“实际文件数”,数量或路径不一致就判定本次批处理失败。
资产整理的核心不是把文件夹摆得整齐,而是让“场景对象、LOD 等级、导出文件”之间存在可验证的一一对应关系。只要这条关系能被脚本检查并写入清单,批量导出就不会再依赖人工记忆。