
Linux 与服务器运维 / 系统课时
构建部署与故障处置闭环
构建部署与故障处置闭环
本节把发布、健康验证、证据采集、自动回滚和审计记录串成一个可重复运行的 Shell 工具。最终脚本不只“把包发上去”,还会在失败时保留现场、恢复上一版本,并给出可追溯的执行结果。
学习目标
- 把发布、验证、回滚组织成单次执行的闭环流程。
- 在异常发生后先采集日志与运行状态,再执行恢复动作。
- 让每次发布都有统一的审计记录,便于排查与复盘。
先定义闭环边界
一个可靠的发布脚本至少要回答五个问题:发布什么版本、如何切换版本、怎样判断成功、失败时保留哪些证据、回滚到哪里。最简单且稳定的做法是采用“版本目录 + current 符号链接”:每次发布写入独立目录,验证通过后保留;验证失败则把 current 指回旧目录。
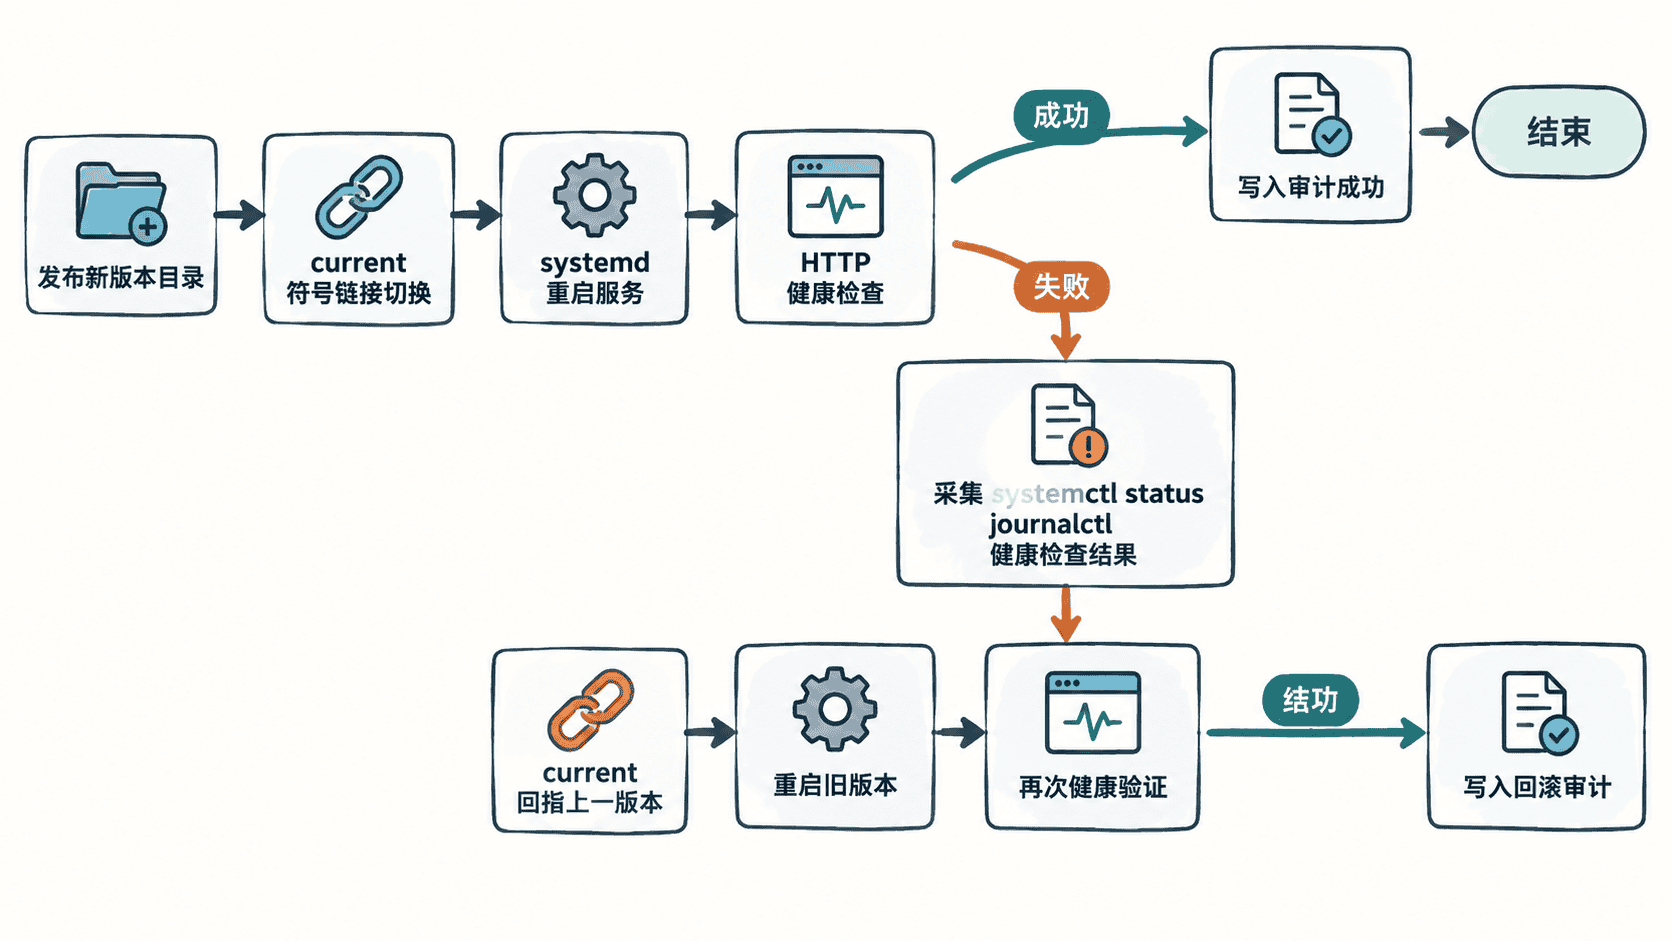
这里的关键顺序是:失败后先取证,再回滚。如果先重启或覆盖现场,最有价值的错误日志和进程状态可能已经消失,之后只能看到“回滚成功”,却不知道“发布为什么失败”。
实现可重复执行的发布脚本
下面脚本假设 Linux 使用 systemd 管理服务,服务单元已经从 /opt/demo/current/app.jar 启动应用。脚本接收一个制品路径,把它复制到新的发布目录,切换 current,重启服务并轮询健康接口;异常时自动采集证据并恢复上一版本。
#!/usr/bin/env bash
set -Eeuo pipefail

APP_NAME="demo-app"
BASE_DIR="/opt/demo"
RELEASE_DIR="${BASE_DIR}/releases"
CURRENT_LINK="${BASE_DIR}/current"
AUDIT_LOG="${BASE_DIR}/deploy-audit.log"
EVIDENCE_DIR="${BASE_DIR}/evidence"
HEALTH_URL="${HEALTH_URL:-http://127.0.0.1:8080/actuator/health}"
HEALTH_RETRY="${HEALTH_RETRY:-10}"
HEALTH_INTERVAL="${HEALTH_INTERVAL:-2}"

artifact="${1:-}"
if [[ -z "${artifact}" || ! -f "${artifact}" ]]; then
  echo "usage: $0 <artifact-file>" >&2
  exit 2
fi

release_id="$(date +%Y%m%d%H%M%S)"
new_release="${RELEASE_DIR}/${release_id}"
previous_release=""

mkdir -p "${RELEASE_DIR}" "${EVIDENCE_DIR}"

if [[ -L "${CURRENT_LINK}" ]]; then
  previous_release="$(readlink -f "${CURRENT_LINK}")"
fi

audit() {
  printf '%s\t%s\t%s\t%s\n' "$(date '+%F %T')" "${release_id}" "$1" "$2" >> "${AUDIT_LOG}"
}

health_ok() {
  local i
  for ((i = 1; i <= HEALTH_RETRY; i++)); do
    if curl -fsS --max-time 3 "${HEALTH_URL}" >/dev/null; then
      return 0
    fi
    sleep "${HEALTH_INTERVAL}"
  done
  return 1
}

collect_evidence() {
  local target="${EVIDENCE_DIR}/${release_id}"
  mkdir -p "${target}"

  # 先保存服务状态和最近日志,避免回滚动作覆盖故障现场。
  systemctl status "${APP_NAME}" --no-pager > "${target}/systemctl-status.txt" 2>&1 || true
  journalctl -u "${APP_NAME}" -n 200 --no-pager > "${target}/journal.log" 2>&1 || true
  curl -sS --max-time 3 -i "${HEALTH_URL}" > "${target}/health.txt" 2>&1 || true

  echo "${target}"
}

rollback() {
  if [[ -z "${previous_release}" || ! -d "${previous_release}" ]]; then
    audit "ROLLBACK_FAILED" "no previous release"
    echo "rollback unavailable: previous release not found" >&2
    return 1
  fi

  ln -sfn "${previous_release}" "${CURRENT_LINK}"
  systemctl restart "${APP_NAME}"

  if health_ok; then
    audit "ROLLED_BACK" "${previous_release}"
    echo "rollback success: ${previous_release}"
    return 0
  fi

  audit "ROLLBACK_FAILED" "${previous_release}"
  echo "rollback failed: service still unhealthy" >&2
  return 1
}

mkdir -p "${new_release}"
cp "${artifact}" "${new_release}/app.jar"
ln -sfn "${new_release}" "${CURRENT_LINK}"

audit "DEPLOYING" "${new_release}"
systemctl restart "${APP_NAME}"

if health_ok; then
  audit "SUCCESS" "${new_release}"
  echo "deploy success: ${new_release}"
  exit 0
fi

evidence_path="$(collect_evidence)"
audit "HEALTH_FAILED" "evidence=${evidence_path}"
echo "health check failed, evidence: ${evidence_path}" >&2

rollback
exit 1
预期结果
成功路径:脚本退出码为 0,current 指向新版本目录,deploy-audit.log 记录 DEPLOYING 和 SUCCESS。
失败路径:脚本先生成 evidence/<TIME>/ 下的状态、日志和健康检查证据,再恢复上一版本;即使回滚成功,本次发布仍以退出码 1 结束。
脚本把“发布失败”和“回滚是否成功”分开表达,这是自动化里很重要的语义。新版本失败后,即使旧版本恢复正常,本次发布任务仍然应该失败,否则 CI/CD 平台可能把一次异常发布误判成成功。
执行并核对审计结果
部署前先确认当前用户具有目标目录写权限,并能执行 systemctl restart demo-app。制品路径作为唯一位置参数传入,健康地址可以通过环境变量覆盖。
sudo env HEALTH_URL="http://127.0.0.1:8080/actuator/health" ./deploy.sh /tmp/demo-app.jar
sudo tail -n 3 /opt/demo/deploy-audit.log
预期输出
deploy success: /opt/demo/releases/<TIME>
<TIME>\t<TIME>\tDEPLOYING\t/opt/demo/releases/<TIME>
<TIME>\t<TIME>\tSUCCESS\t/opt/demo/releases/<TIME>
示例中的 <TIME> 代表实际生成的时间戳,不同执行时间会得到不同值。若健康检查失败,终端会显示证据目录,审计日志则出现 HEALTH_FAILED 和后续 ROLLED_BACK 或 ROLLBACK_FAILED。
验收失败路径而不只验成功路径
闭环脚本真正需要重点测试的是异常场景。至少验证健康接口不可达、服务启动失败、没有上一版本、回滚后仍不健康四种情况。每种场景都应检查三件事:脚本退出码是否正确、证据目录是否生成、审计日志是否完整记录最终状态。
当发布动作、健康验证、现场取证、恢复动作和审计结果都由同一次执行串起来后,脚本才从“部署命令集合”升级为可重复、可验证、可追责的运维闭环。